Meta × Panmnesia · Nature Reviews Electrical Engineering
NVLink와 스케일아웃 네트워크의 경계를 넘어: 원칩형 CXL 데이터센터
CXL 스케일업 패브릭은 서버 안의 NVLink와 서버 사이의 이더넷 또는 InfiniBand로 나뉜 AI 시스템에 하나의 주소 체계와 요청 처리 규칙을 적용합니다. CPU당 가속기 16개, 수백 ns급 원격 접근과 장치 단위 복구가 하나의 데이터센터 아키텍처로 이어집니다.
 오리지널 편집 일러스트
최신 분석
전체 아티클 →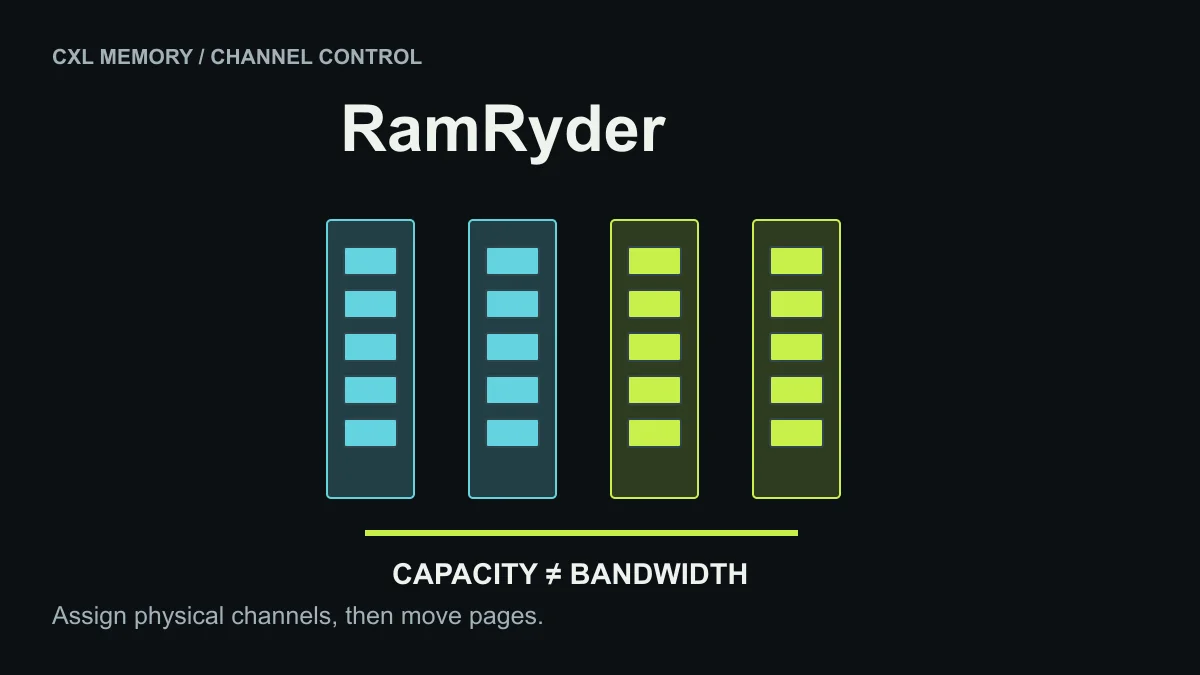
memory · 19 분
용량과 대역폭을 따로 요구하는 VM, 메모리 채널을 나눠 할당하는 RamRyder
RamRyder는 수정된 가상화 소프트웨어에 DRAM 채널을 드러내고, 기본 DIMM 자원의 격리와 CXL 자원의 탄력 할당을 구분합니다. 채널을 추가하는 것보다 페이지를 어디에 두는지가 중요합니다.
ai-infra · 18 분
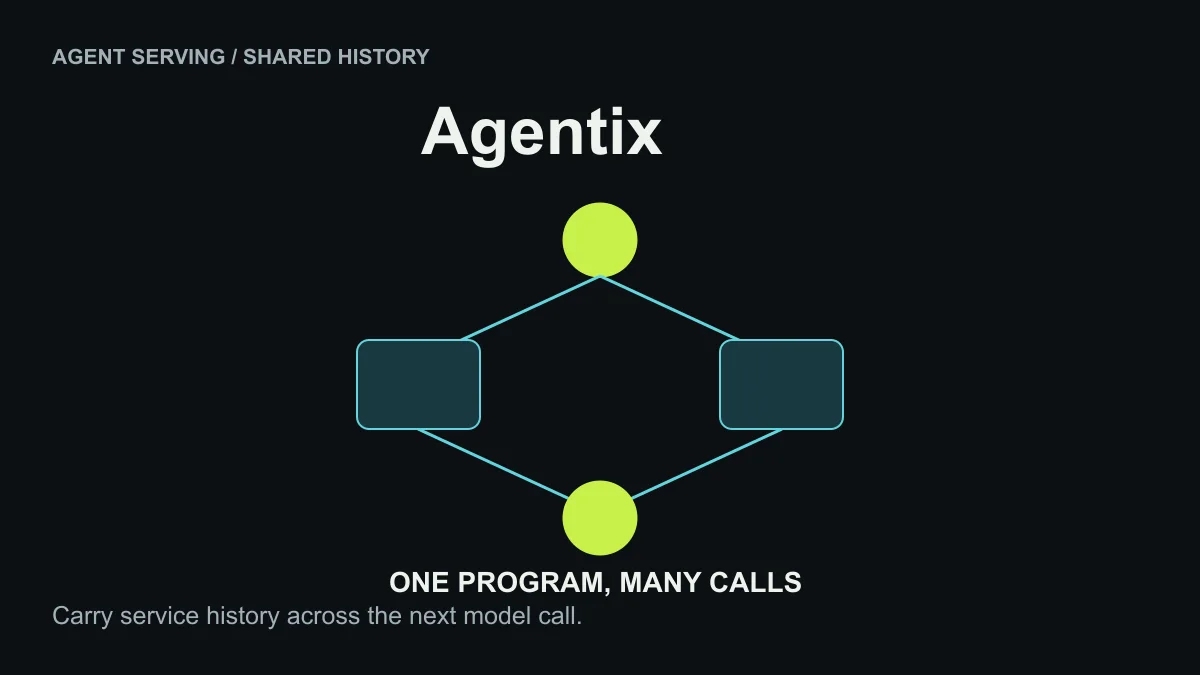
호출이 빨라도 늦게 끝나는 AI 에이전트, Agentix의 프로그램 단위 스케줄링
Agentix는 같은 에이전트 프로그램의 이전 실행 시간을 다음 LLM 호출의 우선순위에 반영합니다. 개별 호출의 속도보다 여러 호출이 누적시키는 대기 시간을 줄이는 설계입니다.
fabric · 19 분
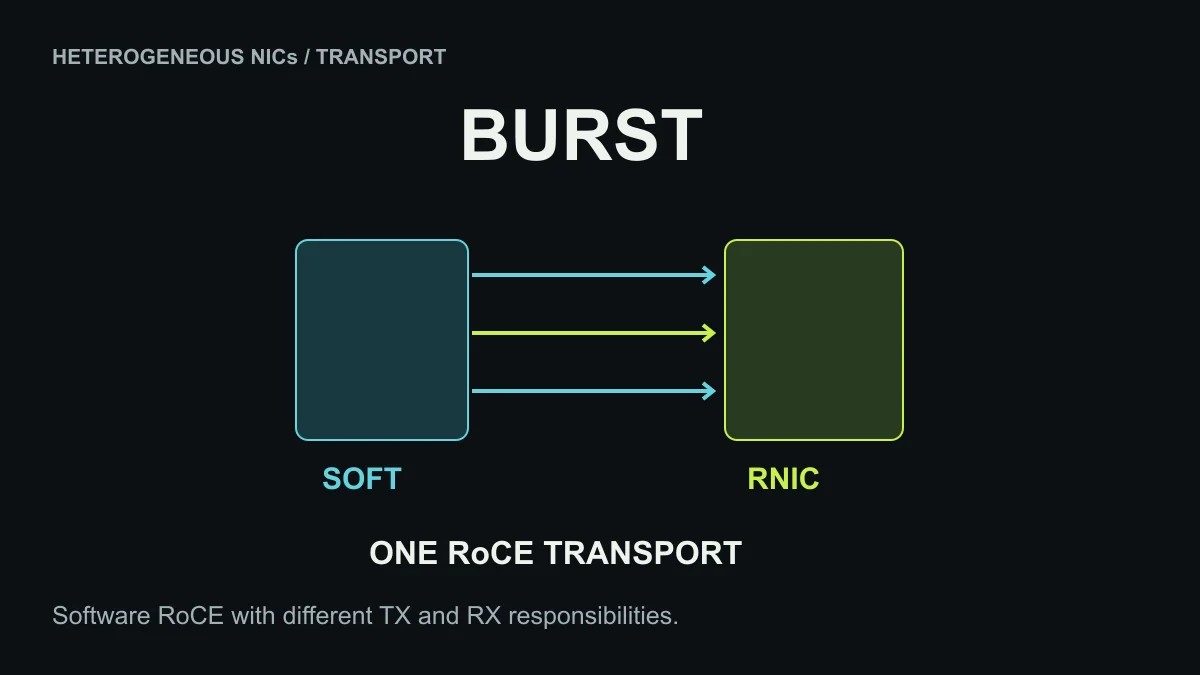
일반 이더넷 NIC와 RDMA 장비를 잇는 BURST, 전송 속도와 추론 지연의 차이
ByteDance와 후난대의 BURST는 일반 이더넷 장비에서도 RDMA 애플리케이션 인터페이스를 유지하도록 전송 기능을 소프트웨어로 구현합니다. 400G에 가까운 처리량과 실제 추론 지연의 개선 조건은 서로 다릅니다.
시스템 계층별로 보기
주제 전체 보기 →실리콘에서 AI 인프라까지.
반도체 · 아키텍처
가속기와 칩렛, 메모리 계층, 성능을 좌우하는 설계 선택을 살펴봅니다.
인터커넥트 · 시스템
CXL과 스케일업 패브릭, 여러 장치를 하나의 시스템으로 묶는 소프트웨어를 분석합니다.
AI 인프라
클러스터와 스토리지, 신뢰성, 냉각, 전력 문제를 데이터센터 규모에서 다룹니다.
더 많은 분석
08-31[news]메모리 컨트롤러를 HBM으로 옮기면 무엇이 달라지는가24m08-25[news]웨이퍼 세 장을 하나의 서비스 단위로 묶은 Cerebras CS-413m08-25[memory]LPDDR6와 SOCAMM2가 서버 메모리로 확장되는 이유18m08-25[arch]GPU 복제 대신 데이터 이동을 줄인 오픈AI 할라페뇨28m08-24[news]GPU 72개를 하나의 제품으로 만드는 AMD Helios13m08-24[news]한 코어에서 IBM Z와 Arm을 함께 실행하는 이유12m08-24[memory]데이터 경계가 움직이기 시작했습니다: 2026년 산업계 메모리·스토리지 논문 52편29m08-24[news]하나의 에이전트, 서로 다른 전력 범위: Intel의 세 가지 칩13m08-24[arch]Vera CPU의 설계 기준: 88개 코어에 1.2TB/s를 배분한 이유20m08-17[fabric]DPU 하나와 RNIC 여덟 개, Tencent의 베어메탈 AI 클라우드 네트워크15m08-06[fabric]플로 크기 분포만으로 설명할 수 없는 버스트22m08-03[memory]HBM 옆에 낸드를 쌓는다: HBF 첫 표준 규격 읽기18m07-26[arch]RTL 자동화의 핵심은 첫 코드 이후의 검증15m07-15[silicon]배열과 타이밍, 데이터 구조를 함께 설계한 2026년 회로17m07-13[ai-infra]데이터센터 전체가 런타임이 되었습니다: 산업계 논문 9편으로 읽는 AI 인프라29m07-13[snapshot]CPU를 할당받고도 쉬는 배치 분석의 네 공백15m07-13[ai-infra]GPU 15만 장이 있어도 쓸 수 없는 이유18m07-13[snapshot]평평한 프로파일에서 더 빠른 코드가 느려 보이는 이유13m07-13[snapshot]클라이언트가 원하는 노드에서 제공하는 선형화 읽기15m07-13[snapshot]훈련 일정을 학습한 엑사바이트 데이터 파이프라인22m07-13[snapshot]메모리 장치군 없이 로그·메트릭·추적을 합치는 DiTing14m07-13[snapshot]장기 VM이 남기는 배치 부채와 오프라인 상환15m07-13[snapshot]강화학습 작업 안으로 들어간 GPU 스케줄러13m07-13[snapshot]LLM 최적화를 생산 코드로 만드는 통제 루프13m07-13[ai-infra]조용히 틀린 GPU를 찾는 세 단계: 검출, 장비 격리, 연산 추적18m07-13[snapshot]10억 벡터 검색을 플래시로 되돌린 클러스터링15m07-13[snapshot]하드웨어 수명 단계에 따라 달라지는 랙 전력 예산15m07-13[snapshot]실행 코드를 생성하지 않는 iOS 명령어 분석15m07-13[snapshot]VMM 곁의 격리 VM으로 옮긴 실시간 관측15m07-13[snapshot]CPU와 메모리 가상화를 세계별로 나눈 보안 컨테이너15m07-13[snapshot]스마트폰 1,200만 대의 할당기를 검증하는 방법15m07-13[snapshot]공유 로그의 내구성과 순서를 분리한 LogDrive15m07-13[snapshot]캐시 문제를 뒤집는 데이터센터 메모리 회수15m07-13[snapshot]Android 프로세스를 가로지르는 사용자 상호작용 추적15m07-13[ai-infra]에이전트 워크플로 전체를 스케줄링하는 클라우드: Murakkab19m07-13[snapshot]뜨거운 페이지에 갇힌 차가운 객체의 재배치14m07-13[snapshot]장치군 유지보수를 감당하는 장애 영역 하나의 버퍼15m07-13[snapshot]분기 협상 대신 매분 청산하는 가속기 시장14m07-13[snapshot]모델을 손상한 GPU 스텝을 재실행하는 진단기15m07-13[snapshot]롤아웃 꼬리가 생기기 전에 학습하는 스케줄러15m07-13[snapshot]S3 모델을 사실상 명세로 만드는 체계적 검증14m07-13[memory]장문맥 추론의 병목: KV 캐시 용량이 아닌 도착 시간20m07-13[ai-infra]모든 요청을 기록하지 않고도 느린 한 요청을 설명하는 법18m07-13[ai-infra]같은 층 수로는 맞지 않는다: Qwen 1조 매개변수 학습의 파이프라인 재설계18m07-13[ai-infra]전체 재시작 없이 GPU 한 장을 교체하는 TrainMover18m07-13[ai-infra]롤아웃과 학습 사이의 빈 시간을 회수하는 Weave19m07-13[snapshot]커널 상수를 밀리초 제어점으로 바꾸는 방법13m06-27[silicon]서버가 이미 가진 보호 비트에 메모리 태그를 넣은 AmpereOne17m06-27[silicon]GPU식 캐시 대신 컴파일러로 데이터를 움직이는 자동차 AI 칩16m06-27[silicon]CXL은 왜 느린가: PCIe에서 물려받은 실리콘을 4nm로 다시 설계하다25m06-27[ai-infra]20년 뒤 날씨를 모르면 냉각 용량도 틀린다23m06-27[silicon]PHY를 없애는 가장 확실한 방법: DRAM 위에 연산 다이를 붙인 d-Matrix Raptor18m06-27[silicon]평상시에는 접근 횟수를 세고, 위험한 메모리 구역만 샘플링하는 Rowhammer 방어16m06-27[memory]Meta Vistara: 회수한 DDR4를 CXL 메모리 계층으로 재사용23m06-16[silicon]42 nm에서 위로 쌓은 로직, 삼성의 3단 나노시트 적층 FET14m06-01[arch]아키텍처의 가능성을 운영 증거로 바꾼 ISCA 2026 기업 소속 논문 43편31m05-23[ai-infra]150 MW 전력 한도에서 GPU 8만3천 장을 운영하는 법28m05-19[ai-infra]추론 연산량보다 먼저 메모리 용량 한계에 닿는 추론형 모델17m05-18[ai-infra]수백만 개 구성에서 SLO를 지키는 하나를 찾는 법19m05-04[ai-infra]부하를 고르게 나눠도 느려지는 스토리지, Alibaba의 버스트 제어와 I/O 스케줄링18m05-04[ai-infra]특화 모델이 같은 문맥을 다시 읽는 비용, DroidSpeak의 모델 간 KV 캐시 재사용17m05-04[ai-infra]GPU는 바쁜데 학습은 느릴 때, 실행 단계에서 원인을 찾는 EROICA13m05-04[memory]학습 데이터를 읽기 전의 병목, 디렉터리 조회를 서버로 옮긴 FalconFS19m05-04[ai-infra]추론은 지연시간을 지키고 미세조정은 빈 구간을 쓰는 FlexLLM14m05-04[fabric]10만 GPU 네트워크를 위한 컴파일러25m05-04[fabric]배포 전에 패브릭을 컴파일하는 Meta의 Matryoshka16m05-04[memory]거대한 스위치 없이 96대 서버를 묶는 CXL 메모리 풀14m05-04[fabric]DPU를 스위치 안으로 옮긴 Azure, SONiC DASH의 성능과 설치 조건20m05-02[arch]동일 프로그램 가정을 버린 SPEC CPU 202616m04-26[ai-infra]한 배치의 서로 다른 기한, 요청별 추측 트리를 만드는 AdaServe13m04-26[ai-infra]값은 그대로, PCIe 전송량만 줄이는 IBP 무손실 압축13m04-26[fabric]빠른 링크 하나만 쓰지 않는 집단 통신, 두 패브릭을 묶은 MPCCS12m04-22[ai-infra]TPU 한 세대에 네트워크 두 개: 학습과 추론을 나눈 이유22m03-24[news]IP 공급사를 넘어 랙까지, Arm AGI CPU가 바꾸는 범위12m03-24[memory]실물 CXL 메모리 박스를 SAP HANA에 연결해 확인한 배치 기준14m03-22[ai-infra]같은 H100, 다른 클라우드 성능20m03-22[arch]AI 시스템의 모든 계층을 스케줄링 문제로 바꾼 ASPLOS 2026 기업 소속 논문 44편29m02-24[memory]리전 다섯 곳으로 바꾼 Apple 오브젝트 스토리지의 비용 구조16m02-24[ai-infra]AI 스토리지가 작업 의도를 읽는 법: AITURBO의 그룹 I/O19m02-24[snapshot]바이트를 옮기기 전에 공간을 비우는 클라우드 GC15m02-24[memory]위치가 바뀐 문장과 재사용하기 어려운 KV 캐시20m02-24[memory]서버에 남은 SSD와 세 번 바뀐 제어 경로17m02-24[snapshot]컨테이너 시작 시간을 결정하는 메타데이터 경로15m02-24[snapshot]여러 임계값의 조합으로 설명하는 SSD 장애 경보14m02-24[snapshot]파일시스템 경계를 넘어야 하는 Linux 데이터 무결성16m02-24[snapshot]커밋 경로를 비켜 가는 데이터베이스 압축16m02-24[memory]모델 로딩의 병목을 줄인 페이지 캐시 정책19m02-24[snapshot]저장 계층의 체크섬을 다시 쓰는 파일 동기화15m02-24[memory]파일시스템의 밀도와 읽기를 함께 개선한 정렬 압축15m02-24[memory]카트리지 1,000개와 드라이브 4개: 테이프 클라우드가 기다리는 이유18m02-24[snapshot]Android 전 계층이 지켜야 하는 Zoned UFS 계약14m02-17[silicon]상용 AI EDA가 실제 테이프아웃한 범위27m02-17[fabric]400 µm 변조기로 단일 파장 212 Gb/s를 만든 CPO 송신기18m02-10[silicon]새 설계에도 적용되는 EDA 레시피 학습16m01-31[arch]규모가 숨은 비용을 드러낸 HPCA 2026 기업 소속 논문 28편23m01-30[fabric]UALink, NVLink, 이더넷: 스케일업 랙 인터커넥트 비교21m01-26[news]스케일업 안으로 들어온 Ethernet, Maia 200의 시스템 선택13m01-21[silicon]배치배선 자동화의 핵심, 여러 목표의 동시 조정14m
전체 아티클 →# 2025
12-29[ai-infra]커널 최적화에 탐색 트리와 기억을 붙인 Meta의 에이전트16m12-16[ai-infra]네오클라우드의 숫자는 무엇을 증명하는가22m12-08[silicon]48 nm 아래에서 회로가 된 CFET, TSMC의 링 오실레이터와 SRAM14m11-25[memory]네트워크 없는 KV 캐시: Alibaba가 실물 CXL 2.0 스위치 위에 LLM 서빙을 올리다21m11-20[arch]AI 아키텍처 탐색의 경계, 실행 가능한 설계16m11-19[silicon]막 응력으로 패키징 웨이퍼를 펴는 Evatec의 접근16m11-03[memory]계층 전체가 제품이 되었습니다: 2025년 산업계 메모리·스토리지 논문 34편22m10-23[fabric]하나의 RoCE 패브릭에 네 가지 거리, Meta의 10만 GPU 통신 스택16m10-17[arch]구현 세부가 시스템 제약이 된 MICRO 2025 기업 소속 논문 35편26m10-13[ai-infra]GPU 한 장에서 모델 일곱 개를 서빙한 Aegaeon18m10-13[ai-infra]GPU 9,600장의 장기 학습을 지킨 ByteRobust19m10-12[snapshot]MMU 없이 만드는 메모리 안전 임베디드 구획15m10-12[snapshot]직전 최적화 상태를 다음 자원 배정에 재사용하는 COpter14m10-12[snapshot]키·값·토큰·헤드를 다르게 압축하는 KV 캐시15m10-12[ai-infra]원격 HBM을 컴파일러가 관리하는 메모리 계층으로20m10-12[ai-infra]통신 장벽을 없앤 Mercury, 원격 HBM까지 컴파일하는 방법14m10-12[fabric]PCIe 스위치 없이 구성하는 장치 풀15m10-12[snapshot]출력 토큰 하나가 바꾸는 LLM 추론 엔진14m10-12[snapshot]애플리케이션 계약 대신 RDMA 장치를 동결하는 라이브 이동15m10-12[snapshot]SmartNIC 제어 작업이 데이터 평면 코어를 빌리는 방법15m09-28[fabric]공간과 파장을 함께 고르는 4×4 광 스위치16m09-10[silicon]100GHz 이후 RF 회로가 되는 레이저 패키지15m09-08[fabric]AI 클러스터 네트워크 운영의 세 계층: 작업, 경로, 혼잡19m09-08[fabric]GPU 51만 장을 연결하는 텐센트 Astral 패브릭22m09-08[fabric]장애 패킷이 실제로 지난 경로를 기록하는 ByteTracker19m09-08[silicon]정밀도를 구조 안으로 옮긴 2025년 산업계 회로16m09-08[fabric]스위치를 없앤 스케일업, 트랜시버 속으로 들어간 광 스위칭20m09-08[fabric]로컬 큐로 알 수 없는 원격 경로 혼잡18m09-08[fabric]학습 작업이 알려 주는 중요 네트워크 경로19m08-27[ai-infra]호스트·PCIe·패브릭을 함께 바꾼 Alibaba Stellar17m08-27[silicon]첨단 패키지의 형상을 결정하는 연성 재료17m08-26[fabric]빛으로 랙을 건너는 UCIe, Ayar Labs의 8.192 Tb/s 광 리타이머16m08-26[fabric]실리콘 안으로 들어온 광 I/O, Celestial AI의 포토닉 패브릭 모듈15m08-26[fabric]4,000 mm² 광 백플레인, Lightmatter Passage M1000의 구조와 한계16m08-06[arch]하드웨어와 소프트웨어의 경계를 다시 정한 ASPLOS 2025 기업 소속 논문 59편35m08-06[fabric]빠른 큐를 넘어선 RNIC 자원 스케줄링16m08-04[ai-infra]수천 개 GPU가 스토리지를 기다릴 때, MLPerf 스토리지 2.0 읽는 법18m07-07[snapshot]라이브와 협업 방송을 잇는 하나의 송출 경로22m07-07[ai-infra]모델 적재가 끝나기 전부터 GPU를 활용하는 BlitzScale20m07-07[snapshot]하나의 순서 스트림을 수천 독자에게 전달하는 구조17m07-07[snapshot]프로토콜 구조까지 바꾸는 마이크로초 장애 검출18m07-07[snapshot]부동소수점 출력으로 복원하는 누산 트리21m07-07[ai-infra]멈추지 않은 GPU 하나가 대규모 학습을 늦출 때20m07-07[ai-infra]GPU 커널 내부의 대기 원인을 찾는 KPerfIR18m07-07[snapshot]전체 가상머신 대신 커널 실행만 기록·재실행하는 범위26m07-07[snapshot]사용자가 멈췄을 때 화질에 대역폭을 쓰는 제어14m07-07[ai-infra]PCIe GPU 서버에서 효과가 커지는 탄력적 텐서14m07-07[snapshot]NIC 수신 링의 두 역할을 나눈 버퍼 공유22m07-07[memory]읽기 분산과 장애 복구 구성을 분리한 Okapi 스토리지21m07-07[snapshot]페이징 정책은 밖으로, 페이지 폴트 경로는 커널 안으로17m07-07[snapshot]천만 CPU 코어를 하나의 학습 계약으로 묶는 시스템19m07-07[snapshot]LLM이 옮기고 제약 풀이기가 오류를 고치는 텐서 컴파일러25m07-07[snapshot]1ms보다 빠른 프로세스 복제만으로 함수가 빨라지지 않는 이유27m07-07[ai-infra]추론이 오면 5ms 안에 메모리를 돌려 주는 SIRIUS16m07-07[snapshot]캐시를 다시 만들지 않고 2초 신선도 보장26m07-07[ai-infra]요청이 올 때만 GPU를 쓰는 서버리스 추론19m07-07[ai-infra]GPU처럼 다루면 느려지는 백만 코어, 웨이퍼 메쉬에 맞춘 WaferLLM15m07-07[snapshot]같은 토큰 수가 다른 GPU 작업량을 만드는 장문맥 학습25m07-07[arch]GPU부터 FPGA까지, 하나의 스케줄러로 선점하는 법19m06-22[silicon]AI 칩 설계가 물리 설계에서 먼저 성과를 낸 이유16m06-21[arch]실제 서버 구매에 쓰인 CPU 벤치마크17m06-21[ai-infra]제한된 NVLink에서 학습한 DeepSeek V3의 하드웨어 요구20m06-21[ai-infra]Llama 3 학습에 네 가지 병렬화가 동시에 필요했던 이유16m06-21[silicon]Meta MTIA 2i: HBM 없이 총소유비용 44% 절감18m06-20[arch]아키텍처가 실제 서비스에 들어간 과정, ISCA 2025 기업 소속 논문 43편28m05-28[fabric]리플로와 신뢰성 시험을 통과한 Intel의 EMIB 광 패키지17m05-27[silicon]유기 기판 안으로 방열판을 옮긴 IBM의 패키징 실험16m05-14[fabric]장치 대신 버퍼를 풀링하면 PCIe 스위치를 줄일 수 있는가14m05-12[ai-infra]긴 문맥에서 비는 마지막 GPU 웨이브, LeanAttention의 디코드 재배치15m05-01[memory]데이터 80%를 CXL에 두고 처리량 85%를 지키는 데이터베이스 배치법13m04-28[ai-infra]GPU 구성이 달라져도 다시 읽는 체크포인트, 논리 텐서를 저장하는 ByteCheckpoint14m04-28[memory]메모리 노드의 CPU를 없앤 RDMA 원격 페이징16m04-10[ai-infra]세계 전력 3%보다 중요한 숫자, AI 데이터센터가 몰리는 곳18m03-30[ai-infra]학습이 보낸 그래디언트로 체크포인트를 갱신하는 FlowCheck14m03-30[ai-infra]위에는 컨트롤러 하나, 아래에는 여럿: verl의 설계도 HybridFlow19m03-30[arch]프리필의 연산과 디코드의 대역폭을 같은 SM에 채우는 POD-Attention13m03-30[ai-infra]가상머신 안에서도 GPU 통신 경로를 짧게 유지한 Vela의 1,500 GPU 운영14m03-01[ai-infra]집합 통신으로 학습 클러스터의 장애까지 진단하다17m03-01[arch]측정 결과를 운영 정책으로 연결한 HPCA 2025 기업 소속 논문 40편28m03-01[ai-infra]GPU 학습 장애를 대형 작업만으로 설명할 수 없는 이유17m03-01[ai-infra]마이크로와트에서 메가와트까지 통하는 AI 전력 측정법17m02-25[snapshot]파일시스템 프로세스가 멈춰도 애플리케이션 상태를 잃지 않는 복구28m02-25[snapshot]애플리케이션이 커밋하지 않은 디스크 상태를 거부하는 TEE 저장장치28m02-25[snapshot]저장 아카이브 대신 시작 메모리 이미지를 전송하는 컨테이너23m02-25[ai-infra]DRAM과 SSD로 KV 캐시를 확장한 Mooncake18m02-17[silicon]600 mm² 메인프레임 칩 안에 시스템을 넣은 IBM Telum II16m02-16[memory]HBM 데이터 그룹 앞에서 4상 클록을 다시 만드는 이유26m01-30[fabric]GPU 배치에 맞춰 광 토폴로지를 바꾸는 랙15m01-23[fabric]레이저 전력까지 포함한 224 Gb/s CPO 링크 공동 최적화17m# 2024
12-11[silicon]AI 배치 기술이 실제 실리콘에 들어가기까지25m09-09[silicon]2024년 산업계 회로 논문이 실리콘으로 증명한 것15m08-06[memory]부품이 아니라 배치 문제였습니다: 2024년 산업계 메모리·스토리지 논문 35편23m06-29[silicon]가속기 패키지를 하나의 컴퓨팅 노드로 만든 MI300A16m06-29[silicon]고정 행렬을 버리고 텐서 모양에 맞춰 나뉘는 가속기16m04-16[fabric]더 긴 버스가 아닌 패브릭으로서의 라우터블 PCIe13m04-14[fabric]첫 홉 전 지연으로 줄이는 필요 대역폭24m# 2023
03-24[arch]느린 PCIe 경계를 활용한 SmartNIC 키·값 저장소15m02-07[fabric]하이퍼스케일 RoCE에 누적된 프로토콜 비용16m