분산 학습은 다음 모델 상태를 결정하는 그래디언트를 통신한 뒤, 일반적인 체크포인트에서 같은 상태를 다시 복사합니다. 두 번째 이동은 연산을 멈추거나 GPU와 호스트, 네트워크와 스토리지 자원을 다툽니다. FlowCheck는 올리듀스 스트림에 별도의 상태 사본을 갱신할 정보가 이미 들어 있다는 점을 이용합니다. 스위치가 이 스트림을 CPU 노드로 복제하면 학습 프로세스에서 체크포인트 덤프를 떼어낼 수 있습니다.
GPU 작업자는 기존 집단 통신과 옵티마이저 경로를 그대로 실행합니다. 스위치는 선택한 패킷을 체크포인트 노드로 복제하고, 이 노드는 완전한 그래디언트 업데이트를 식별해 손실을 복구한 뒤 저장된 상태에 적용합니다. 학습 네트워크는 복제본을 기다리지 않으므로 체크포인트 작업이 별도로 진행됩니다.
업데이트 스트림에서 만든 복구 상태
체크포인트 노드가 알려진 학습 단계의 모델과 옵티마이저 상태를 갖고 있다고 가정해 보겠습니다. 다음 단계에서 분산 작업자는 그래디언트를 만들고 올리듀스로 교환합니다. 복구 계층이 완전히 리듀스된 그래디언트를 올바른 순서로 관찰하고 옵티마이저 동작을 알고 있다면 GPU 메모리의 모든 매개변수를 다시 읽지 않고도 상태 사본을 같은 단계까지 갱신할 수 있습니다.
개념은 상태 머신 복제와 닮았지만 입력은 작은 트랜잭션 로그가 아니라 고속 수치 트래픽입니다. 패킷은 나뉘고 순서가 바뀌거나 중복·손실될 수 있습니다. 여러 데이터 병렬 링이 동시에 동작하고 텐서·파이프라인·전문가 병렬 통신이 같은 네트워크를 공유합니다. FlowCheck는 한 체크포인트에 필요한 그래디언트 바이트를 다른 트래픽에서 구분해야 합니다.
시스템은 패킷 수를 기반으로 해당 플로와 완전성을 확인합니다. 미러 링크는 원래의 신뢰성 전송처럼 재전송을 요청하지 못하므로 중복 정보를 이용한 복구도 수행합니다. 공개 구현은 DPDK로 트래픽을 받고 Intel I/OAT를 사용하며, CPU와 큰 메모리로 데이터를 이동하고 재구성합니다.
신뢰성 로그가 아닌 미러 트래픽
포트 미러링은 송신자가 두 번째 복사를 만들지 않아도 된다는 장점이 있습니다. 대신 원래 전송보다 보장이 약합니다. 모니터 포트나 체크포인트 노드가 혼잡하면 학습에는 영향을 주지 않은 채 복제 패킷만 사라질 수 있습니다. 송신자는 복제본 손실을 알지 못하고 재전송하지 않습니다.
FlowCheck는 집단 통신에서 자연스럽게 나타나는 중복 관측을 이용해 빠진 정보를 재구성합니다. 가능한 방법은 올리듀스 알고리즘과 데이터 병렬 토폴로지에 따라 달라집니다. 예상 패킷 수로 업데이트가 완전한지 확인하고, 중복 경로나 사본으로 손실 구간을 복구합니다. 완전성을 증명하지 못하면 부분 업데이트를 유효한 상태로 표시하지 않고 이전 체크포인트를 유지해야 합니다.
운영에서는 학습 성공과 체크포인트 성공을 따로 봐야 합니다. 학습은 계속 진행하는데 최신 복구 시점이 뒤처질 수 있습니다. 대시보드에는 현재 학습 단계와 검증된 체크포인트 단계, 차이가 생긴 이유가 함께 나와야 합니다. 복구 지연을 감춘 채 학습 오버헤드만 0이라고 표시하면 새 장애 형태를 놓칩니다.
그래디언트에 들어 있지 않은 상태
그래디언트로 갱신할 수 있는 것은 이전 체크포인트에서 결정론적으로 계산할 수 있는 상태입니다. 복구 노드는 옵티마이저 알고리즘과 현재 상태를 알아야 합니다. 학습률 스케줄, 손실 스케일링, 난수 생성기, 데이터 로더 위치와 응용 메타데이터는 올리듀스 패킷에 없을 수 있습니다. 이 값은 별도 채널이나 주기적인 일반 체크포인트로 가져와야 합니다.
혼합 정밀도와 옵티마이저 분할도 조건을 늘리며, 리듀스된 그래디언트는 클리핑이나 스케일링 전의 로컬 표현과 다를 수 있습니다. ZeRO 계열 옵티마이저 상태는 모델 매개변수와 다른 방식으로 나뉩니다. 복구 사본은 같은 변환을 같은 순서로 적용하거나 나중에 재현할 정보를 저장해야 합니다.
따라서 정확한 주장은 범위가 분명합니다. FlowCheck는 네트워크 업데이트에서 재구성할 수 있는 대용량 상태의 학습 중단을 없앱니다. 모든 체크포인트 메타데이터가 패브릭에서 자동으로 나타나는 것은 아닙니다. 어떤 상태를 계속 복제하고 무엇을 별도로 저장하는지, 두 종류를 어느 일관된 시점에 묶는지 공개해야 합니다.
성능 근거와 복구 계층 용량
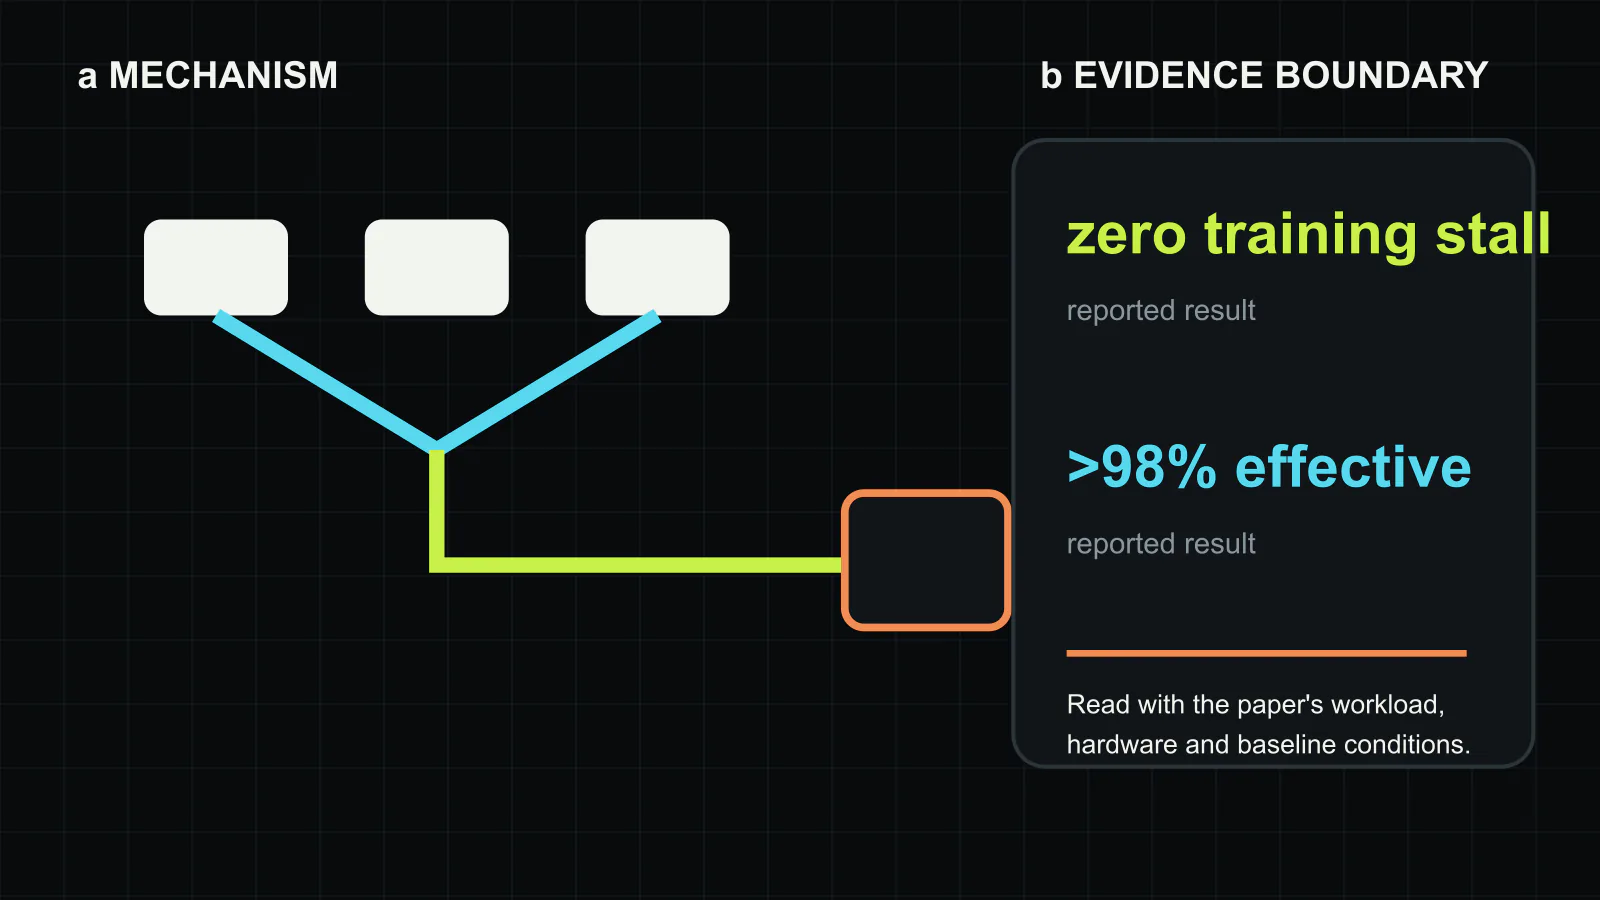
논문은 GPU 작업자가 체크포인트 데이터 경로를 실행하지 않으므로 시험한 설계에서 학습 성능에 영향을 주지 않았다고 보고합니다. 장애 빈도와 복구 가정을 포함한 평가에서는 유효 학습 시간이 98%를 넘습니다. 용량 분석 중 하나는 데이터 병렬 그룹이 반복마다 약 60 GB를 보내는 Llama2-7B 사례에서 약 400 Gbps까지 지원할 수 있다고 추정합니다.
세 숫자의 근거는 다릅니다. 학습 경로 오버헤드는 시제품 조건에서 측정했고, 유효 학습 시간은 실험과 장애·복구 가정을 함께 사용합니다. 400 Gbps는 상태 크기와 덤프 속도, 토폴로지와 체크포인트 노드 용량에 따른 계산입니다. 모든 환경에서 검증된 포트 처리량이 아닙니다.
체크포인트 노드는 큰 메모리를 필요로 합니다. 공개 구현은 작업 규모에 따라 달라지지만 최소 300 GB를 권장합니다. CPU 처리, 메모리 대역폭, DPDK 수신 대기열, I/OAT 지원, 스토리지 기록 속도와 미러 포트 용량이 새 병목이 됩니다. GPU 작업자와의 경쟁을 없앴지만 시스템 전체에서 바이트가 사라진 것은 아닙니다.
비동기 체크포인트와의 차이
여러 체크포인트 시스템은 상태를 호스트 메모리로 옮긴 뒤 학습을 먼저 재개하고 스토리지 쓰기를 이어갑니다. 사용자에게 보이는 중단은 줄지만 GPU 작업자에서 모델과 옵티마이저를 복사하는 과정은 남습니다. FlowCheck는 학습이 이미 보낸 트래픽을 관찰해 재구성 가능한 상태의 작업자 측 추출을 피합니다. 장치 복사나 작업자 CPU·메모리가 부족할 때 차이가 커집니다.
비동기 작성기는 학습 프로세스가 명시적으로 만든 스냅샷을 받으므로 소유권이 단순하지만, FlowCheck는 업데이트에서 스냅샷을 추론합니다. 간섭은 줄지만 스트림 식별과 손실 복구, 결정론적 재실행을 책임집니다. 한 방식이 모든 작업에서 우세하지 않습니다. 네트워크 업데이트를 자주 반영하고 드문 전체 체크포인트로 상태 차이와 보조 메타데이터를 다시 맞추는 혼합 방식도 가능합니다.
증분 체크포인트는 바뀐 값만 저장하지만 학습 프로세스가 변경분을 식별해 내보냅니다. FlowCheck는 변경분 수집을 네트워크 관측 계층으로 옮깁니다. 실제 선택은 운영자가 필요한 규모의 프로그래머블 미러링을 신뢰하고 관리할 수 있는지에 달려 있습니다.
네트워크와 보안 범위
올리듀스 미러링은 모델 업데이트를 학습 호스트 밖으로 노출합니다. 체크포인트 네트워크와 노드는 모델 스토리지와 같은 수준으로 보호해야 합니다. 사용자 격리, 암호화 또는 신뢰 네트워크, 접근 기록과 안전한 삭제가 필요합니다. 미러 설정이 잘못되면 다른 작업의 트래픽을 복제하거나 모니터 목적지를 과부하시킬 수 있습니다.
스위치 자원도 제한되며, 미러 세션과 필터, 모니터 포트 대역폭은 장애 분석과 보안 도구도 사용합니다. 토폴로지가 바뀌어도 모든 데이터 병렬 그룹을 관측해야 합니다. 여러 스위치를 지나는 경우에는 완전한 업데이트를 보면서 처리하기 어려운 중복은 만들지 않는 관측 지점을 골라야 합니다.
장애 영역은 독립적인 편이 좋습니다. 체크포인트 노드와 미러 네트워크, 학습 패브릭이 같은 스위치나 전력 영역에 있으면 한 사건이 연산과 복구를 함께 없앨 수 있습니다. 복제본이 다른 장애 영역에 도달하고 측정된 주기로 영속 스토리지에 기록될 때 구조의 가치가 커집니다.
복구 가능성으로 수행하는 인수 시험
첫 시험은 학습 처리량이 아니라 재시작 상태의 정확성입니다. 패킷 손실과 순서 변경, 미러 혼잡, 체크포인트 노드 재시작, 옵티마이저 변경과 스위치 장애를 주입한 뒤 예상한 상태로 복구되는지 확인합니다. 각 실험은 학습 단계, 최신 완전 복제 단계, 영속 저장 단계와 복구 결과를 함께 기록해야 합니다.
두 번째 시험은 지속 부하에서의 지연입니다. 작업자를 멈추지 않아도 복제본이 수백 단계 뒤처지면 짧게 멈추는 일반 체크포인트보다 더 많은 작업을 잃을 수 있습니다. 복구 시점 목표에는 복제와 스토리지 기록을 모두 포함하고, 대기열이 계속 늘기 전에 빈도를 줄이거나 노드를 추가해야 합니다.
마지막으로 프레임워크 체크포인트의 모든 객체를 목록으로 만들고 그래디언트 재실행, 별도 채널, 명시적 스냅샷 중 어디에서 얻는지 표시합니다. 출처를 알 수 없는 필드가 있으면 유효 복구 시점 공개를 막아야 합니다. 그래야 흥미로운 데이터 경로가 신뢰할 수 있는 체크포인트 방식으로 완성됩니다.
학습 경로 밖으로 옮긴 비용
FlowCheck는 대규모 학습이 이미 비용을 들여 전송하는 바이트를 한 번 더 사용합니다. 그래디언트 집단 통신을 복제하면 GPU 작업자에게 같은 대용량 텐서 덤프를 요구하지 않고 상태 사본을 갱신할 수 있습니다. 핵심 경로가 단순해지고 더 자주 복구 시점을 만들 가능성이 생깁니다.
비용은 네트워크 관측과 복제본의 정확성으로 이동합니다. 운영자는 미러 패킷 손실, 재구성 완전성, 보조 상태, 복제 지연과 장애 영역 독립성을 측정해야 합니다. 이 신호가 운영 지표로 드러나면 작업자 중단 0이 실제 유효 학습 시간으로 이어집니다. 신호가 숨으면 학습은 빠르게 진행해도 사용할 수 있는 복구 시점만 조용히 늙을 수 있습니다.
출처와 저작권 안내
이 글은 EuroSys 2025 논문[1]과 저자들의 공개 구현[2]을 우리 표현으로 다시 분석한 편집 다이제스트입니다. 논문의 문장·도판·표를 옮기지 않았으며, 본문 도판은 Silicon & Systems가 새로 제작했습니다. 측정 결과와 용량 추정치를 구분해 설명했습니다. 원 논문의 저작권은 저자에게 있고 출판권은 ACM(2025)에 허여됐습니다.