GPU 메모리가 가득 차지 않아도 데이터 이동이 병목이 될 수 있습니다. 그래프 특징값, 추천 모델의 임베딩, 키-값(KV) 캐시 전체가 장치 메모리보다 크면 호스트 메모리에 남겨 두고 배치에 필요한 텐서만 PCIe로 가져옵니다. 전송과 연산을 겹쳐도 현재 커널이 끝난 뒤 다음 텐서가 도착한다면 GPU는 기다리게 됩니다.
압축은 전송 대역폭을 늘린 것과 같은 효과를 내지만 일반적인 방식은 값을 바꿉니다. 양자화는 값당 비트 수를 줄이며 특정 모델에서 정확도 영향을 확인했다면 쓸 수 있습니다. 여러 모델을 함께 운영하거나 입력 분포가 변하고 수치 변경을 허용하지 않는 환경에서는 매번 정확도를 다시 검증해야 합니다. Invariant Bit Packing(IBP)은 값 묶음에서 항상 같은 비트 위치를 찾아 한 번만 기록함으로써 원래 비트열을 그대로 되살리면서 전송량을 줄입니다.[1]
두 고속 메모리 사이의 느린 경로
GPU의 HBM 대역폭과 연산 성능은 호스트에서 장치로 연결되는 경로보다 빠르게 늘었습니다. 필요할 때 데이터를 가져오는 작업에는 세 가지 한계가 생깁니다. GPU에 담을 수 있는 작업 집합의 크기, PCIe가 초당 전달하는 유효 데이터량, GPU가 값을 복원하는 시간이 각각 다릅니다. 캐시는 첫 번째 한계를 완화하고 미리 읽기는 두 번째 한계의 일부를 가리지만 반드시 발생하는 미스의 바이트 수는 줄이지 못합니다.
논문은 이 문제가 서로 다른 형태로 나타나는 세 작업을 평가했으며, 그래프 신경망(GNN) 학습은 샘플링한 정점의 특징 벡터를 모읍니다. 딥러닝 추천 모델(DLRM)은 희소한 임베딩 행을 조회합니다. 긴 문맥 LLM 추론은 GPU에 계속 둘 수 없는 KV 캐시 텐서를 옮길 수 있습니다. 접근 패턴은 다르지만 구조를 가진 수치 배열을 전송하며 비트 패턴에 반복이 남을 수 있다는 점은 같습니다.
손실 압축은 바이트 수를 일정하게 줄이는 대신 표현 오차를 받아들입니다. 그러나 같은 양자화 형식도 그래프와 모델에 따라 순위나 생성 분포에 미치는 영향이 달라집니다. 플랫폼 운영자는 작업별로 정확도를 검증하고 모델이 바뀔 때 다시 시험해야 합니다. IBP는 원래 비트열을 정확히 복원하므로 이 정확도 선택을 데이터 이동 경로에서 분리합니다.
모든 값에 반복되는 비트의 분리
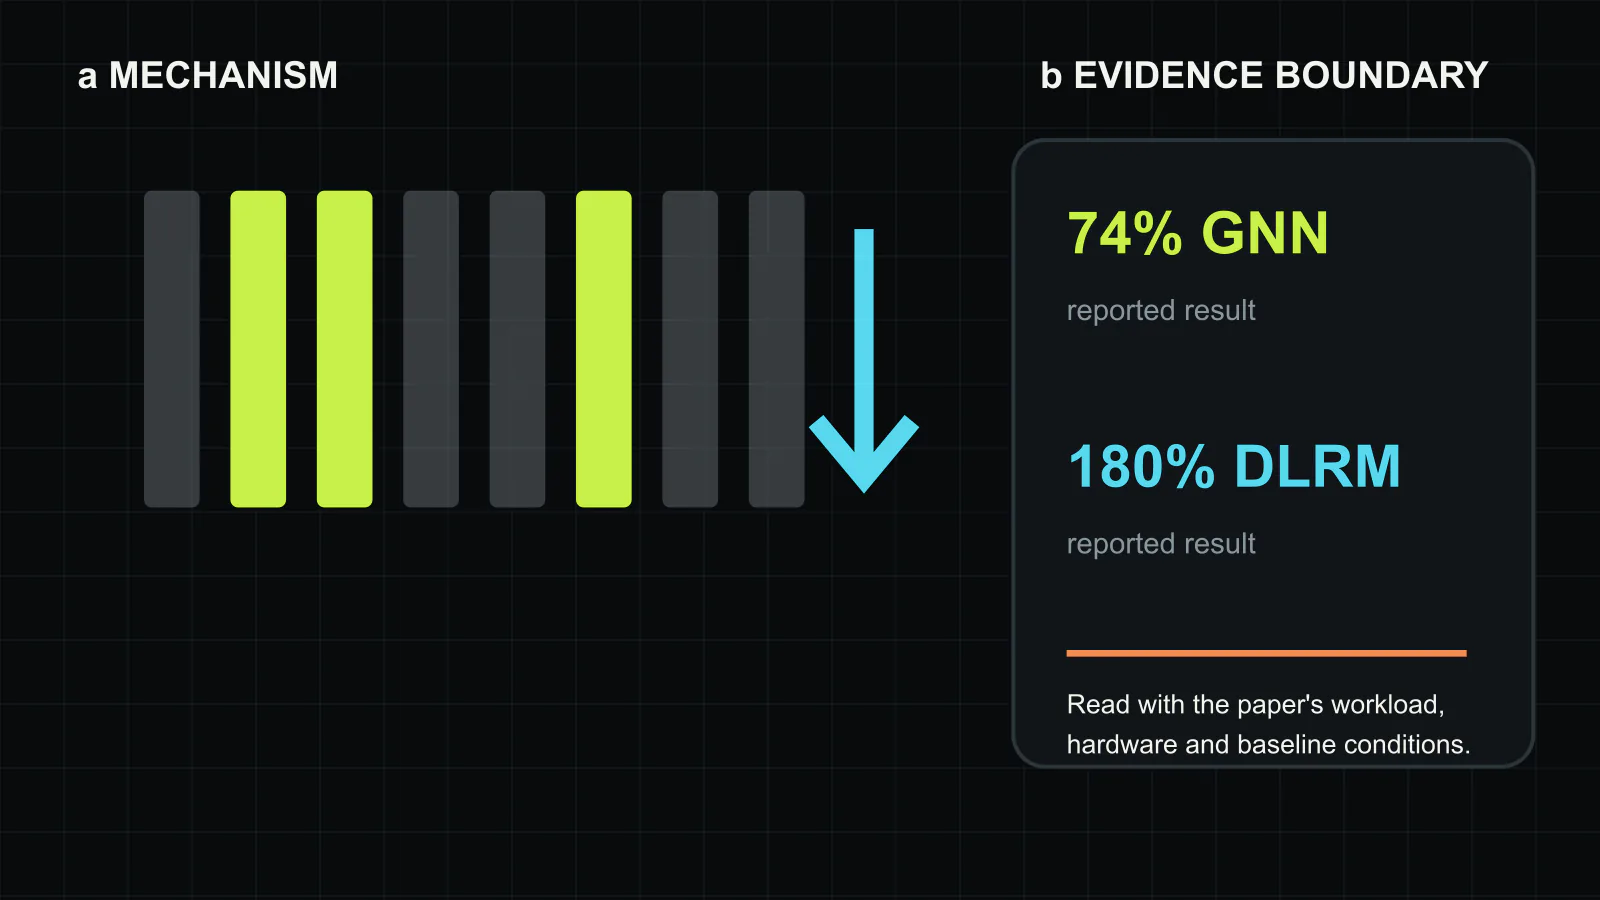
IBP는 여러 값을 묶고 각 비트 위치가 묶음 전체에서 같은지 확인합니다. 항상 같은 위치는 메타데이터에 한 번 기록하고 나머지만 촘촘한 페이로드로 묶습니다. 호스트에는 압축된 표현을 두고 GPU에는 불변 위치를 설명하는 작은 정보를 유지합니다. 캐시 미스가 발생하면 페이로드를 PCIe로 보낸 뒤 GPU 커널이 생략된 비트를 삽입하고 다음 연산자가 원래 텐서를 사용합니다.
일반 목적 코덱과 다른 점은 어디에 연산을 쓰는지에 있습니다. 사전을 만들고 가변 길이 코드를 해석하며 큰 임시 버퍼를 사용하면 텐서가 즉시 필요한 상황에서 전송 절감 시간을 잃을 수 있습니다. IBP는 고정된 비트 연산과 여러 GPU 스레드가 동시에 풀기 쉬운 배치를 선택합니다. GPU에 남기는 메타데이터는 KB 단위이며 압축 상태를 담는 큰 두 번째 구조를 요구하지 않습니다. 사용 직전에 복원하므로 전체 작업 집합을 먼저 풀어 제한된 GPU 메모리에 쌓지 않습니다.
불변 마스크는 데이터의 규칙성을 짧게 표현합니다. 비슷한 범위의 부동소수점 값은 부호와 지수 필드가 반복될 수 있고, 작은 정수 식별자는 상위 비트가 모두 0일 수 있습니다. 제거할 수 있는 양은 표현 형식, 묶는 방법, 값의 분포에 따라 달라집니다. IBP는 언제나 같은 비율을 내는 링크 압축이 아니라 작업 데이터를 이해하고 호스트-장치 경로에 배치한 표현 방식입니다.
압축률만큼 중요한 제로 카피 경로
CPU가 요청마다 데이터를 스테이징 버퍼로 복사한다면 압축률이 높아도 효과가 줄어듭니다. 논문은 GPU가 비동기 전송으로 압축 데이터를 읽고 호스트 프로세서를 중요 경로에 넣지 않은 채 복원하도록 배치합니다. 작은 데이터 조각을 많이 모으는 희소 작업에서는 할당과 복사가 새로운 병목이 되기 쉽기 때문에 이 경로가 중요합니다.
GPU 비용도 함께 계산해야 합니다. 복원은 메모리 대역폭과 명령, 실행 슬롯을 사용합니다. 줄어든 PCIe 시간이 이 비용보다 크고 복원 결과를 다음 연산에 바로 넘길 때 이득이 납니다. 압축이 잘 안 되는 데이터, 이미 HBM에 있는 텐서, 연산 시간이 전송을 완전히 가리는 커널에서는 오히려 손해가 날 수 있습니다.
따라서 텐서 종류마다 줄어든 바이트 수, 피한 전송 시간, 추가된 복원 시간을 측정해야 합니다. 전체 데이터의 평균 압축률 하나만 보면 효과가 없는 텐서를 숨기게 됩니다. 실제 구현은 입력을 표본 조사하고 측정한 손익분기점을 넘는 경우에만 IBP를 선택하며 비압축 경로를 함께 유지하는 편이 안전합니다.
세 작업에서 서로 다르게 읽어야 하는 성능 향상
논문은 NVIDIA A100에서 GNN 학습이 평균 74%, DLRM 임베딩 조회가 평균 180%, LLM 추론이 평균 25% 빨라졌다고 보고했지만[1], 세 수치는 같은 범위의 성능 향상을 뜻하지 않습니다. GNN 결과에는 특징값을 가져오는 시간과 학습 연산의 상호작용이 포함됩니다. DLRM 결과는 희소 데이터 이동 비중이 큰 임베딩 조회 경로를 측정합니다. LLM 결과는 전체 추론 시간에서 KV 데이터를 가져오는 비중에 따라 달라집니다.
180% 향상은 다른 조건이 같다면 조회 처리량이 기존의 2.8배가 됐거나 같은 일을 약 36% 시간에 마쳤다는 뜻입니다. 추천 서비스 전체가 2.8배 빨라졌다는 뜻은 아닙니다. LLM 추론의 25%도 메모리 계층을 사용하는 긴 문맥 서비스에는 의미가 있지만 KV 캐시가 이미 GPU에 들어가는 구성에 그대로 적용할 수 없습니다.
A100이라는 시험 장비는 PCIe, HBM, 복원 커널 처리량의 균형도 정합니다. 더 최신 GPU, CXL 확장 메모리, 다른 CPU 소켓 배치, NVLink로 연결한 메모리 계층을 쓰면 손익분기점이 바뀝니다. IBP의 작동 원리는 유지돼도 압축을 적용할 텐서 크기와 필요한 압축률은 다시 측정해야 합니다.
값이 같아도 남는 시스템 위험
무손실이라는 특성은 복원 텐서가 원본과 같으므로 모델 검증 부담을 줄입니다. 그러나 시스템 구현까지 자동으로 정확해지는 것은 아닙니다. 모든 자료형과 정렬, 마지막에 남는 불완전한 묶음, 메타데이터 경계를 시험해야 합니다. 불변 마스크가 손상되면 여러 값에 동시에 오류가 생길 수 있으므로 체크섬과 비압축 복귀 경로를 저장 형식에 포함해야 합니다.
표본 조사도 운영 조건이 됩니다. 데이터 집합의 한 구간에서 만든 마스크가 나중 구간에서도 같은 압축률을 내리라는 보장은 없습니다. 논문은 표본으로 스트리밍 데이터를 지원하는 방법을 보였지만 운영 계측은 실제 압축률과 복원 비용을 계속 추적해야 합니다. 압축률이 손익분기점 아래로 내려가면 해당 작업은 비압축 경로로 빠져야 합니다.
메모리 용량도 전체 경로에서 계산해야 합니다. 압축된 호스트 사본, GPU 메타데이터, 전송 중인 페이로드, 복원한 출력은 잠시 함께 존재할 수 있습니다. PCIe를 채우려고 여러 전송을 대기시키면 이 순간 용량이 더 커집니다. 압축 페이로드만 보고 용량을 잡으면 고정 호스트 메모리나 GPU 임시 공간을 과도하게 배정할 수 있습니다.
도입 전에 필요한 측정 항목
대표 시험에서는 반드시 가져와야 하는 데이터와 캐시 적중을 분리해야 합니다. 텐서 종류와 자료형, 그룹 크기, 압축률 분포, 압축 경로를 선택한 요청 비율을 공개하고 같은 캐시·미리 읽기 정책에서 압축만 뺀 기준과 비교해야 합니다. 그렇지 않으면 더 나은 데이터 배치에서 나온 효과를 압축의 성능으로 잘못 읽을 수 있습니다.
처리량과 함께 지연시간 분포도 필요합니다. 사용 직전 복원은 평균 처리량을 높이면서도 가져온 텐서마다 작은 고정 비용을 붙일 수 있습니다. 대화형 LLM 서빙은 문맥 길이별 첫 토큰 시간과 토큰 사이 지연시간을 보여야 합니다. GNN과 추천 작업은 에포크 평균이나 조회 평균뿐 아니라 배치의 긴 지연 꼬리도 확인해야 합니다.
전력과 간섭을 포함하면 평가가 완성됩니다. 복원은 모델 커널과 겹칠 수 있는 GPU 명령을 사용하지만 작은 PCIe 페이로드는 입출력 에너지를 낮추고 같은 링크를 쓰는 이웃에게 용량을 돌려 줄 수 있습니다. 여러 작업을 함께 실행하는 시험에서는 한 압축 작업이 노드 전체를 개선하는지, 아니면 간섭 위치를 PCIe에서 SM과 HBM으로 옮기는지만 확인해야 합니다.
정밀도와 전송량을 분리하는 선택
IBP는 수치 정밀도와 전송량을 반드시 한 번에 결정할 필요가 없다는 점을 보여 줍니다. 데이터에 반복되는 비트 위치가 있다면 모델이 쓰는 표현을 그대로 보존하면서 더 적은 바이트를 보낼 수 있습니다. 모델이 바뀔 때마다 정확도 손실을 다시 검증하기 어려운 공유 플랫폼에서 특히 유용합니다.
그렇다고 PCIe 병목이 사라지지는 않습니다. 텐서와 GPU, 데이터 배치 정책에 따라 가치가 달라지는 코덱이 하나 추가됩니다. 실제 제어는 조건을 측정해 텐서 종류별로 압축 전송과 직접 전송을 고르는 방식이어야 합니다. 운영자와 구매자는 평균 성능 향상을 손익분기점 지도로 바꿔 봐야 합니다. 어떤 작업 집합이 GPU 밖으로 밀려나는지, 실제 값이 얼마나 줄어드는지, 어떤 커널에 복원 여유가 있는지를 함께 확인해야 무손실 압축이 유효 대역폭을 만드는지 단계만 늘리는지 판단할 수 있습니다.
출처와 저작권 안내
이 글은 EuroSys 2026 논문[1]을 우리 표현으로 다시 분석한 편집 다이제스트입니다. 논문의 문장·도판·표를 옮기지 않았으며, 본문 도판은 Silicon & Systems가 새로 제작했습니다. 결과는 저자들이 사용한 A100 장비, 작업부하와 비교 기준을 유지해 인용했습니다. 원 논문은 CC BY 4.0으로 공개됐으며 저작권은 저자(2026)에게 있습니다.