최상위 AI 모델의 사전학습에 수만 장의 GPU를 몇 달 동안 사용하면 하드웨어 장애가 몇 시간 간격으로 발생할 수 있습니다. Meta의 Llama 3 학습에서는 H100 16,000장에서 평균 2.78시간마다 하드웨어 장애가 발생했습니다[3]. 일반적인 대응 절차(중단, 로그 분석, 스트레스 테스트, 재스케줄링, 원격 스토리지에서 수 테라바이트 체크포인트 재적재)에는 사건당 수 시간이 필요합니다. ByteDance Seed와 홍콩대의 SOSP 2025 논문은 ByteDance의 실제 LLM 학습에 1년 이상 사용한 관리 계층 ByteRobust를 설명합니다[1]. 핵심 지표는 전체 경과 시간 중 학습이 실제로 진행된 비율인 유효 학습 시간 비율(ETTR)입니다. ByteRobust는 Hopper GPU 9,600장을 사용한 3개월 사전학습에서 누적 ETTR 97%를 유지했으며, 한 번의 비생산 구간도 50분을 넘지 않았습니다.
아래는 논문의 논지를 우리 표현으로 재구성한 것입니다. 이 논문의 핵심은 복구의 우선순위를 바꾼 데 있습니다. 이 규모에서는 원인을 완전히 규명할 때까지 전체 작업을 멈추는 비용이 크므로, 시스템은 결함 장비를 먼저 격리하고 정밀 진단은 학습 재개 뒤에 수행합니다.
실제 장애 원인의 분포
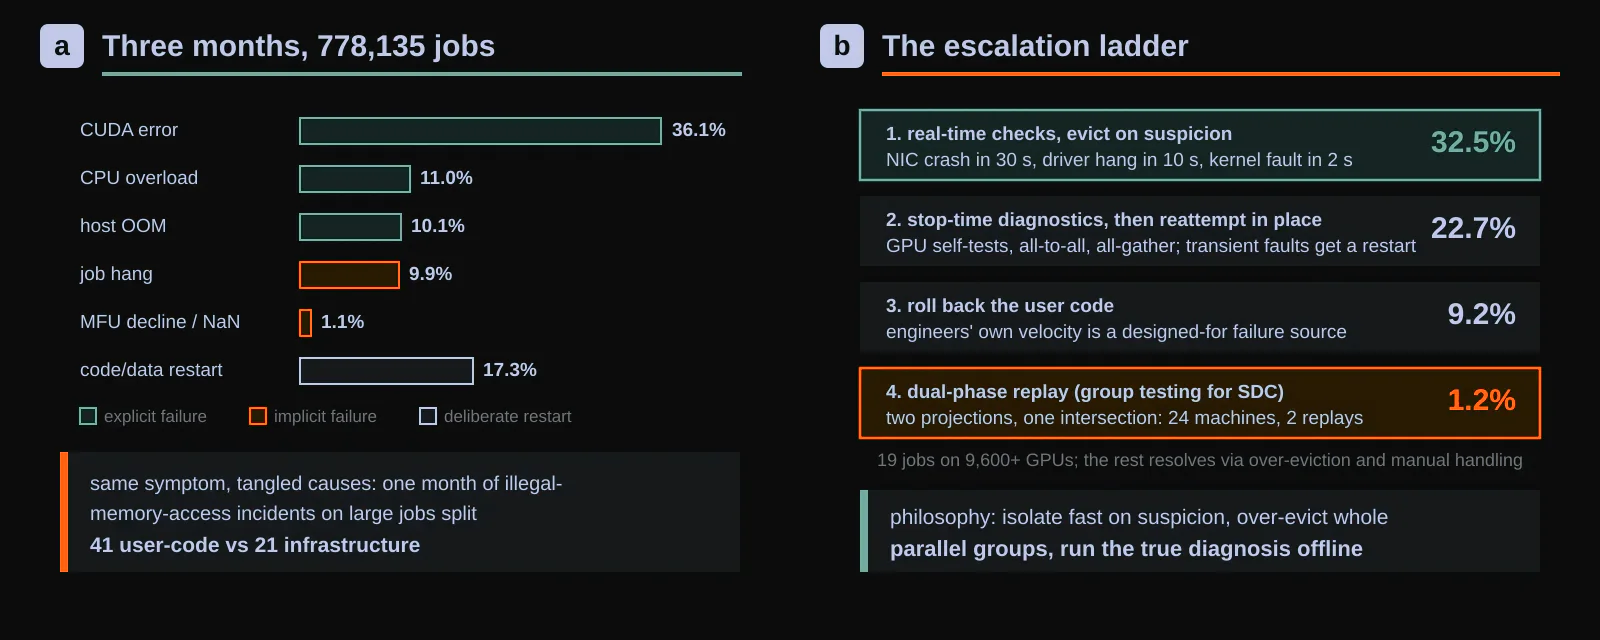
논문은 대규모 운영 환경의 장애 분포부터 제시합니다. 석 달 동안 실행한 778,135개 학습 작업에서 ByteRobust는 명시적 장애 38,236건과 암묵적 장애 5,948건을 분류했습니다. 전자는 에러 메시지나 종료 코드가 남는 사건이고, 후자는 작업이 진행되지 않거나 손실 곡선이 이상해지는 현상으로만 나타난 사건입니다. 명시적 장애에서는 CUDA 에러가 36.1%로 가장 많았고 CPU 과부하 11.0%, 호스트 메모리 고갈 10.1%가 뒤를 이었습니다. 암묵적 장애에서는 작업 멈춤(hang)이 전체 사건의 9.9%로 가장 많았습니다. 전체 사건의 17.3%는 의도적 재시작이었습니다. 엔지니어가 데이터 배합을 바꾸거나 융합 커널을 넣거나 병렬화 구성을 조정하려고 실행 중인 작업을 세운 경우입니다. 따라서 신뢰성 설계는 고정된 코드에서 발생하는 하드웨어·소프트웨어 장애뿐 아니라 학습 중 코드와 데이터가 바뀌는 운영 과정도 다뤄야 합니다.
이 조사에서는 같은 증상도 원인이 다르므로 복구 전에 근본 원인을 확정하기 어렵다는 점도 확인됩니다. 한 달 동안 대형 작업에서 발생한 불법 메모리 접근은 사용자 코드에서 41번, 인프라에서 21번 나왔습니다. 증상만 보고 코드 롤백이나 장비 교체 중 하나를 바로 선택할 수 없다는 뜻입니다. 암묵적 장애는 진단이 더 어렵습니다. 멈춘 집합 통신은 NCCL 타임아웃이 발생하는 30~60분 뒤까지 로그를 남기지 않고[2], MFU 하락은 여러 장비의 지표를 함께 낮춥니다. 조용한 데이터 손상(SDC)[7]은 집합 통신을 따라 퍼져 GPU 한 장의 잘못된 계산이 전역 그래디언트를 오염시키며, NaN은 원인이 있는 장비와 다른 위치에서 나타날 수 있습니다. 저자들이 나중에 SDC로 확정한 장비에 NVIDIA 현장 진단 도구를 적용했을 때 재현율은 70%였습니다. 진단 도구 하나만으로는 결함 장비의 약 30%를 놓칠 수 있습니다.
빠른 격리부터 시작하는 복구 단계
ByteRobust는 장애 위치를 완전히 특정할 때까지 기다리지 않고 의심되는 장비를 먼저 격리합니다. 희소 자원은 GPU 시간이므로, 원인 분석을 기다리는 동안 전체 클러스터를 멈추는 비용이 오탐으로 장비 한 대를 제외하는 비용보다 클 수 있기 때문입니다. 아키텍처는 제어 평면(탐지와 복구를 지휘하는 컨트롤러, 런타임 증거를 다루는 분석기)과 파드마다 상주하는 데이터 평면(감시·진단·트레이스 수집·체크포인트 에이전트)으로 나뉩니다. 복구는 비용이 낮은 단계부터 시작하며, 대부분의 장애가 앞 단계에서 해결됩니다.
첫 단계는 실시간 점검입니다. 가벼운 검사 스레드가 GPU 부하를 거의 늘리지 않으면서 네트워크, GPU, 호스트 상태를 초 단위로 확인합니다. 약 10분의 분산 타임아웃을 기다려야 발견할 수 있는 NIC 고장을 30초에, GPU 드라이버 멈춤을 10초에 찾고, OS 커널 오류는 2초 안에 확인합니다. GPU가 사라지거나 디스크가 응답하지 않는 것처럼 확실한 신호는 추가 진단 없이 해당 장비를 바로 격리합니다. 원인이 분명하지 않은 채 학습이 멈추면 두 번째 단계에서 GPU 자체 검사, 장비 내 올투올, 장비 간 all-gather를 차례로 실행합니다. 특정 장비가 확인되지 않으면 세 번째 단계에서 같은 위치에 작업을 재시작해 일시적인 링크 장애인지 확인합니다. 그래도 실패하면 네 번째 단계에서 사용자 코드를 마지막 안정 버전으로 되돌려 코드 변경과 장비 장애를 구분합니다. GPU 9,600장 이상을 사용한 운영 환경 작업 19개에서 즉시 격리, 같은 위치 재시도, 코드 롤백은 각각 장애의 32.52%, 22.70%, 9.20%를 해결했습니다. 마지막 정밀 진단 단계까지 필요한 비율은 1.23%였습니다.
마지막 단계는 기존 진단에서 재현되지 않는 SDC 의심 사례를 다룹니다. ByteRobust는 그룹 검사(group testing)를 사용해 축소한 작업을 두 번 재연합니다. 한 번은 장비를 연속 구간으로 묶고, 다른 한 번은 일정 간격을 둔 그룹으로 묶습니다. 텐서·파이프라인 병렬 크기는 고정해 통신 패턴을 유지하고 데이터 병렬 폭만 줄입니다. 각 재연에서 결함이 나타난 그룹의 교차점으로 고장 장비를 찾습니다. 장비 24대를 이진 탐색하면 다섯 번이 필요하지만 이 방식은 재연 두 번으로 끝납니다. 이 장비군에서 관측한 SDC가 거의 항상 장비 한 대에서 발생했다는 조건을 이용한 방법입니다.
로그 대신 스택 트레이스를 읽는 방식
멈춤과 감속에 대해 ByteRobust의 분석기는 로그 대신 모든 학습 프로세스의 파이썬·네이티브 스택 트레이스를 즉시 수집합니다. 근본 원인이 자주 숨는 데이터 로더와 체크포인트 하위 프로세스도 포함합니다. 집계는 세 단계입니다. 각 파드의 프로세스 트리를 해석하고, 수집한 스택을 문자열 일치로 묶고, 다수파 묶음을 정상으로 분류합니다. 남는 것이 이상치이고, 시스템은 이상치 전부를 덮는 가장 작은 병렬 그룹(대개 파이프라인 그룹 하나)을 축출합니다. 이것이 의도된 과잉 축출(over-eviction)이라는 데 유의해야 합니다. 9,600장 GPU 작업에서 PP 그룹 하나는 장비 8대에 걸치는데 실제 결함은 한두 대뿐이므로, 사건마다 정상 장비 6~7대도 함께 제외합니다. 저자들은 이를 몇 분 안에 학습을 재시작하기 위한 비용으로 봅니다. 감속(성능 저하 장애) 사례에서는 집계를 10초마다 반복해 다섯 라운드 동안 가장 자주 지목된 병렬 그룹을 원인 후보로 확정합니다. 사례 연구는 이 방식의 효과와 한계를 함께 보여 줍니다. 평가 단계에서 발생한 멈춤은 장비 6대짜리 파이프라인으로 자동 격리되었고, CUDA 코어에 결함이 있던 장비 2대는 학습 재개 뒤 백그라운드 스트레스 테스트를 며칠간 수행한 후에 확인됐습니다.
복구도 일급 메커니즘
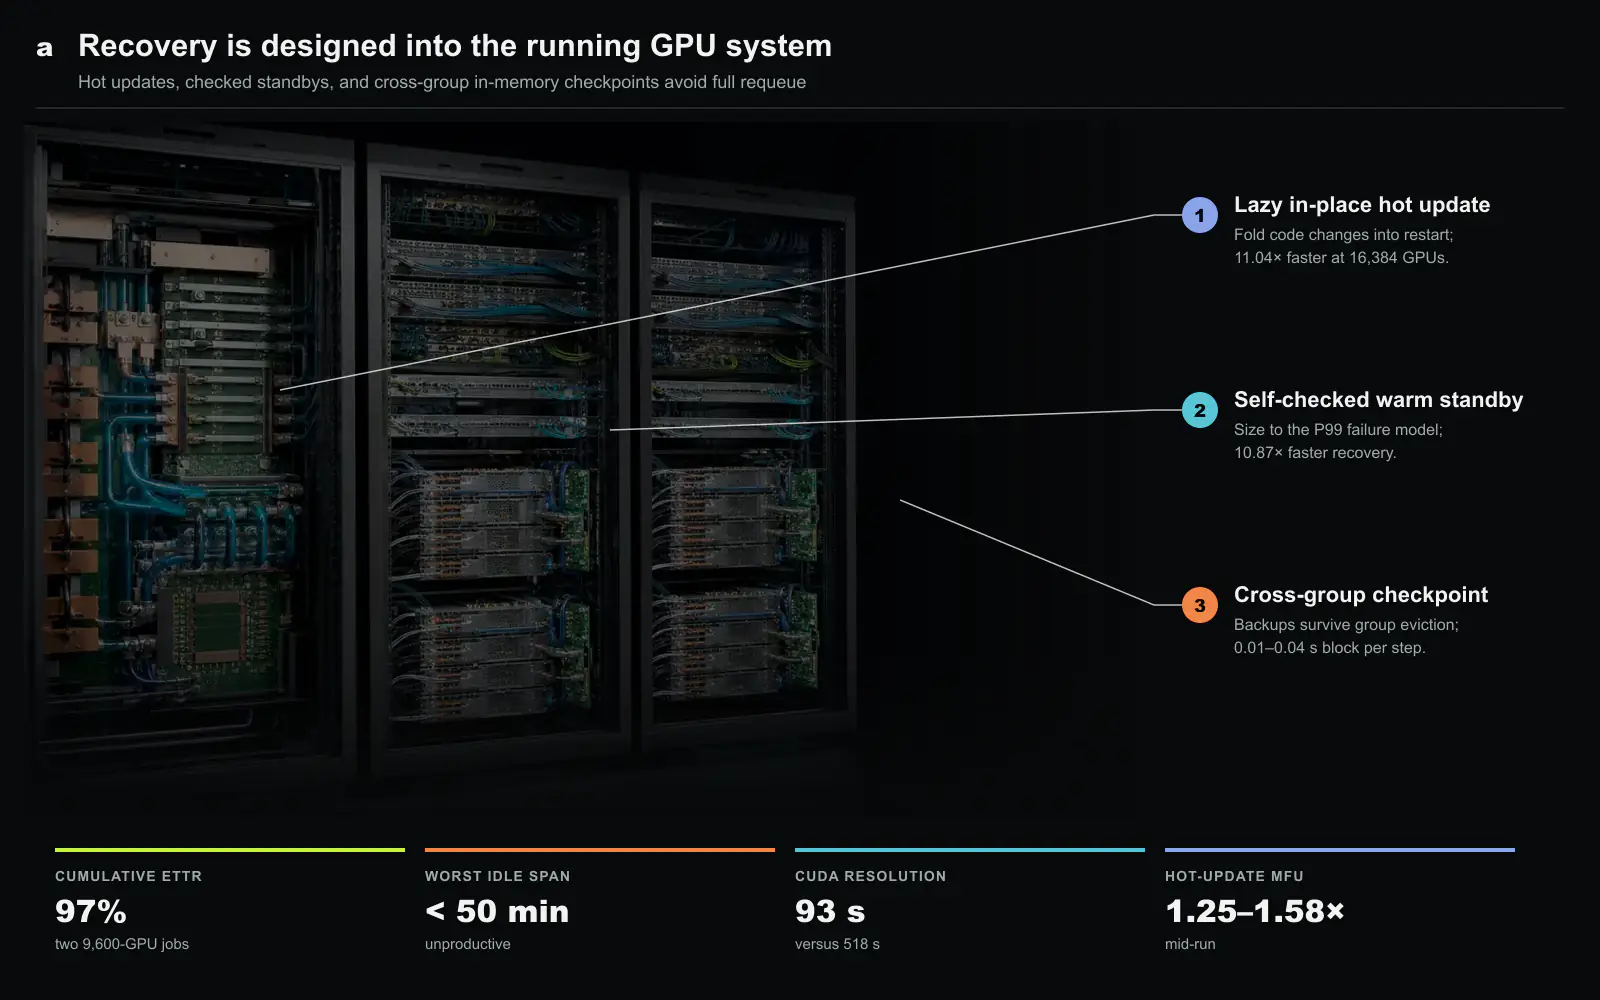
탐지 뒤 전체 작업을 다시 스케줄링하면 중단 시간이 길어지므로 복구 경로도 함께 최적화했습니다. 제자리 핫 업데이트는 파드를 다시 만들지 않고 코드 변경을 적용합니다. 긴급 수정은 즉시 학습을 멈추고 적용하지만, 일반 업그레이드는 다음 장애 복구 시점에 함께 적용하며 24시간 안에는 반드시 반영합니다. 웜 스탠바이 장비는 자체 점검을 마친 뒤 저전력 상태로 대기합니다. 필요한 수량은 동시 장애를 이항분포로 모형화한 99분위 값으로 정하며, 장비 1,024대 작업에는 예비 4대면 충분하다고 계산했습니다. 체크포인트는 매 스텝마다 메모리에 기록합니다. 샤드를 전용 CUDA 스트림에서 이중 버퍼로 호스트에 복사하고, 텐서·파이프라인·데이터 병렬 그룹 밖의 장비에 백업해 병렬 그룹 전체를 격리해도 상태가 남게 합니다. 최대 16,384 GPU 작업에서 핫 업데이트는 전체 재큐잉보다 11.04배 빠르게 학습을 재개했고(65초 대 768초), 웜 스탠바이는 평균 재스케줄링 시간을 10.87배 줄였습니다. 예비 장비가 무한하다고 가정한 최적값과의 차이는 5.19%였습니다. 매 반복 체크포인트가 학습을 멈추는 시간은 스텝당 0.01~0.04초였고, 체크포인트 없는 학습 대비 MFU의 99% 이상을 유지했습니다. Megatron-LM 기본 방식은 약 40%를 유지했습니다.
배치가 보여 준 것
대표 배치 사례는 Hopper GPU 9,600장 클러스터의 운영 환경 사전학습 두 건입니다. 70B급 밀집 모델은 석 달, 200B급 전문가 혼합(MoE) 모델은 한 달 동안 학습했습니다. 두 작업 모두 누적 ETTR 97%를 유지했습니다. 1시간 단위로 보면 ETTR 하락은 각 작업의 후반부에 집중됐습니다. 새로 배치한 장문맥 기능이 코드 장애를 일으키고 노후한 클러스터에서 성능 저하가 잦아진 시기였습니다. 그래도 빠른 복구 덕분에 누적 ETTR의 변화는 작았습니다. 기존 선별적 스트레스 테스트[4][6]와 비교하면 CUDA 에러의 평균 해결 시간은 518초에서 93초로 84.50% 줄었습니다. 코드 변경이 일으킨 장애처럼 스트레스 테스트로 위치를 찾을 수 없는 경우도 롤백으로 약 1분 안에 처리했습니다. 두 작업의 MFU는 학습 기간에 걸쳐 각각 1.25배와 1.58배 높아졌으며, 최적화는 핫 업데이트로 배포해 ETTR 감소를 줄였습니다. MFU 저하 사건 하나는 진단 도구가 이전 점검에서 GPU 주파수 잠금을 해제한 것이 원인이었습니다. 진단 계층 자체도 장애 원인이 될 수 있음을 보여 주는 사례입니다.
신뢰성은 유효 학습 시간으로 평가해야 할 이유
ByteRobust는 바이트댄스 학습 스택에서 연산 계획과 복구를 연결합니다. HybridFlow[8]가 GPU에 어떤 연산을 배치할지 정한다면, ByteRobust는 장애가 발생해도 그 연산을 계속 진행하게 합니다. 같은 SOSP 세션의 Aegaeon은 요청이 끝날 때까지 기다리지 않고 토큰 사이에서 모델을 바꾸며, ByteRobust는 근본 원인을 확정할 때까지 기다리지 않고 의심 장비를 먼저 격리합니다. 두 시스템 모두 전체 진행을 막던 대기 조건을 줄였습니다. ByteRobust의 일반화 가능한 기여는 신뢰성을 유효 학습 시간 문제로 정의한 데 있습니다. 예비 장비와 중복 상태를 사용해 클러스터의 중단 시간을 줄이고, 정밀 진단은 학습 재개 뒤에 수행합니다. 다만 ETTR 97%는 장비군의 장애 통계로 예비 장비 수를 정하고 운영 엔지니어가 지속적으로 시스템을 개선한 환경에서 얻은 값입니다. 다른 장비군에서는 장애 빈도, 탐지 지연, 복구 시간과 예비 자원 비용을 함께 측정해야 합니다.
신뢰성 용량도 별도 예산으로 보여 줘야 할 이유
웜 스탠바이, 병렬 그룹 밖의 체크포인트 복제, 진단 워커, 함께 격리된 정상 장비는 모두 용량을 사용합니다. 설치한 GPU, 작업에 배정한 GPU, 준비 상태로 남긴 예비 장비, 진단을 위해 제외한 장비, 복구 비용을 뺀 유효 가속기 시간을 함께 적어야 ETTR 97%를 다른 예비 정책과 비교할 수 있습니다.
최근 장애를 바탕으로 만든 이항분포는 시작점입니다. 랙, 네트워크, 펌웨어, 냉각의 공통 장애는 독립 가정을 깨뜨립니다. 예측한 동시 장애와 실제 꼬리를 계속 비교하고 과소평가가 반복되면 예비 수량이나 장애 영역을 넓혀야 합니다. 과잉 축출의 기준도 체크포인트 시점, 작업 우선순위, 예비 장비 부족에 따라 달라져야 합니다. 핵심은 항상 많이 격리하는 것이 아니라 진단 대기와 복구 가능한 진도를 같은 비용표에서 비교하는 것입니다.
출처와 저작권 안내
이 글은 Silicon & Systems가 작성한 편집 요약으로, 아래에 인용한 논문의 논지를 우리 표현으로 재서술한 것입니다. 원문의 문장, 도판, 표는 이 글에 재사용하지 않았으며, 이 페이지의 도판은 모두 이 요약을 위해 새로 제작했습니다. 논문은 SOSP 2025에서 발표되었고 Creative Commons Attribution 4.0 International 라이선스로 배포됩니다. 확정본은 Proceedings of the 31st ACM Symposium on Operating Systems Principles에 실려 있습니다. (c) 2025 the authors.