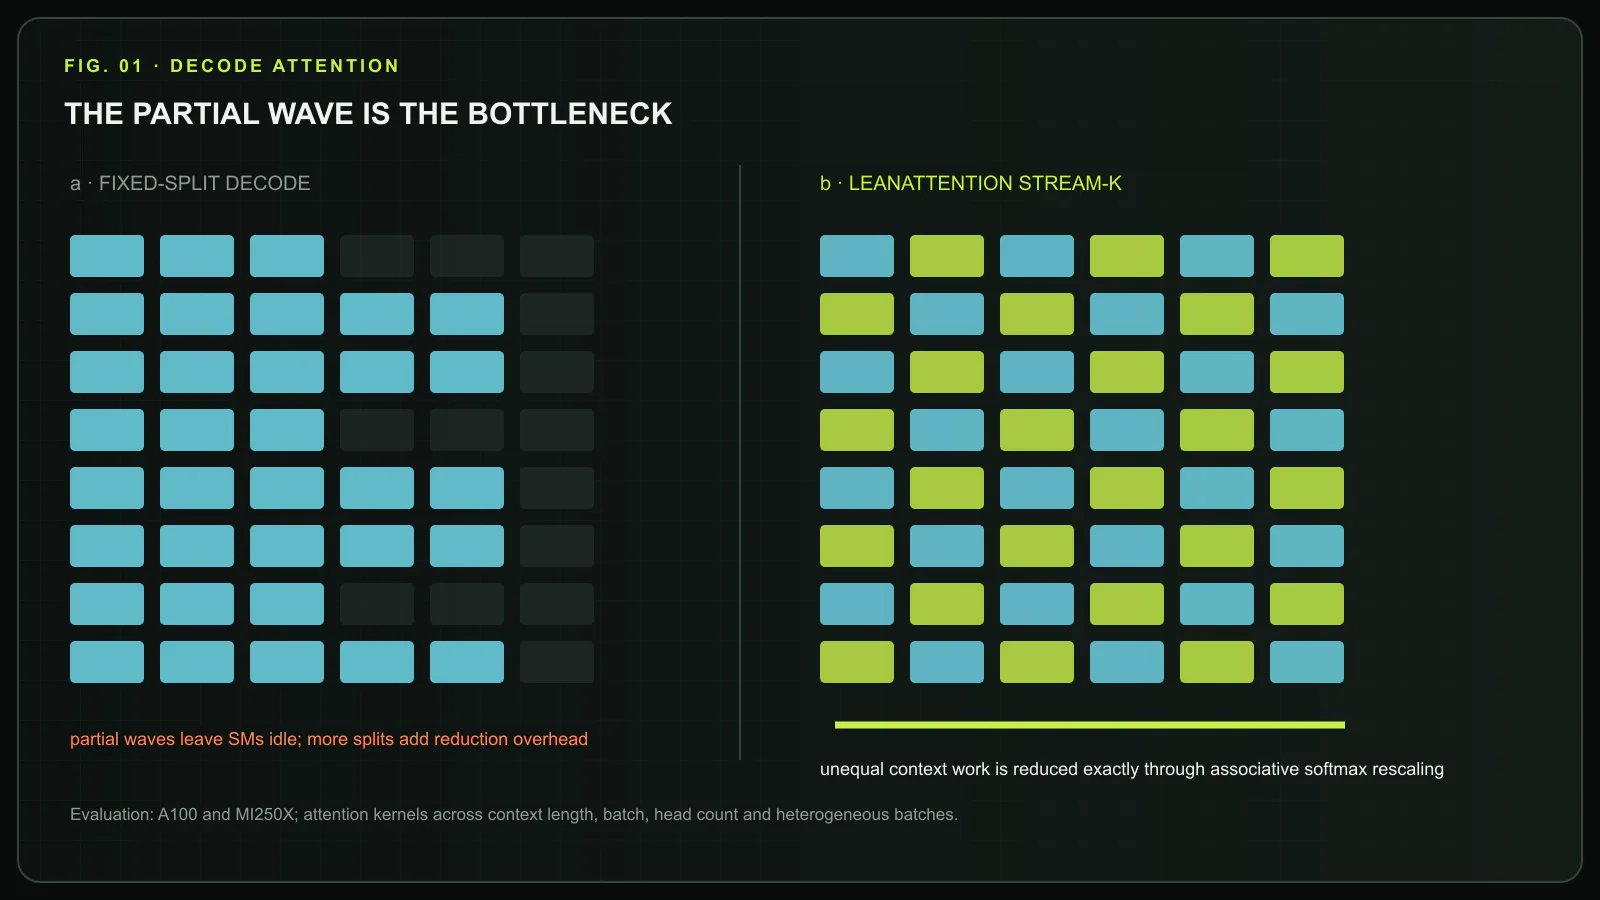
LLM 디코드는 GPU 활용률을 오해하기 쉬운 단계입니다. 요청 하나가 토큰을 한 개씩 생성하므로 쿼리 길이는 1인데, 읽어야 할 KV 문맥은 수십만 토큰까지 늘어납니다. 어텐션은 긴 문맥을 계속 읽지만 고정된 분할 수로는 모든 스트리밍 멀티프로세서(SM)에 독립 작업을 배정하지 못할 수 있습니다. 메모리 대역폭이 병목인데도 일부 GPU 코어가 놀게 됩니다.
Microsoft가 MLSys 2025에 발표한 LeanAttention은 마지막에 일부만 채워지는 실행 웨이브를 줄입니다[1]. 문맥을 LeanTile이라는 하드웨어 크기의 작업으로 나누고, 가용 연산 자원에 이어서 배정합니다. 온라인 소프트맥스의 재조정 연산은 결합 순서를 바꿀 수 있으므로 크기가 다른 조각도 정확하게 합칠 수 있습니다. 어텐션 수식은 유지한 채 작업 분배만 바꾸는 방법입니다.
모양이 다른 프리필과 디코드
FlashAttention은 어텐션 점수와 확률 행렬을 전역 메모리에 쓰지 않고 온칩 메모리에서 타일 단위로 계산해 속도를 높이고[2], FlashAttention-2는 쿼리 길이 방향의 병렬성도 추가합니다. 프리필에는 여러 쿼리 행이 있어 이 방식이 잘 작동하지만, 디코드의 현재 쿼리는 토큰 하나뿐이고 KV 캐시가 메모리 대부분을 차지하므로 배치와 헤드 수를 무한히 늘릴 수도 없습니다.
FlashDecoding은 키·값 문맥을 여러 조각으로 나누고 부분 어텐션 결과를 합칩니다. 한 번 실행할 때 분할 수가 고정됩니다. 협력 스레드 배열 수가 SM 수로 나누어떨어지지 않으면 앞선 웨이브는 가득 차고 마지막 웨이브는 일부만 실행됩니다. 분할 수를 늘리면 더 많은 SM을 채울 수 있지만 부분 결과와 리덕션, 레지스터 사용량도 늘어납니다. 최적값은 문맥 길이, 배치, 헤드 수와 GPU 종류에 따라 달라집니다.
서로 다른 길이의 요청을 묶으면 불균형이 커집니다. 연속 배칭은 문맥 길이가 다른 요청을 함께 처리합니다. 고정된 크기로 나눈 블록은 어떤 요청에서는 긴 구간을, 다른 요청에서는 짧은 구간을 맡습니다. 커널은 가장 오래 걸린 블록이 끝나야 완료되므로 평균 활용률이 높아 보여도 마지막 작업이 지연시간을 결정합니다.
조각별로 합칠 수 있는 정확한 소프트맥스
임의 분할을 어렵게 만드는 부분은 소프트맥스입니다. 출력은 전체 문맥의 최댓값과 지수 합에 의존하므로, 같은 크기의 정해진 조각으로만 계산해야 할 것처럼 보입니다. 그러나 온라인 소프트맥스는 이 통계를 순차적으로 갱신합니다. LeanAttention은 부분 출력이 각자의 최댓값, 정규화 합과 가중값을 가지고 있으면 재조정 연산의 결합 순서를 바꿀 수 있다는 점을 사용합니다.
따라서 어텐션 헤드 하나를 서로 다른 크기의 작업으로 나눌 수 있으며, LeanTile은 GPU를 효율적으로 쓰는 최소 단위가 됩니다. 전역 작업 번호는 배치, 헤드와 문맥 범위의 타일을 CTA에 연결하며, 행렬곱의 리덕션 차원을 작업 흐름으로 나누는 스트림-K와 비슷합니다. CTA가 고정된 분할에 묶이지 않고 다음 타일을 가져오므로 긴 요청은 더 많은 타일을 내고 짧은 요청은 일찍 끝낼 수 있습니다.
마지막 리덕션은 부분 결과를 공통 최댓값에 맞게 다시 조정해 합치므로 토큰을 버리지 않고 소프트맥스를 근사하지도 않으며, 이 점이 어텐션 함수를 바꿔 속도를 얻는 방식과 다릅니다. 다만 타일이 많아지면 리덕션 상태가 늘기 때문에 LeanTile 크기는 레지스터와 공유 메모리, 상주 블록 수에 맞춰야 합니다.
하드웨어에 맞춘 작업 단위
LeanAttention은 총 작업량과 가용 연산 장치 수로 타일 수를 정합니다. 논문에서 말하는 거의 100%의 점유율은 유효 작업을 가진 블록이 SM에 상주한다는 뜻이며, 텐서 코어가 최고 산술 처리량을 낸다는 뜻은 아닙니다. 디코드 어텐션은 많은 구성에서 여전히 메모리 이동에 제한됩니다. 빈 구간을 줄여도 물리 대역폭 자체가 늘어나는 것은 아닙니다.
상주형 커널은 CTA를 유지한 채 다음 작업을 가져와 불규칙한 배치에 유리합니다. 다만 자원을 오래 점유하면 서빙 파이프라인의 다른 커널과 간섭할 수 있습니다. LeanAttention을 완전한 서빙 스케줄러보다 하나의 커널 스케줄링 도구로 보는 이유입니다. 실제 런타임은 배칭과 모델 실행 순서까지 함께 조정해야 합니다.
멀티 GPU 텐서 병렬화는 장치당 헤드 수를 줄입니다. GPU를 추가했는데 각 GPU가 맡은 헤드가 너무 적어 SM을 채우지 못하는 구간이 생길 수 있습니다. 이때 문맥 방향의 LeanTile이 유효합니다. A100과 MI250X에서 같은 원리를 적용할 수 있는 것도 고정 워프 수가 아니라 연산 장치 수와 작업 크기를 기준으로 하기 때문입니다. 실제 구현과 조정값은 백엔드마다 따로 필요합니다.
평가 수치가 말하는 범위
논문은 A100과 MI250X에서 문맥 길이, 배치 크기, 헤드 수와 헤드 차원을 바꿔 어텐션 커널을 시험했습니다. 비교 대상은 FlashAttention-2, FlashDecoding과 FlashInfer 계열의 고정 분할입니다. 모델 실험은 LeanAttention을 ONNX Runtime에 통합하고 Phi 계열 구성을 사용해 디코드와 전체 추론 시간을 측정했습니다.
공개된 디코드 어텐션 시험에서 LeanAttention은 FlashDecoding보다 지연시간을 평균 1.73배 줄였습니다. 256K 문맥에서는 최대 2.18배입니다. 헤드 수가 적고 문맥이 긴 일부 구성은 3배가 넘는 차이를 보였는데, 고정 분할에서 놀던 SM이 많았던 경우입니다. 배치나 헤드 수가 늘어 기준 방식만으로 GPU가 채워지면 격차는 줄어듭니다.
문맥이 길수록 절대 시간이 줄어드는 것은 아닙니다. 긴 문맥은 GPU를 채울 타일을 제공하지만 읽어야 할 메모리와 리덕션 작업도 늘립니다. LeanAttention은 고정 분할보다 작업을 고르게 나눠 증가 기울기를 낮춥니다. 전체 지연시간은 문맥 길이와 함께 계속 커집니다.
길이가 다른 배치에서는 평균 문맥과 최대 문맥의 비율이 낮을수록 고정 분할의 불균형이 커집니다. LeanAttention의 전역 타일 흐름은 짧고 긴 요청이 같은 연산 자원을 공유하게 하므로 상대 이점이 늘어납니다. 동일 길이 요청보다 여러 사용자의 다른 길이 요청을 섞는 실제 서빙 환경에 가까운 결과입니다.
커널 속도와 서비스 처리량의 차이
대표 수치는 어텐션 연산 시간이며 전체 서빙 속도가 아닙니다. 트랜스포머 한 단계에는 QKV 프로젝션, 출력 프로젝션, 피드포워드, 정규화, 샘플링과 프레임워크 실행도 들어갑니다. 논문은 다른 행렬곱을 최적화한 긴 문맥 구성에서 디코드 어텐션이 전체 추론 시간의 50~60%를 차지할 수 있다고 봅니다. 특정 모델이나 배치에서 비중이 작으면 전체 개선도 제한됩니다.
모델 실험에서도 프롬프트와 출력 길이 비율, 생성 토큰 수와 디코드 비중에 따라 전체 이점이 달라집니다. LeanAttention은 쿼리 길이가 1인 단계를 겨냥하므로 프리필이 긴 요청은 효과가 작습니다. 긴 문서를 넣고 짧은 답 하나를 받는 서비스보다, 문맥이 커지는 동안 많은 토큰을 생성하는 에이전트 작업에 더 잘 맞습니다.
지연시간 목표를 지킨 서비스 처리량에는 다른 제약도 있습니다. 커널이 빨라져 배치를 키울 수 있어도 KV 캐시 용량이 먼저 막힐 수 있습니다. 동적 배칭, 프리픽스 재사용과 프리필·디코드 분리는 대기열의 병목을 바꿉니다. 장비 수를 계산할 때는 커널 배율을 그대로 곱하지 말고 같은 도착 트레이스에서 토큰 간 시간과 완료 요청 수를 측정해야 합니다.
정확성의 의미와 검증 범위
LeanAttention은 알고리즘 차원에서 정확한 어텐션 수식을 유지합니다. 부동소수점에서는 합산 순서가 바뀌면 마지막 비트가 달라질 수 있습니다. 병렬 리덕션에서 일반적으로 나타나는 현상입니다. 여기서 ‘정확함’은 희소화나 소프트맥스 근사를 의도적으로 넣지 않았다는 뜻이지, 모든 스케줄이 비트 단위로 같은 결과를 낸다는 뜻은 아닙니다.
온라인 소프트맥스는 최댓값을 추적해 오버플로를 줄이지만, 매우 긴 시퀀스와 낮은 정밀도 누산에서는 차이가 드러날 수 있습니다. 운영 커널은 점수 범위가 큰 입력, 마스크, 그룹 쿼리 구조와 서로 다른 문맥 길이를 별도로 시험해야 합니다. 아키텍처별 성능 최적화마다 정확성 회귀 검사를 붙여야 합니다.
에너지 수치도 범위를 구분해야 합니다. 점유율을 높이면 빨리 끝나지만 순간 전력은 올라갈 수 있습니다. 논문 부록은 문맥이 길어질수록 고정 분할 대비 어텐션 커널 에너지가 줄어드는 결과를 제시합니다. 장비군 비교에는 HBM 에너지, 토큰 사이 유휴 전력과 동시 요청 증가까지 노드 전력 경계에서 포함해야 합니다.
런타임 선택 정책
모든 디코드에 LeanAttention을 고정 적용할 필요는 없습니다. 런타임은 실제 형태에 따라 FlashAttention 계열, 고정 분할과 스트림-K 방식을 고를 수 있습니다. 짧은 문맥이나 큰 배치는 기존 방식만으로 GPU를 채우며 추가 리덕션을 피할 수 있습니다. 긴 문맥, 적은 장치당 헤드 수와 불균일 배치가 겹칠 때 가치가 큽니다.
선택기에 필요한 입력은 배치 안의 문맥 길이 분포, 텐서 병렬화 뒤 장치당 헤드 수, 헤드 차원, SM 수, 가용 공유 메모리와 현재 GPU 경합입니다. 평균 지연시간만 비교해서는 부족합니다. P99 토큰 간 시간, 생성 토큰당 에너지와 인접 커널 간섭을 함께 봐야 상주형 타일 흐름이 서비스 전체를 개선했는지 알 수 있습니다.
Admission control과도 연결해야 합니다. 256K 문맥 요청은 어텐션 시간뿐 아니라 KV 용량을 사용합니다. 디코드가 빨라져도 메모리 조각화나 프리필 대기열이 지연시간 목표를 깰 수 있습니다. 더 빠른 커널이 실제 용량을 만들었는지는 요청 전체의 비용을 계산한 뒤 판단해야 합니다.
시스템 도입의 기준
LeanAttention은 디코드 어텐션의 마지막 불완전한 GPU 웨이브라는 좁지만 중요한 낭비를 찾았습니다. 온라인 소프트맥스의 수학적 성질을 이용해 하드웨어 크기의 작업 흐름을 만들고, 모델 의미를 바꾸지 않은 채 낭비를 줄입니다. 평균 1.73배라는 결과가 설득력 있는 이유도 점유율을 예측하는 문제 형태에 따라 이점이 달라지기 때문입니다.
더 큰 교훈은 메모리 대역폭 병목이라는 진단만으로 충분하지 않다는 점입니다. 메모리 이동에 제한된 커널도 연산 장치에 작업을 불균형하게 배치할 수 있습니다. 긴 문맥, 적은 로컬 헤드와 불규칙한 배치가 겹치면 정확한 타일 재배치가 용량을 되찾습니다. 다른 단계가 시간을 지배한다면 더 필요한 변경은 배칭이나 프리필, 메모리 관리일 수 있습니다.
출처와 저작권 안내
이 글은 MLSys 2025 논문[1]을 우리 표현으로 다시 분석한 편집 다이제스트입니다. 논문의 문장·도판·표를 옮기지 않았으며, 본문 도판은 Silicon & Systems가 새로 제작했습니다. 수치는 저자들이 공개한 시험 범위에 따라 설명했습니다. 원 논문의 저작권은 저자에게 있습니다(2025).