오늘 출하되는 스케일업 도메인은 하나같이 스위치를 전제합니다. NVIDIA NVL-72는 GPU 72장을 NVLink 스위치 실리콘 트레이로 엮고, 구글 TPUv4는 64칩 큐브 사이를 중앙 집중식 광 회선 스위치로 잇고, 추격 중인 개방 표준들(UALink, 스케일업 이더넷)도 결국 그런 스위치가 말해야 할 언어의 명세입니다. SIGCOMM 2025에서 LLM 랩 StepFun이 실리콘 포토닉스 업체 Lightelligence, 북경대와 함께 발표한 논문은 스위치가 아예 사라지면 어떻게 되는지 묻습니다[1]. 이들의 답 InfiniteHBD는 회선 스위칭을 트랜시버 안으로 옮깁니다. 800 Gbps 광모듈마다 작은 마하-젠더 간섭계(MZI) 매트릭스를 실어 빛을 두 개의 외부 경로와 내부 루프백 사이에서 조향하는 것입니다. 이 모듈만으로 데이터센터 전체에 임의 크기의 링을 만들고, 장애를 노드 하나로 격리하며, 인터커넥트 비용을 GPU당 GB/s당 NVL-72의 31%에 맞춥니다. 대신 지원하는 통신 형태가 제한됩니다. 이 패브릭은 링 토폴로지만 지원합니다.
아래는 그 논지를 우리 표현으로 정리한 것이며, 어디까지가 실측 하드웨어이고 어디부터가 시뮬레이션인지 함께 표시합니다.
더 크고 더 유연한 도메인이 필요하다는 논거
논문은 설계의 명분을 겸하는 작업부하 분석으로 문을 엽니다. 자체 학습 시뮬레이터로 Llama 3.1-405B를 돌려 보면, 모델 FLOPs 이용률(MFU)을 최대로 만드는 텐서 병렬(TP) 크기는 클러스터 규모와 함께 자랍니다. 1,024 GPU에서 16이던 최적 TP가 65,536 GPU에서는 64가 되고, 8-GPU 서버가 강제하는 TP-8에 묶인 클러스터는 131,072 GPU 규모에서 최대 3.37× 뒤처집니다. TP는 링 올리듀스로 동기화하고 그 트래픽은 논리적 이웃만 오가므로, 큰 TP를 감당하는 도메인에 실제로 필요한 것은 임의 노드 간 대역폭이 아니라 길고 신뢰할 수 있는 링입니다. Mixture of Experts(MoE) 모델에 대해서는 한 발 더 나가, TP가 전문가 병렬(EP)을 대신할 수 있다고 주장합니다. 이론상 EP가 데이터를 덜 옮기지만 실제 라우터는 전문가마다 토큰을 고르지 않게 나눠 주는데, 1.1조 파라미터 모델 시뮬레이션에서 이 불균형이 대략 10%를 넘으면 낙오자(straggler) 효과가 EP의 통신 이점을 지워 버립니다. 이들의 탐색에서 최적 EP 차수는 1로 나옵니다.
이 세계관이 논쟁 지대에 있다는 점은 짚어 둘 필요가 있습니다. 본지가 앞서 다룬 딥시크의 ISCA 논문은 대규모 EP 올투올을 MoE 추론의 규정적 트래픽으로 놓고 그것을 가속할 패브릭을 요구합니다[5]. InfiniteHBD는 학습을 놓고 정반대의 설계 전제를 택합니다. 전문가를 TP로 고르게 쪼개고, 트래픽을 이웃 간에 가두고, 정확히 그 패턴만을 위한 가장 싼 패브릭을 짓자는 것입니다. 어느 쪽이 더 오래 유효할지는 패브릭 요구 사항을 MoE 서빙이 정하느냐 학습이 정하느냐에 달려 있고, 두 논문은 같은 긴장을 반대로 읽는 유익한 짝입니다.
세 가지 아키텍처, 세 가지 장애 기하학
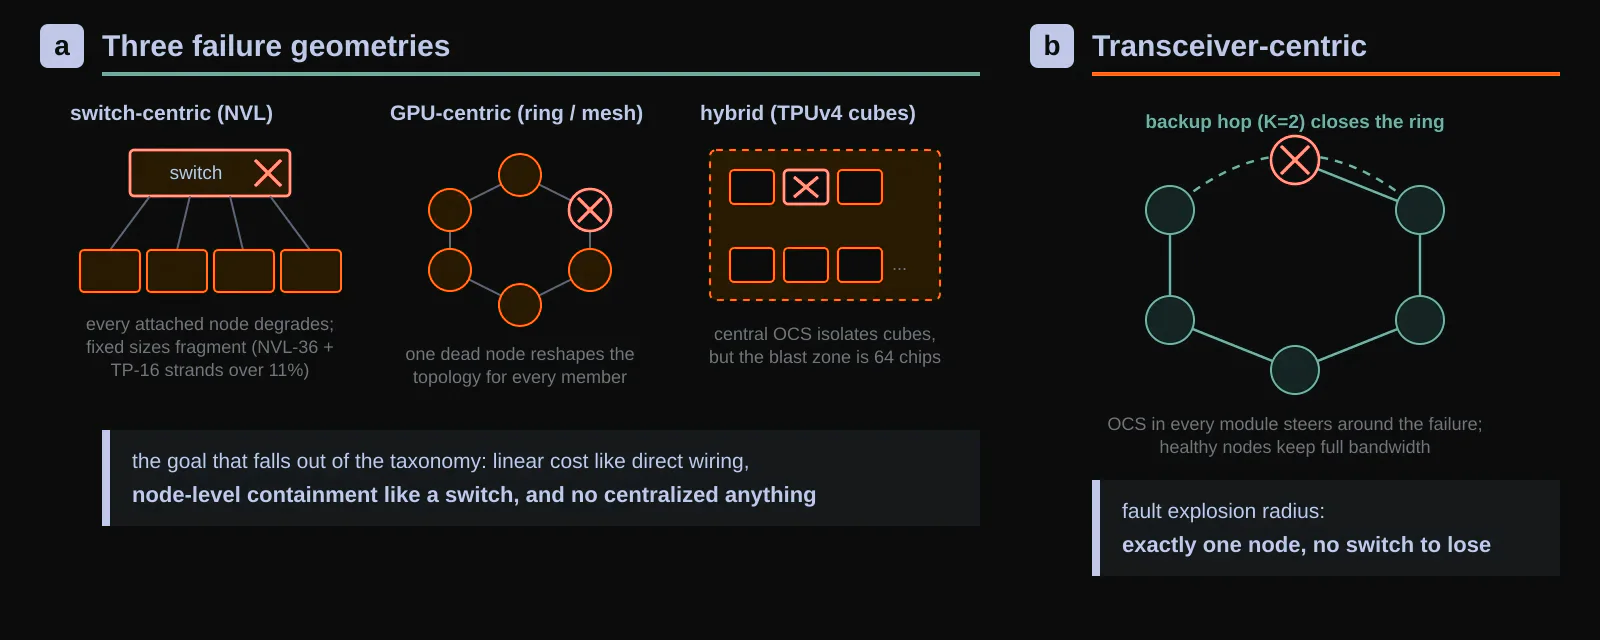
분류 절은 이 논문에서 핵심 분석 기준입니다. 스위치 중심 도메인(NVL-36/72/576)은 임의 노드 간 통신을 스위치 칩으로 사는데, 그 비용은 규모에 대해 초선형으로 자라고, 스위치가 하나 죽으면 붙어 있던 모든 노드가 함께 느려집니다. 고정된 크기는 파편화도 부릅니다. GPU 36장의 도메인에서 TP-16을 돌리면 최소 11%의 용량이 놀게 되는데, 36에서 장애분을 뺀 수가 16으로 나눠떨어지지 않기 때문입니다. GPU 중심 설계(TPUv3, 테슬라 Dojo, SiP-ML의 링 제안[3])는 스위치를 지우고 가속기끼리 직결해 비용을 선형으로 만들지만 운명을 한데 묶습니다. GPU 하나가 고장 나면 전체 토폴로지가 영향을 받습니다. 저자들은 이를 HBD 수준 장애 폭발 반경이라고 부릅니다. TPUv4는 64칩 큐브 사이에 광 스위치를 두는 절충으로 장애를 가두지만[2], 격리 단위가 여전히 64칩 폭발 반경이고, 중앙 집중식 OCS 하드웨어 자체의 비용과 제조 난도가 남습니다. 설계 목표는 이 분류에서 그대로 따라 나옵니다. GPU 중심처럼 선형인 비용, 스위치 중심처럼 노드 단위인 장애 격리, 그리고 중앙 집중식 장치의 부재입니다.
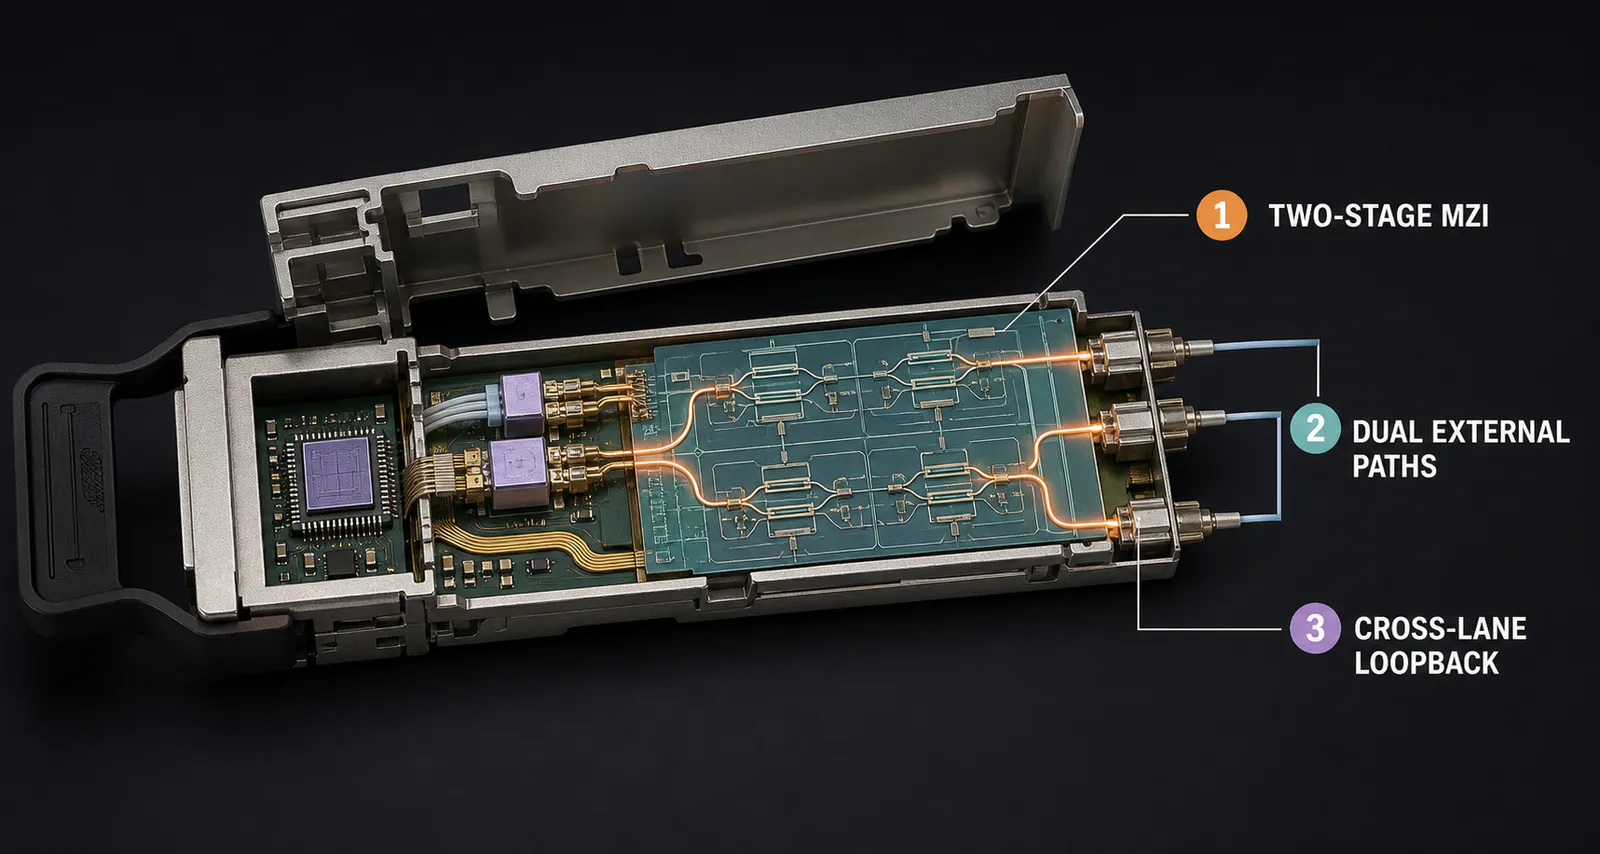
QSFP-DD 모듈에 넣은 회선 스위치
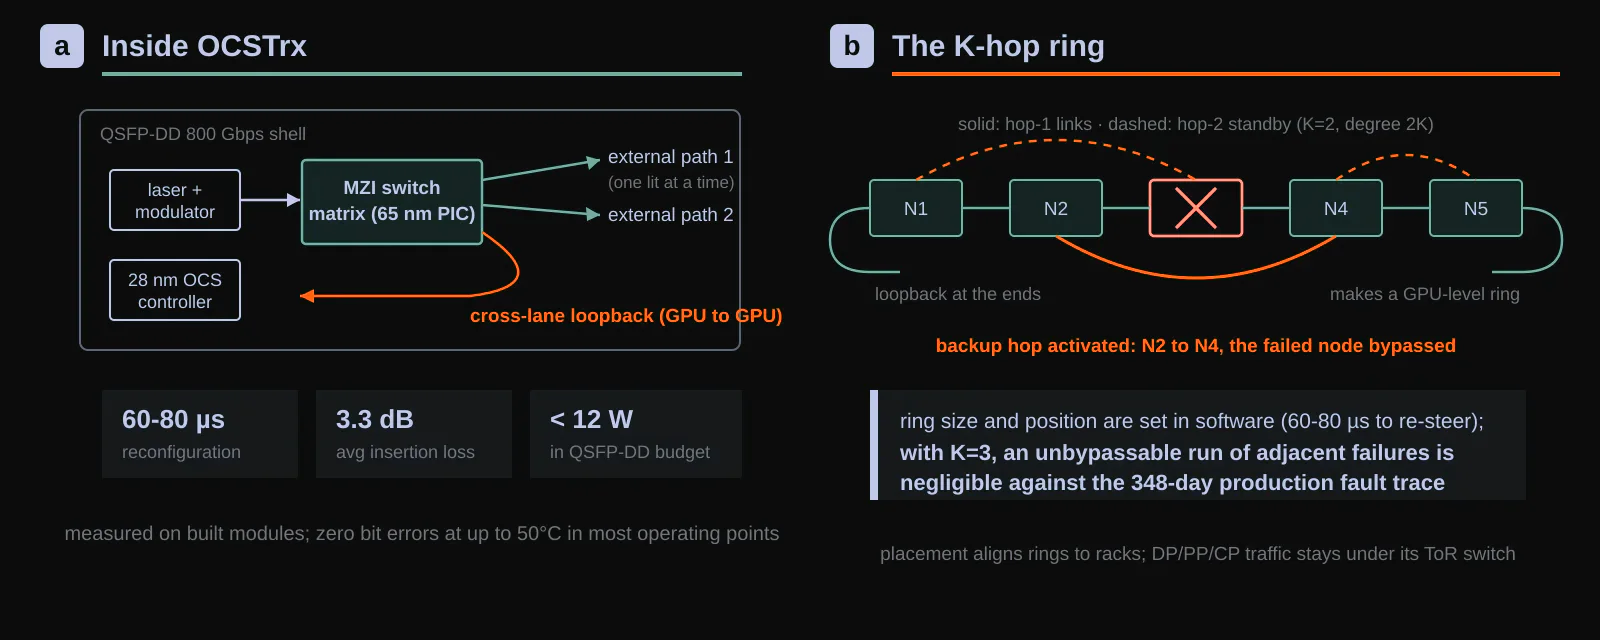
이 논문에서 실측 실리콘으로 존재하는 부분이 바로 이 하드웨어입니다. OCSTrx는 실리콘 포토닉 OCS를 표준 QSFP-DD 800 Gbps 트랜시버에 통합합니다. MZI 스위치 매트릭스를 실은 10.5×13 mm의 65 nm 포토닉 칩을 4×4 mm의 28 nm 컨트롤러가 구동합니다. 두 단의 MZI가 초기 라우팅(외부 경로 1, 외부 경로 2, 또는 루프백)을 결정하고, 내부 크로스바가 모듈에 붙은 두 GPU 사이의 레인 단위 루프백을 처리합니다. 열광학 위상 암은 빛의 경로를 60~80 µs에 재구성하는데, MEMS·피에조·로봇식 광 스위치의 밀리초에서 분 단위보다 자릿수로 빠르고, 학습 스텝 뒤에 숨기기에 충분합니다. 실측된 대가는 작습니다. 상온 평균 삽입 손실 3.3 dB(부품별 2.5~4.0 dB), 50°C까지 대부분의 동작점에서 비트 오류 0, 모듈 전력 12 W 미만으로 QSFP-DD 규격 안입니다. 스위칭이 트랜시버 단위로 일어나므로 외부 경로는 한 번에 하나만 켜지고, GPU의 전체 대역폭은 대기 링크에 쪼개지는 대신 활성 연결을 통째로 따라갑니다.
이 모듈로 조립하는 토폴로지가 K-홉 링입니다. 각 노드는 거리 1부터 K까지의 이웃(실전에서는 K=2 또는 3)으로 광 링크를 내고, 노드마다 2K개의 우회 경로를 갖습니다. 정상 운용에서 TP 그룹은 노드 사슬의 양 끝에서 루프백을 켜 GPU 단위 링을 만듭니다. 링의 크기와 위치는 소프트웨어가 정합니다. 노드가 고장 나면 이웃들이 그 노드를 건너뛰는 예비 홉으로 재구성해 링을 복구하고, 장애 범위는 노드 하나에 머뭅니다. K=3이면 인접 노드가 연달아 고장 나 우회가 막힐 확률이 이들의 장애 통계에서 무시할 수준이 됩니다. 배치 알고리즘은 이 링 도메인을 일반 데이터센터 네트워크와 함께 편성해서, TP 그룹을 랙에 정렬하고 이더넷 패브릭을 건너야 하는 병렬화 차원들(데이터, 파이프라인, 컨텍스트)을 각각 하나의 ToR 스위치 아래에 배치합니다.
실측 결과와 시뮬레이션 결과의 경계
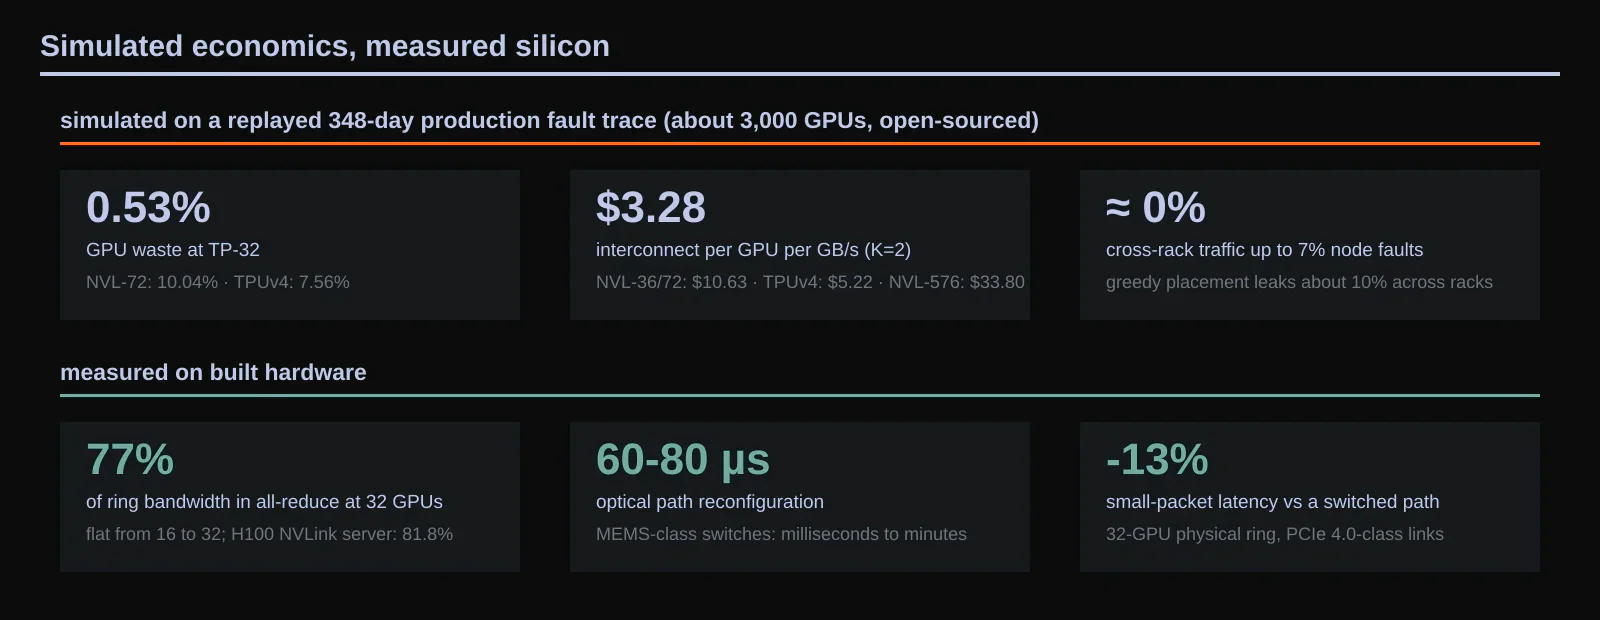
평가는 하드웨어 층과 시뮬레이션 층으로 깔끔하게 갈립니다. 위의 트랜시버 수치는 제작된 모듈의 벤치 실측으로, PCIe와 이더넷 레인 속도에서 검증되고 온도 사이클 시험을 통과했습니다. 물리 링으로 배선한 32-GPU 클러스터(PCIe 4.0 기반 호스트 간 링크를 갖춘 실험용 GPU)에서 올리듀스는 16 GPU에서 링 대역폭의 77.1%, 32 GPU에서 77.3%를 썼습니다. H100 NVLink 서버의 81.8%에는 못 미치지만, 소형 패킷 지연은 스위치 경로보다 13% 낮았고, 무엇보다 16에서 32로 늘려도 곡선이 평평하다는 점이 고무적입니다. 링은 커질수록 나빠지는 것이 보통이기 때문입니다.
나머지는 실측 장애 데이터에 근거한 시뮬레이션 결과입니다. 장애 모델은 StepFun의 약 3,000 GPU 운영 환경 클러스터에서 수집한 348일치 트레이스를 재생하며, 팀은 이 트레이스를 공개했습니다. 이 트레이스로 TP-32 작업을 실행하면 InfiniteHBD의 유휴 GPU 비율은 0.53%로, NVL-72의 10.04%, TPUv4의 7.56%보다 각각 19배와 14배 낮습니다. K=2와 K=3의 차이가 작으므로 이 장애율에서는 세 번째 홉의 추가 효과가 제한적입니다. 비용에서는 부품 명세 분석 기준 K=2의 인터커넥트가 GPU당 GB/s당 3.28달러로, NVL-36/72의 10.63달러(30.9%), TPUv4의 5.22달러(62.8%)와 비교됩니다. NVL-576의 다층 패브릭은 33.80달러까지 오릅니다. 편성 알고리즘은 노드 장애율 7%까지 랙 간 트래픽을 0에 가깝게 유지합니다(탐욕적 배치는 약 10%를 랙 밖으로 보냅니다). 다만 3.37배 MFU 향상은 실측 가속이 아니라 GPU 131,072장 시뮬레이션에서 TP-64를 사용할 수 있게 된 효과입니다. 이 결과에는 저자들이 공개한 단순화가 하나 들어 있습니다. 큰 TP 시뮬레이션에서 Llama의 그룹 쿼리 어텐션을 고전적 멀티헤드 어텐션으로 바꿨으며, 이 선택은 실제 405B 모델보다 필요한 TP 크기를 크게 계산할 수 있습니다.
실험으로 확인되지 않은 범위
검증 범위에는 세 가지 경계가 있습니다. 첫째, 이 패브릭에서 대규모 학습을 실행한 결과는 아직 없습니다. 가장 큰 실물은 PCIe 4.0급 링크를 사용한 32-GPU 링이며, 장비군 수준의 낭비율, 비용, MFU는 운영 환경 트레이스를 입력한 자체 시뮬레이터에서 계산했습니다. 둘째, 링에서 전문가 병렬(EP) 올투올 트래픽은 O(p²)의 교환을 수행합니다. 저자들은 작은 그룹에서 격차를 줄이는 이진 교환 변형을 검토했지만 장애 복구와 배치가 복잡해져 채택하지 않았습니다. 딥시크의 분석처럼 MoE 추론에서 올투올이 핵심 트래픽이라면 링 전용 도메인은 적용할 수 있는 작업이 제한됩니다. 셋째, 한 도메인에서 TP와 EP를 함께 사용하려면 병렬화 차원마다 트랜시버 묶음을 전용하거나 광 경로를 시분할해야 하며, 두 방식 모두 자원 활용과 제어 비용을 추가합니다. 비교 기준에도 주의가 필요합니다. NVL-72 비용은 공개 자료와 2차 출처를 조합해 계산했으며 실제 대규모 구매 가격과 다를 수 있습니다.
트랜시버가 토폴로지를 바꾸는 장치가 되는 과정
스케일업 논쟁은 대체로 더 큰 스위치들 사이의 경쟁이었습니다. 현재의 NVLink 도메인, 향후 UALink와 스케일업 이더넷, 그리고 일관성 메모리 쪽에서는 본지가 원칩형 데이터센터 설계와 파네시아의 스위치 실리콘에서 다룬 CXL 패브릭이 후보입니다. 이 논문은 별도의 선택지를 제시합니다. 대형 모델 학습을 지배하는 특정 트래픽 패턴에서는 스위치를 없애는 것이 가장 저렴하며, 재구성 가능한 점대점 광학이 같은 비용의 스위치 패브릭보다 큰 도메인을 제공할 수 있다는 주장입니다. 이 논문의 지속적인 기여는 특정 링 토폴로지보다 마이크로초 단위로 재구성되는 OCS 기능을 상용 트랜시버 안에 넣을 수 있음을 보인 데 있습니다. Google은 이 기능을 방 크기의 스위치로 구현했습니다[2][4]. 엔드포인트의 광 경로를 소프트웨어로 정할 수 있으면 토폴로지를 작업부하에 맞춰 바꿀 수 있습니다. 업계가 임의 노드 간 스위칭과 링 중 어느 방향을 선택하더라도, 이 논문이 실증한 트랜시버는 양쪽에 쓸 수 있습니다.
제어 평면은 요청한 토폴로지를 증명해야 할 이유
스위칭을 트랜시버로 분산하면 데이터 경로는 단순해지지만 토폴로지 상태가 안전 조건이 됩니다. 집합 통신을 시작하기 전에 모든 끝단이 활성 광 경로, 우회한 노드, 링 순서에 동의해야 합니다. 오래된 경로는 통신 그룹을 나누거나 트래픽을 순환시킬 수 있으므로, 제어기는 버전이 붙은 토폴로지 변경을 수행하고 모듈의 확인을 받은 뒤 새 통신 그룹을 작업에 보여 줘야 합니다.
복구 시간에는 60~80 µs의 광 전환뿐 아니라 장애 감지, 경로 계산, 모듈 설정, 링크 훈련, 통신 그룹 복구, 집합 통신 재실행이 들어갑니다. 실배치에서는 이 전체 구간과 잃은 학습량을 보고해야 합니다. 일반 패킷 스위치는 더 비싸지만 라우팅, 텔레메트리, 격리, 복구가 성숙합니다. 끝단 OCS가 동기식 학습에 필요한 기능을 더 낮은 총비용으로 제공하는지가 실제 비교 기준입니다.
출처와 저작권 안내
이 글은 Silicon & Systems가 작성한 편집 요약으로, 아래에 인용한 논문의 논지를 우리 표현으로 재서술한 것입니다. 원문의 문장, 도판, 표는 이 글에 재사용하지 않았으며, 이 페이지의 도판은 모두 이 요약을 위해 새로 제작했습니다. 논문은 SIGCOMM 2025에서 발표되었고, 확정본은 Proceedings of the ACM SIGCOMM 2025 Conference에 실려 있습니다. (c) 2025 the authors, publication rights licensed to ACM. 저자 준비판은 arXiv:2502.03885에서 열람할 수 있습니다.