논문은 두 수치를 비교하며 시작합니다. 2017년부터 2022년까지 대표 GPU의 부동소수점 처리량은 V100에서 H100으로 4배 늘었지만, 같은 기간 주요 AI 모델의 연산 요구량은 BERT-base에서 GPT-3으로 1,500배 증가했습니다. 중국 사업자는 성능이 제한된 수출 규제형 가속기를 사용해야 하므로 격차가 더 큽니다. 14억 활성 사용자에게 1조 파라미터 이상의 자체 모델을 서비스하는 Tencent는 부족한 칩당 성능을 데이터센터 규모의 확장으로 보완했습니다. Tencent가 난징대, 하버드, 밀라노 공대와 함께 SIGCOMM 2025에 발표한 Astral은 GPU 51만2천 장을 목표로 설계한 패브릭입니다[1]. 18개월에 걸쳐 구축했으며 현재 두 개 파드에서 12만8천 장을 운영합니다. 이 규모에서는 네트워크 구조만으로 부족하며 모니터링과 성능 예측기가 같은 설계 안에서 움직여야 합니다.
아래는 논지를 우리 표현으로 재구성한 것입니다.
모든 랭크를 같은 레일에 배치하는 패브릭
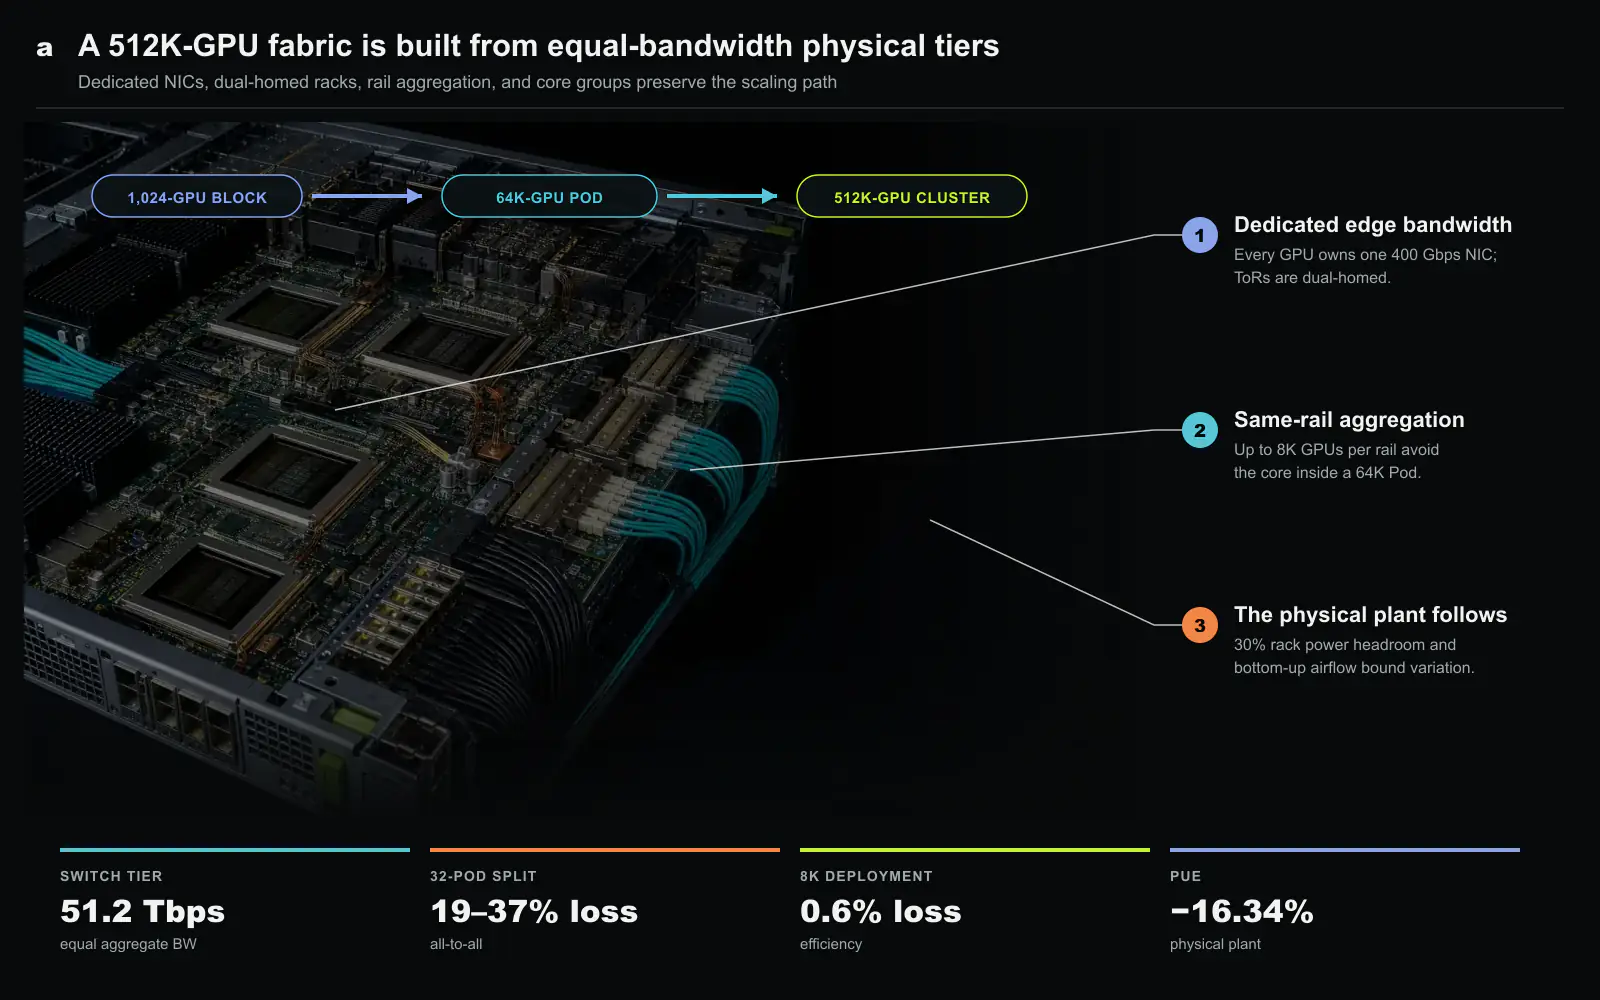
Astral의 호스트 구성에는 특별한 요소가 없습니다. NVLink급 호스트 내 네트워크 뒤에 GPU 8장, 2×200 Gbps NIC 8장이 있고 NIC 하나가 GPU 하나를 전담하므로, 가속기마다 전용 400 Gbps RDMA가 붙고 서버 한 대가 패브릭에 3.2 Tbps를 제공합니다. 설계를 가르는 첫 결정은 한 계층 위에서 시작됩니다. 요즘 집합 통신 라이브러리는 호스트 간 트래픽을 같은 랭크의 GPU들(“같은 레일”)끼리 오가도록 라우팅하고, 이 최적화가 켜져 있으면 트래픽 대부분이 레일 안에 머문다는 것을 Astral의 운영 환경 통계가 확인해 줍니다. 그래서 이 아키텍처는 2계층에서 같은 레일의 ToR 스위치들을 묶습니다. GPU 1,024장짜리 블록이 이중화된 ToR 16대에 연결되고(NIC의 두 포트는 서로 다른 ToR에 연결되어 스위치나 광모듈 하나가 고장 나도 서버가 고립되지 않습니다), 여러 블록의 같은 레일 ToR들이 64대 단위의 애그리게이션 스위치 그룹으로 모입니다. 그 결과가 GPU 6만4천 장 규모의 파드(Pod)입니다. 이 안에서는 같은 랭크의 GPU 어느 둘이라도, 레일당 최대 8천 장까지, 코어 계층을 거치지 않고 서로 통신합니다. 레일을 가로지르는 트래픽에도 그룹당 64대의 코어 스위치를 지나는 경로가 남아 있는데, 이 점이 Meta의 rail-only 제안과 Astral을 가릅니다. rail-only에서는 레일 간 통신이 호스트 내부 인터커넥트로 우회해야 합니다.
두 번째 결정은 비용을 더 쓰더라도 모든 계층의 집계 대역폭을 동일하게 맞추는 것입니다. 51.2 Tbps 스위치로 구성한 세 계층 어디에도 과약정(oversubscription)을 두지 않습니다. Meta, ByteDance, Alibaba는 모두 애그리게이션과 코어 사이를 과약정합니다[2][3][4]. 3계층까지 올라오는 트래픽이 적다는 관찰에 따른 선택입니다. Tencent가 같은 방식을 택하지 않은 이유는 논문의 측정이 설명합니다. GPU 1천 장짜리 올투올 작업을 파드 하나 대신 32개에 나누면 집합 통신 처리량이 19~37% 줄고, 3계층 과약정은 올투올 처리량을 최대 52%, 학습 전체 성능을 3% 낮춥니다. 3%가 큰 숫자인 이유는 계산과 겹치고 남는 통신 시간이 전체의 15% 남짓뿐이기 때문입니다. 영향은 모델 구조에 따라 달라집니다. 밀집 Transformer가 주로 사용하는 데이터 병렬 AllReduce와 파이프라인 점대점 트래픽은 레일 안에 머물지만, 전문가 혼합(MoE) 모델의 전문가 병렬 올투올은 그렇지 않습니다. 업계가 MoE로 이동할수록 이 차이가 중요해집니다. 고객마다 할당량이 예측하기 어렵게 나뉘고 늘어나는 클라우드에서는 균일한 대역폭이 서비스 품질 보증의 일부가 됩니다. 어느 위치의 GPU를 할당해도 같은 네트워크 성능을 제공해야 하기 때문입니다. 부하 분산은 ECMP를 유지하되 2단계 보정 절차를 붙였습니다. 흐름마다 UDP 소스 포트를 골라 경로를 고르게 분산하고, 그래도 스위치의 ECN 카운터가 혼잡을 보고하면 중앙 컨트롤러가 스위치와 같은 해시 함수를 시뮬레이션으로 실행해 문제 흐름의 소스 포트를 다시 배정합니다.
네트워크 아래에서는 GPU 51만2천 장 규모가 만드는 전력과 냉각 제약을 해결해야 합니다. 논문은 GPU를 장착한 뒤 서버 한 대의 에너지 사용량이 8배 늘었다고 설명하며 절대값을 1kWh에서 8kWh로 표기합니다. kWh는 에너지 단위이므로 순간 전력의 절대값으로 해석하기보다 논문이 보고한 8배 변화에 주목해야 합니다. Astral은 이 증가에 대응해 교류(AC)+UPS 조합을 분산형 고압 직류(HVDC) 시스템으로 바꿨습니다. 랙 한 줄마다 배치된 유닛이 배터리를 직접 충전하고, LLM 학습에 따른 배터리 용량의 20~30% 변동을 흡수하며, 반복 단계마다 GPU가 TDP를 넘는 순간에는 개별 랙이 정격보다 최대 30% 많은 전력을 공급받게 합니다. 2024년에는 지붕 태양광과 풍력이 에너지의 22%를 공급했습니다. 냉각도 두 단계로 바뀌었습니다. 공기 흐름을 수직 방향(측면 흡기 대신 아래에서 위로)으로 바꿔 랙 간 온도 편차를 1도에서 0.11도로 줄였고, 가장 뜨거운 부품은 콜드 플레이트가 맡되 공랭 계통과 하나의 1차 냉원을 공유하게 했습니다. 액랭과 공랭의 적정 비율이 작업부하에 따라 달라지고 시설은 약 10년 동안 사용하므로, 냉각 방식의 비율을 조절할 수 있어야 했기 때문입니다. 평균적으로 Astral의 PUE는 Tencent의 기존 데이터센터보다 16.34% 개선됐습니다. 일중 전력 사용 패턴도 운영 정책에 반영했습니다. 사용자 요청이 많은 낮에는 전력 사용량이 높고 22시부터 8시까지는 추론 수요가 줄지만 전력 계약 비용은 고정되어 있으므로, Tencent는 야간 학습 가격을 낮춰 남는 전력 용량을 활용합니다.
결함을 따라 스택을 내려가는 모니터링
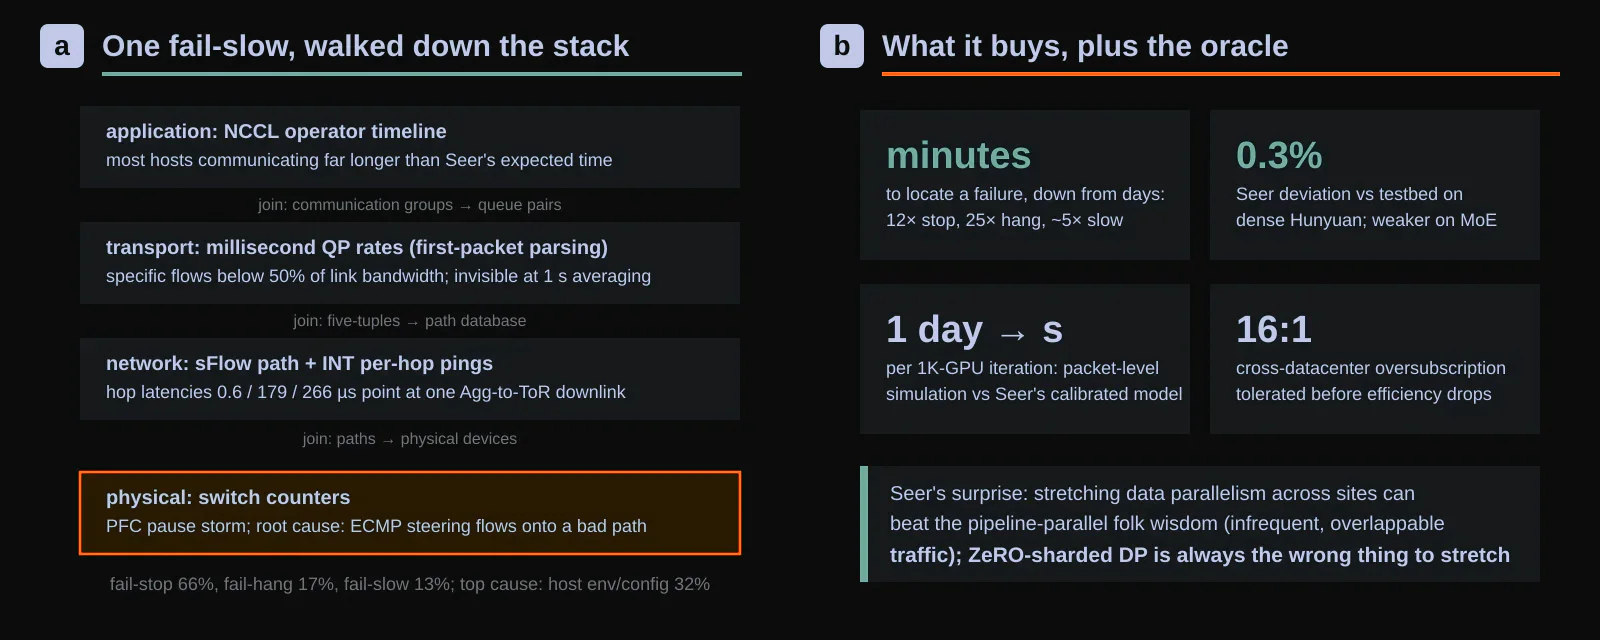
두 번째 시스템은 첫 번째 시스템이 고장 나기 때문에 존재합니다. Astral의 운영 환경 분류는 원인을 묻기 전에 겉모습부터 정리합니다. 장애의 66%는 즉시 죽는 완전 중단 장애, 4%는 시작조차 못 하는 fail-on-start이고, 나머지 30%가 비싼 종류입니다. 멈춘 채 침묵하는 멈춤 장애(17%)과 느려진 채 굴러가는 성능 저하 장애(13%)는 에러 메시지를 전혀 내지 않습니다. 원인 쪽에서는 호스트 환경·설정 문제가 32%로 선두이고 NIC 오류(15%), 사용자 코드(14%), 스위치 설정 오류(14%)가 뒤를 잇습니다. 사건 대부분이 학습 작업 안이 아니라 그 전 또는 옆에서 태어난다는 뜻입니다. 진단이 어려운 이유는 증상과 원인의 대응이 다대다이기 때문입니다. GPU 결함과 네트워크 결함이 똑같은 NCCL 타임아웃을 만들고, 멈춤은 아무것도 만들지 않습니다.
Astral의 답은 개별 센서보다 센서 사이의 연계가 핵심인 모니터링 스택입니다. 애플리케이션 계층은 반복마다 모든 NCCL 연산자의 시작과 종료를 추적해, 누가 계산 중이고 누가 통신 중이며 누가 멈췄는지를 호스트 단위로 보여 줍니다. 전송 계층은 RDMA 오류 이벤트와 함께, 더 특이하게는 큐 페어(QP)별 처리량을 밀리초 해상도로 잡습니다. RDMA 요청의 첫 패킷만 걸러 헤더의 전송 길이를 읽는 방식인데, 초 단위 평균으로는 성능이 저하된 흐름과 정상 흐름이 아예 구분되지 않는 사례를 논문이 보여 줍니다. 네트워크 계층은 sFlow 샘플링으로 흐름의 스위치별 경로를 복원하고 INT를 실은 핑으로 홉마다 지연을 잽니다. 물리 계층은 스위치 카운터(PFC, ECN, 드롭)와 호스트 내부 상태를 모읍니다. 계층 사이의 연결 관계가 이 설계의 핵심입니다. 작업의 통신 그룹은 QP로, QP는 5-튜플로, 5-튜플은 경로 데이터베이스로, 경로는 물리 장비로 이어집니다. 탐지는 호스트 간 수평 비교로 임계값에 거의 기대지 않고(집단에서 벗어난 노드를 원인 후보로 분류하며, 기대값은 아래에서 설명할 성능 예측기가 공급합니다), 진단은 이 연결 관계를 따라 물리 장비까지 내려갑니다. 운영 환경의 성능 저하 장애 하나가 전체 경로를 보여 줍니다. NCCL 타임라인이 광범위한 통신 지연을 알리고, 밀리초 QP 속도가 링크 대역폭의 절반에 못 미치는 흐름들을 찾아내고, 홉별 텔레메트리가 한 경로에서 0.6, 179, 266마이크로초의 지연을 재고, 스위치 카운터가 애그리게이션-ToR 하향 링크의 PFC 정지 폭풍을 드러내며, 최종 원인은 ECMP가 비효율적인 상류 경로로 흐름을 밀어 넣은 것으로 확정됩니다. 배치 1년 후 장애 위치 특정에 걸리는 평균 시간(MTTLF)이 며칠에서 몇 분으로 줄었습니다. 완전 중단 장애는 12×, 멈춤 장애는 25×, 성능 저하 장애는 약 5× 빨라졌습니다.
운영 기록은 시스템이 해결하지 못한 장애도 보여 줍니다. GPU 8천 장 작업의 멈춤 장애 하나는 비정상 로그를 남기지 않았고, 규모를 줄이면 증상이 사라져 이분 탐색 격리도 사용할 수 없었습니다. 수십 명의 전문가가 한 번에 한 시간씩 걸리는 일괄 교체를 26시간 동안 반복한 뒤, 유지보수 기록과 대조해 특정 NVIDIA 드라이버 버전을 원인으로 확인했습니다. 장비 한 대의 고장 난 PCIe 링크는 당시 모니터링되지 않은 채 PFC 폭풍을 일으켜 클러스터의 모든 임차 고객에게서 학습 효율을 절반으로 낮췄고, 이후 물리 계층 PCIe 감시를 추가했습니다. 장애의 32%가 호스트 환경과 설정에서 발생했기 때문에 오프라인 점검도 필요합니다. MAC 주소와 슬롯 ID를 의도한 토폴로지와 대조하는 배선 검증기와, 혼잡 제어 파라미터·드라이버 버전·NCCL 빌드가 서로 다른 임대 서버를 인도 전에 걸러내는 설정 점검을 운영합니다.
Seer: 몇 초 안에 0.3% 오차로 예측하는 방식
세 번째 시스템은 앞의 두 시스템 모두가 기준 답안을 필요로 하기 때문에 존재합니다. Astral Seer는 학습·추론 작업의 실행 타임라인을 연산자 단위로 예보합니다. 이 하드웨어와 이 네트워크에서 이번 반복은 연산자별로 얼마가 걸려야 정상인가라는 물음의 답입니다. 기존 패킷 수준 시뮬레이터는 속도에서 탈락했습니다. GPU 1천 장 작업의 반복 한 번을 ASTRA-sim은 48코어 서버에서 하루 걸려 계산했고 SimAI도 몇 시간이 필요했습니다. 반대편의 연산자 수준 도구들은 패킷 수준 현상을 아예 무시합니다. Seer는 그 사이를 가릅니다. 연산자 의존성 그래프는 PyTorch 프로파일러 트레이스를 Chakra로 변환해 얻거나, 아직 존재하지 않는 연산자를 모델링하고 싶은 연구자가 JSON 템플릿으로 직접 씁니다. 실행 시간은 순진한 공식(텐서 크기 나누기 이론 대역폭)에서 출발한 뒤 운영 환경 데이터로 보정됩니다. 연산 강도와 실측 FLOPS, 메모리 트래픽과 실측 HBM 처리량, 메시지 크기와 실측 네트워크 처리량을 각각 다항식으로 맞추는 방식이라, 패킷 수준의 현실이 시뮬레이션 대신 보정(calibration)을 통해 들어옵니다. 여기서는 임대 사업이라는 조건이 오히려 이점이 됩니다. 다양한 구성의 고객이 많으니 보정 데이터도 저절로 쌓입니다. 결과물은 몇 초 만에 타임라인을 내놓고, 사내 Hunyuan 밀집 모델에서는 테스트베드 반복 시간과의 편차가 0.3%에 들어옵니다. 약점도 숨기지 않습니다. MoE 모델은 전문가 라우팅이 데이터에 좌우되고 일부 연산자가 아직 미보정이라 예보가 더 어긋납니다.
두 사례 연구는 이 도구가 실제 설계 판단에 어떤 정보를 주는지 보여 줍니다. GPU 수급 때문에 여러 데이터센터에 걸쳐 학습해야 할 때 어느 병렬화를 경계 너머로 보낼 것인가라는 물음에, Seer는 트래픽이 가장 적은 파이프라인 병렬화를 선택해야 한다는 통념과 다른 결과를 냅니다. 데이터 병렬 트래픽은 양이 커도 빈도가 낮고 연산과 겹치기 쉬워 여러 구성에서 파이프라인 병렬화보다 효율적입니다. 반면 ZeRO 방식으로 분할한 데이터 병렬화는 어떤 경우에도 사이트 간 링크 너머로 확장해서는 안 되며, 사이트 간 대역폭 과약정이 대략 16:1을 넘기 전까지는 전체 효율이 유지됩니다. 호스트 내 도메인을 얼마나 키울 가치가 있는가라는 물음에는, 스케일업 논쟁이 정성적으로 다룬 차이를 Seer가 정량화합니다. MoE 학습·추론은 더 큰 NVSwitch 도메인에서 큰 이득을 얻지만 밀집 모델의 이득은 훨씬 작습니다.
Astral은 패브릭과 시설을 하나의 성능 목표로 묶은 구조
같은 SIGCOMM에 실린 InfiniteHBD[7]와 비교하면 Astral이 선택한 설계 조건이 더 분명해집니다. InfiniteHBD는 스위치를 트랜시버 모듈에 넣어 특정 집합 통신에 맞춘 저비용 링을 구성합니다. Astral은 여러 임차 고객의 작업을 예측하기 어려운 클라우드 환경을 위해 모든 계층의 집계 대역폭을 같게 맞춥니다. 비용이 더 들지만 작업 배치에 따른 네트워크 성능 편차를 줄일 수 있습니다. 모니터링 설계는 ByteRobust와도 연결됩니다. ByteRobust가 의심 장비를 먼저 격리해 학습을 재개하는 데 집중한다면, Astral은 여러 계층의 텔레메트리를 연결해 원인 후보를 물리 장비까지 좁힙니다. 두 기능이 함께 있어야 복구와 정밀 진단을 모두 수행할 수 있습니다. Seer의 기여는 단순한 예측 모델보다 제어 루프 안에서의 역할에 있습니다. 보정된 예측값 하나가 이상 판정 기준, 데이터센터 간 대역폭 배분, 다음 호스트 내 도메인의 크기를 함께 정합니다. 다만 모든 결과는 단일 장비군에서 자체 보고됐습니다. GPU 51만 2천 장은 설계 용량이고 실제 배치 규모는 12만 8천 장이며, 레일 최적화의 효과는 집합 통신 라이브러리가 트래픽을 같은 레일 안에 유지한다는 조건에 달려 있습니다. 이 논문의 핵심은 스위치 ASIC의 해시 함수부터 냉각 기류까지 하나의 성능 목표에 맞춰 설계하고, 그 결과를 대규모 운영 환경에서 검증했다는 점입니다.
출처와 저작권 안내
이 글은 Silicon & Systems가 작성한 편집 요약으로, 아래에 인용한 논문의 논지를 우리 표현으로 재서술한 것입니다. 원문의 문장, 도판, 표는 이 글에 재사용하지 않았으며, 이 페이지의 도판은 모두 이 요약을 위해 새로 제작했습니다. 논문은 SIGCOMM 2025에서 발표되었고, 확정본은 Proceedings of the ACM SIGCOMM 2025 Conference에 실려 있습니다. (c) 2025 the authors, publication rights licensed to ACM.