일반적인 AI 실리콘 논문은 다이 사진, 피크 TOPS, 벤치마크 결과를 중심으로 구성됩니다. 메타의 ISCA 2025 산업 트랙 논문은 수십억 사용자의 랭킹·추천 추론에 투입한 2세대 칩 MTIA 2i를 다루면서 운영 과정까지 공개합니다[1]. 저자들은 자체 칩의 경제성이 아키텍처만으로 결정되지 않는다고 설명합니다. 모델과 실리콘의 공동 설계, 변화하는 모델을 수용할 유연성, 자체 하드웨어의 장애와 소프트웨어를 직접 관리할 운영 체계가 함께 필요합니다. 지금까지 배포한 모델을 기준으로 MTIA 2i는 GPU보다 총소유비용(TCO)을 평균 44% 줄였습니다. 논문의 나머지 부분은 이 수치를 만든 설계와 운영 조건을 구체적으로 설명합니다.
아래는 그 논지를 우리 표현으로 정리한 것입니다.
HBM 자리가 비어 있는 메모리 계층
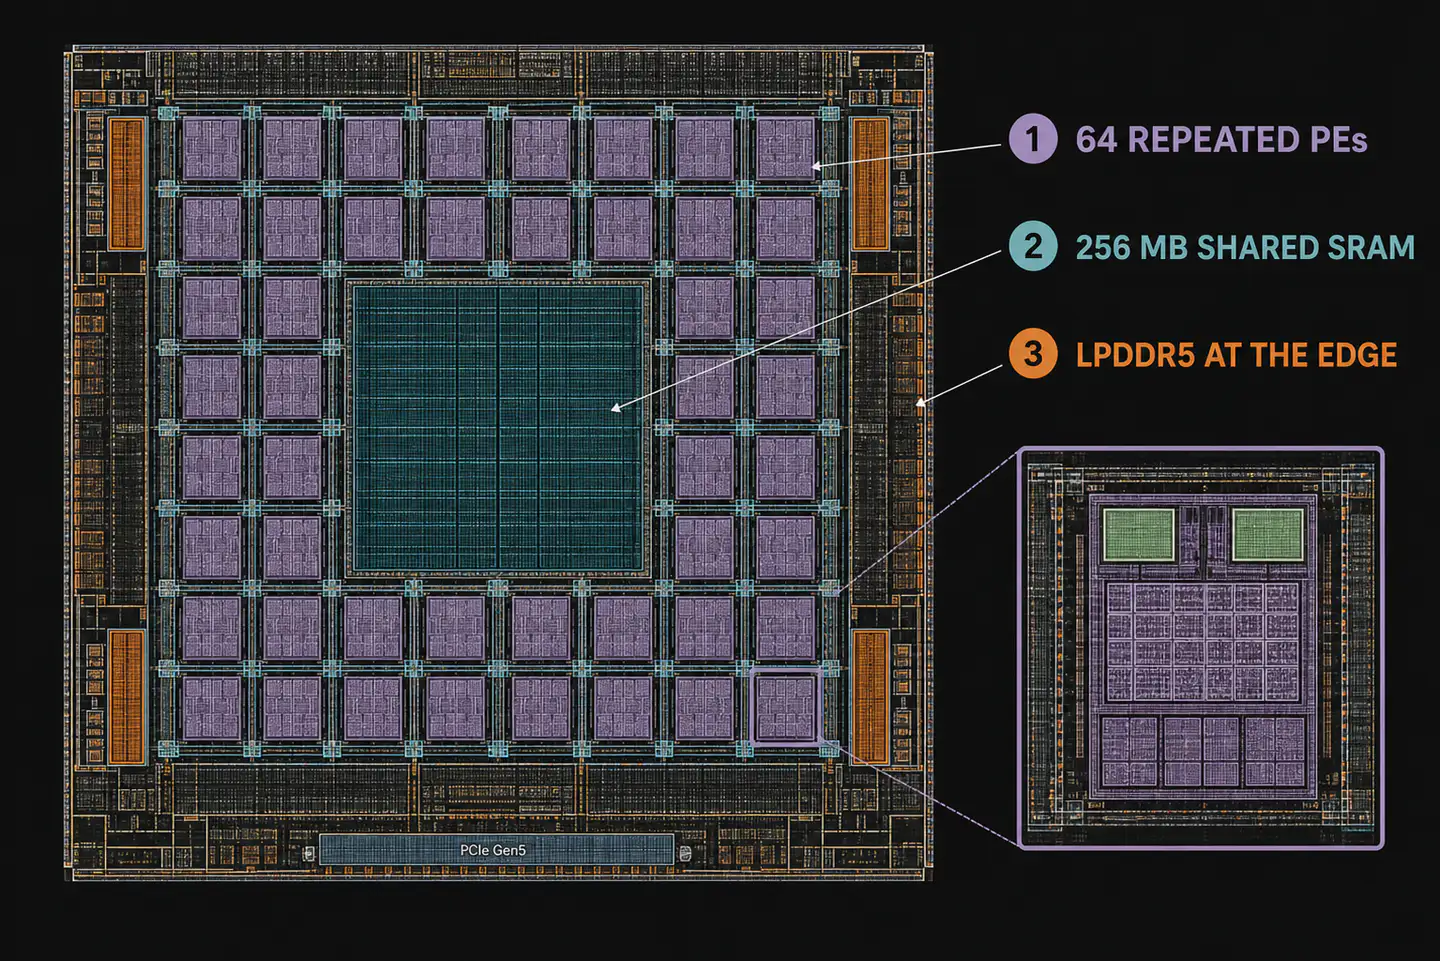
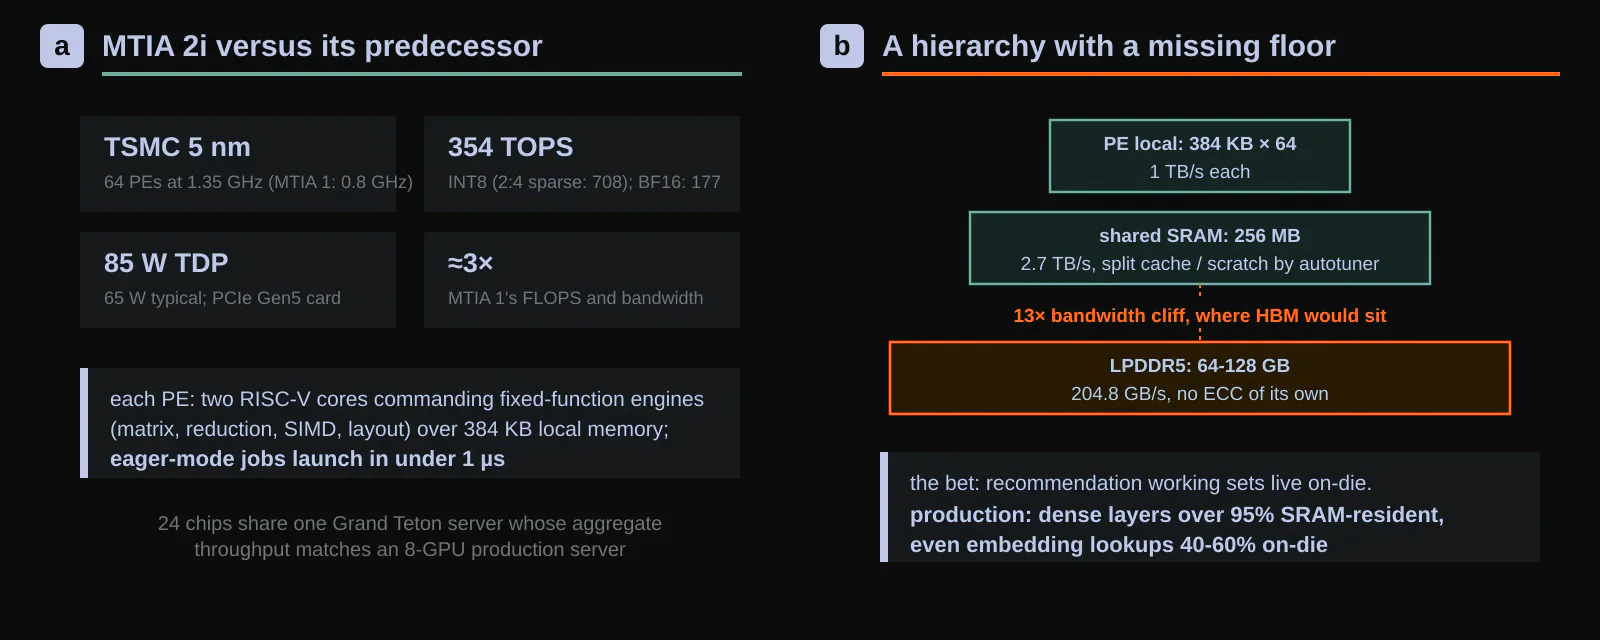
MTIA 2i는 TSMC 5 nm 다이에 1.35 GHz로 동작하는 프로세싱 엘리먼트(PE) 64개를 얹은 칩입니다. PE마다 RISC-V 코어 둘과 행렬곱·리덕션·SIMD·레이아웃 변환용 고정 기능 엔진들이 짝을 이룹니다. 85 W 전력 한도에서 354 INT8 TOPS(구조적 희소성 적용 시 708)를 내며, 연산·NoC 대역폭·SRAM 대역폭은 모두 2023년의 전작[2]보다 약 3배 높습니다.
설계의 핵심은 메모리 계층입니다. HBM 대신 2.7 TB/s의 온다이 SRAM 256 MB를 204.8 GB/s의 LPDDR5 64~128 GB 위에 두어 두 계층 사이에 대역폭 차이가 13배 생깁니다. 추천 모델은 대형 트랜스포머보다 지역성이 높아 작업 집합의 상당 부분을 SRAM에 둘 수 있다는 판단이며, 운영 결과도 이를 뒷받침합니다. 밀집 레이어의 SRAM 상주율은 95% 이상이고, 접근이 불규칙한 임베딩 조회도 40~60%가 온다이에 머뭅니다.
SRAM을 하드웨어 관리 캐시와 소프트웨어 고정 스크래치로 나누는 비율은 소프트웨어가 정합니다. 오토튜닝 프레임워크는 성능 데이터베이스의 근사 최근접 탐색으로 커널 변형을 골라 전수 탐색보다 1,000배 빠르게 후보를 찾고, 트래픽 재생으로 배치 크기를 정합니다. 모델마다 사람이 직접 조정하기에는 운영 모델 수가 너무 많기 때문입니다. 칩 24개는 Grand Teton 서버 한 대를 채우며 합산 성능은 GPU 8장 서버와 비슷합니다. 작은 칩 단위는 수요가 변할 때 필요 이상의 큰 가속기를 유휴 상태로 두지 않고 용량을 더 세밀하게 배분할 수 있게 합니다.
데이터시트가 알려 주지 않는 것들
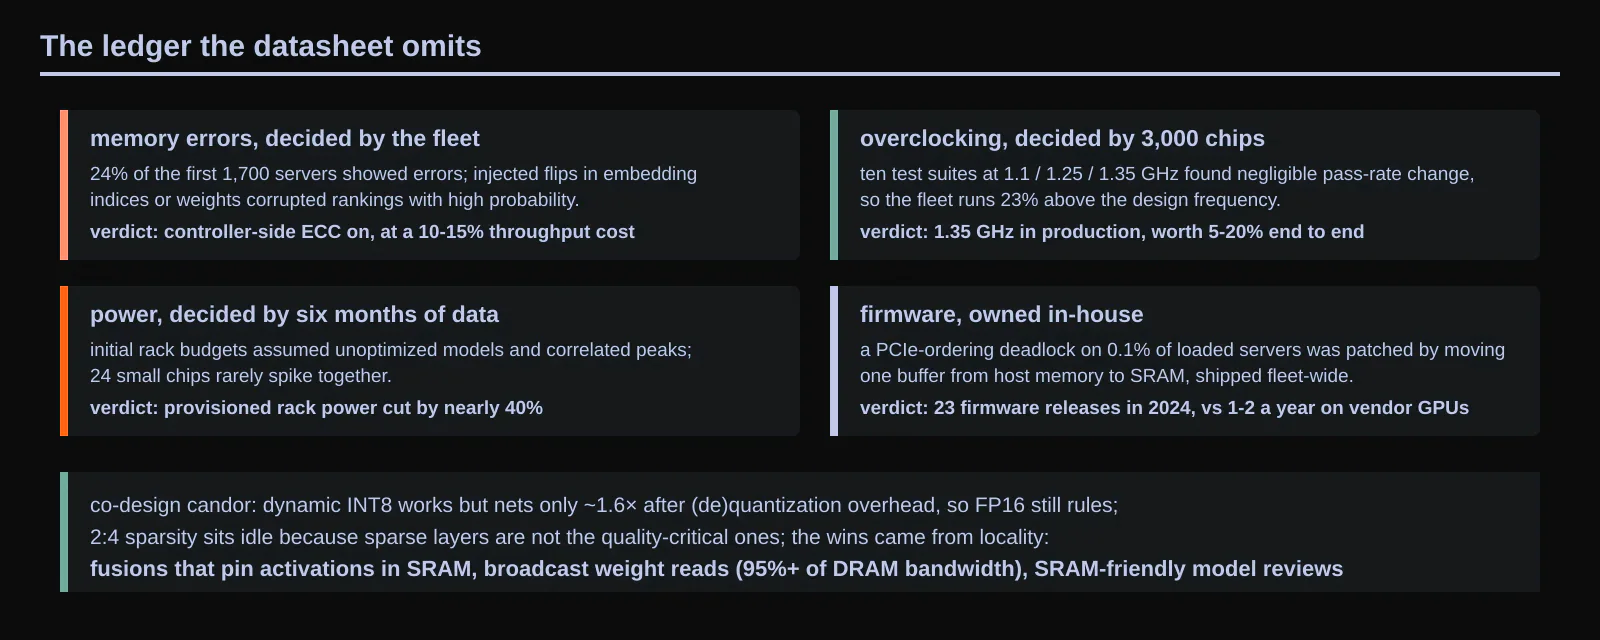
논문의 핵심 기여는 MTIA 2i를 운영 환경에 적용하며 설계 결정을 검증한 과정입니다. LPDDR에는 기본 ECC가 없었고, 설계 당시 Meta에는 추론이 비트 플립을 허용할 수 있는지 판단할 장비군 데이터가 없었습니다. 초기 서버 1,700대 중 24%에서 메모리 오류가 관측됐으며, 오류 주입 실험에서는 임베딩 인덱스나 가중치의 특정 비트가 뒤집힐 때 NaN이나 순위 결과 오류가 높은 확률로 발생했습니다. 제품 팀은 정확도 저하를 허용하지 않았고 컨트롤러 측 ECC를 사용했습니다. 이 선택으로 처리량이 10~15% 감소했으며, 논문의 성능 수치는 이 감소를 포함합니다. 반면 칩 약 3,000개에 열 가지 시험을 적용한 결과 1.1 GHz 설계점보다 높은 주파수에서도 여유가 확인되어 운영 주파수를 1.35 GHz로 높였고 종단 간 성능은 5~20% 향상됐습니다. 6개월의 전력 데이터에서는 칩 24개가 동시에 최대 전력을 사용하는 경우가 드물어 랙 전력 예산을 약 40% 낮췄습니다. 자체 펌웨어를 사용한 운영도 중요합니다. 고부하 서버의 0.1%에서 나타난 PCIe 순서 규칙 관련 교착은 버퍼 하나를 호스트 메모리에서 SRAM으로 옮겨 완화했으며, 2024년에는 장비군 전체에 펌웨어를 23회 배포했습니다. 같은 팀이 서드파티 GPU에 적용한 펌웨어 업데이트는 연 1~2회였습니다.
모델-칩 공동 설계는 효과가 없었던 기능까지 함께 보여 줍니다. 동적 INT8 양자화는 동작하지만(행 단위 활성값과 정적 INT8 가중치로 FP16에 가까운 품질) 양자화·역양자화 오버헤드 때문에 DPE의 2배 이점이 큰 레이어에서는 약 1.6배로 줄었습니다. 운영 환경에서는 여전히 FP16이 주로 사용됩니다. 2:4 희소성 경로도 활용률이 낮습니다. 희소성이 충분한 레이어와 모델 품질을 좌우하는 레이어가 일치하지 않기 때문입니다.
실제 성능을 만든 것은 데이터 지역성 최적화였습니다. 연산자 융합으로 활성값 버퍼를 스크래치 SRAM에 유지하고, PE 64개가 가중치 트래픽을 두고 경쟁하지 않도록 브로드캐스트 읽기를 사용해 불리한 패턴에서도 DRAM 대역폭의 95% 이상을 달성했습니다. SRAM 상주 조건을 깨는 모델 변경은 그대로 받지 않고, ML 엔지니어에게 같은 목적을 달성할 다른 구조를 제안했습니다. 8개월간 진행한 이관 사례에서 Meta 매출 상위 5위 안의 모델은 처음에는 GPU 비용 효율의 50%에 그쳤습니다. 이후 모델 복잡도가 6.7배 늘었지만 최종 배포 시점에는 GPU 대비 180%의 비용 효율을 달성했습니다.
운영 환경에서 확인한 결과
샘플당 15~1,000 MFLOPS인 운영 환경 모델 9개에서 MTIA 2i의 비용 효율은 GPU 대비 0.9~2.1배였고, 평균 총소유비용은 44% 낮았습니다. 와트당 성능은 GPU 대비 0.8~1.2배였으며, 저자들은 GPU가 오랫동안 전력 효율을 최적화해 온 결과로 해석합니다. 효율을 결정한 것은 모델 복잡도 자체보다 SRAM에 활성값을 유지할 수 있는지였습니다. 큰 배치에서도 활성값이 스크래치 SRAM에 남는 모델은 유리했고, 용량을 넘는 모델은 성능이 낮았습니다. 같은 학습 모델을 MTIA 장비군과 GPU 장비군에 나눠 실제 트래픽을 처리했기 때문에 지연뿐 아니라 광고 매출과 예측 품질도 비교할 수 있었습니다. 적용 범위도 분명합니다. Llama급 LLM은 적합하지 않았고, 8B 모델은 프리필 목표를 지켰지만 LPDDR 대역폭에 묶인 디코드가 토큰당 60 ms 목표를 넘었습니다. 샘플당 약 2 GFLOPS를 넘는 모델도 SRAM 중심 설계의 범위를 벗어났습니다. 수동 최적화 비용을 감당하기 어려운 소형 모델에는 CUDA 생태계가 여전히 유리했습니다.
특화 가속기의 경쟁력은 선별과 운영에서 나오는 이유
이 논문의 핵심은 범용 GPU보다 높은 피크 성능이 아닙니다. Vistara가 특정 메모리 병목을 겨냥해 CXL 확장 장치를 만든 사례라면, MTIA 2i는 대규모 추천 작업의 실제 분포를 기준으로 연산 장치를 좁게 최적화한 사례입니다. 딥시크의 하드웨어 요구사항[6]처럼 더 많은 HBM과 인터커넥트가 필요한 작업도 있지만, Meta의 추천 장비군에는 LPDDR의 낮은 대역폭을 SRAM으로 보완하는 편이 더 경제적인 모델이 충분히 많았습니다.
평균 44%의 총소유비용 절감은 모든 모델을 MTIA로 옮긴 결과가 아닙니다. 설계 범위를 벗어난 모델은 GPU에 남기고, 이관 가능한 모델만 MTIA에서 운영한 결과입니다. 따라서 자체 실리콘의 경쟁력은 칩 하나로 모든 작업을 처리하는 데 있지 않습니다. 어떤 작업에서 이길 수 있는지 파악하는 장비군 규모의 분석, 모델 변화에 맞춘 오토튜닝, 실제 서비스 A/B 검증, 주 단위 펌웨어 배포가 함께 있어야 합니다. 경쟁사가 복제하기 어려운 부분도 PE 배열보다 이 운영 체계입니다.
HBM을 뺀 선택에는 작업 경계가 있는 구조
가중치, 활성값, 임베딩, 중간 상태가 설계한 계층에 맞는 모델에서는 다른 메모리 구성이 비용을 낮출 수 있습니다. HBM 용량과 대역폭에 의존하는 작업에는 맞지 않을 수 있습니다. HBM이 불필요하다는 뜻이 아니라 운영 모델 포트폴리오의 지역성과 재사용을 측정해 가속기를 설계했다는 뜻입니다.
모델을 매개변수와 임베딩 크기, 접근 패턴, 배치 가능성, 지연 목표, 갱신 주기로 나누고 온칩 메모리, 장치 DRAM, 호스트, 네트워크에 바이트를 배치해야 합니다. 모델이 커지거나 희소성이 바뀌면 유출 트래픽, 메모리 대기, 남은 용량을 보고 압축, 재배치, 다른 가속기 이동을 결정해야 합니다.
제품화는 반복 가능성의 주장
맞춤형 가속기는 배포, 스케줄링, 진단, 업데이트, 장비군 운영이 반복 가능해야 가치가 생깁니다. 대상이 될 수 있는 모델, 검증을 마친 모델, 실제 규모로 운영한 모델을 나눠 보고하고 다른 장치로 돌아간 비율과 원인, 새 모델 검증 시간, 소프트웨어 갱신 뒤 성능 변화를 기록해야 합니다.
설치 수량보다 모델 호환성, 호스트 조합, 네트워크 지역성, 유지보수를 반영한 배치 가능 용량을 봐야 합니다. 이용률도 대상 수요와 완료 추론 작업 옆에 있어야 포트폴리오가 좁아 높은 값인지, 순간 수요를 위해 예비를 둔 낮은 값인지 구분할 수 있습니다.
총비용에는 함께 쓰는 시스템이 들어가는 항목
호스트 CPU, 메모리, 네트워크, 스토리지, 보드 전력, 냉각, 소프트웨어 개발, 예비 용량을 모두 포함해 같은 모델, 품질, 요청 분포, 지연 목표를 비교해야 합니다. 전력은 서버 입력에서 측정하고 장애 복구와 단편화 뒤의 사용 가능 용량을 비용에 넣어야 합니다. 44% 절감은 평가한 운영 범위의 근거이며 모든 AI 작업에 적용되는 배수가 아닙니다.
공동 설계에는 이동 경로가 남아야 할 이유
모델과 실리콘은 다른 속도로 바뀝니다. 안정된 중간 표현, 컴파일러 대체 경로, 수치 검증, 호환 서비스 인터페이스가 있어야 단계적으로 도입할 수 있습니다. 모델이 메모리나 연산 범위를 벗어나면 제품 동작을 바꾸지 않고 다른 가속기로 이동할 수 있어야 합니다. 공급과 보드·펌웨어 버전도 서로 다른 자원으로 추적해야 장비군 단편화를 숨기지 않습니다.
MTIA 2i는 포트폴리오 규모에서 특화를 운영한 시스템 결과입니다. 오래 남는 교훈은 HBM을 뺐다는 사실보다 대상 모델을 명시하고 전체 시스템을 측정하며, 관측과 대체 경로를 남기고, 모델과 공급이 바뀔 때 배치를 갱신한 과정에 있습니다.
도입은 수치 정합성 확인, 제한된 트래픽, 운영 확대의 세 단계로 나누는 편이 안전합니다. 각 단계에서 같은 요청 분포와 품질 목표를 유지하고, 지연 분포, 서버 입력 전력, 호스트 병목, 다른 장치로 돌아간 비율을 기록해야 합니다. 새 모델이 범위를 벗어날 때 대체 장치로 옮기는 경로도 정기적으로 시험해야 맞춤형 실리콘이 모델 발전을 막지 않습니다.
공급망도 하나의 장비군으로 단순화하면 안 됩니다. 보드 개정, 호스트 조합, 펌웨어, 메모리 구성이 다르면 성능과 배치 가능성이 달라질 수 있습니다. 충분한 근거가 쌓이기 전에는 서로 다른 자원 유형으로 추적하고, 대체 부품이 같은 완료 작업 비용을 내는지 확인해야 합니다. 특화의 이득은 다이를 싸게 만드는 데서 끝나지 않고 필요한 수량을 같은 운영 계약으로 계속 공급할 때 완성됩니다.
최종 운영 지표는 설치한 MTIA 수보다 대상 모델 가운데 실제로 배치한 비율, SLO 안에서 완료한 요청, 장치 시간당 유효 추론, 대체 장치로 돌아간 원인이어야 합니다. 이 네 값이 함께 움직여야 아키텍처와 소프트웨어, 수요가 같은 방향으로 정렬됐다고 판단할 수 있습니다.
출처와 저작권 안내
이 글은 Silicon & Systems가 작성한 편집 요약으로, 아래에 인용한 논문의 논지를 우리 표현으로 재서술한 것입니다. 원문의 문장, 도판, 표는 이 글에 재사용하지 않았으며, 이 페이지의 도판은 모두 이 요약을 위해 새로 제작했습니다. 논문은 ISCA 2025 산업 트랙에서 발표되었고 CC BY 4.0 라이선스로 공개되어 있습니다. (c) 2025 the authors.