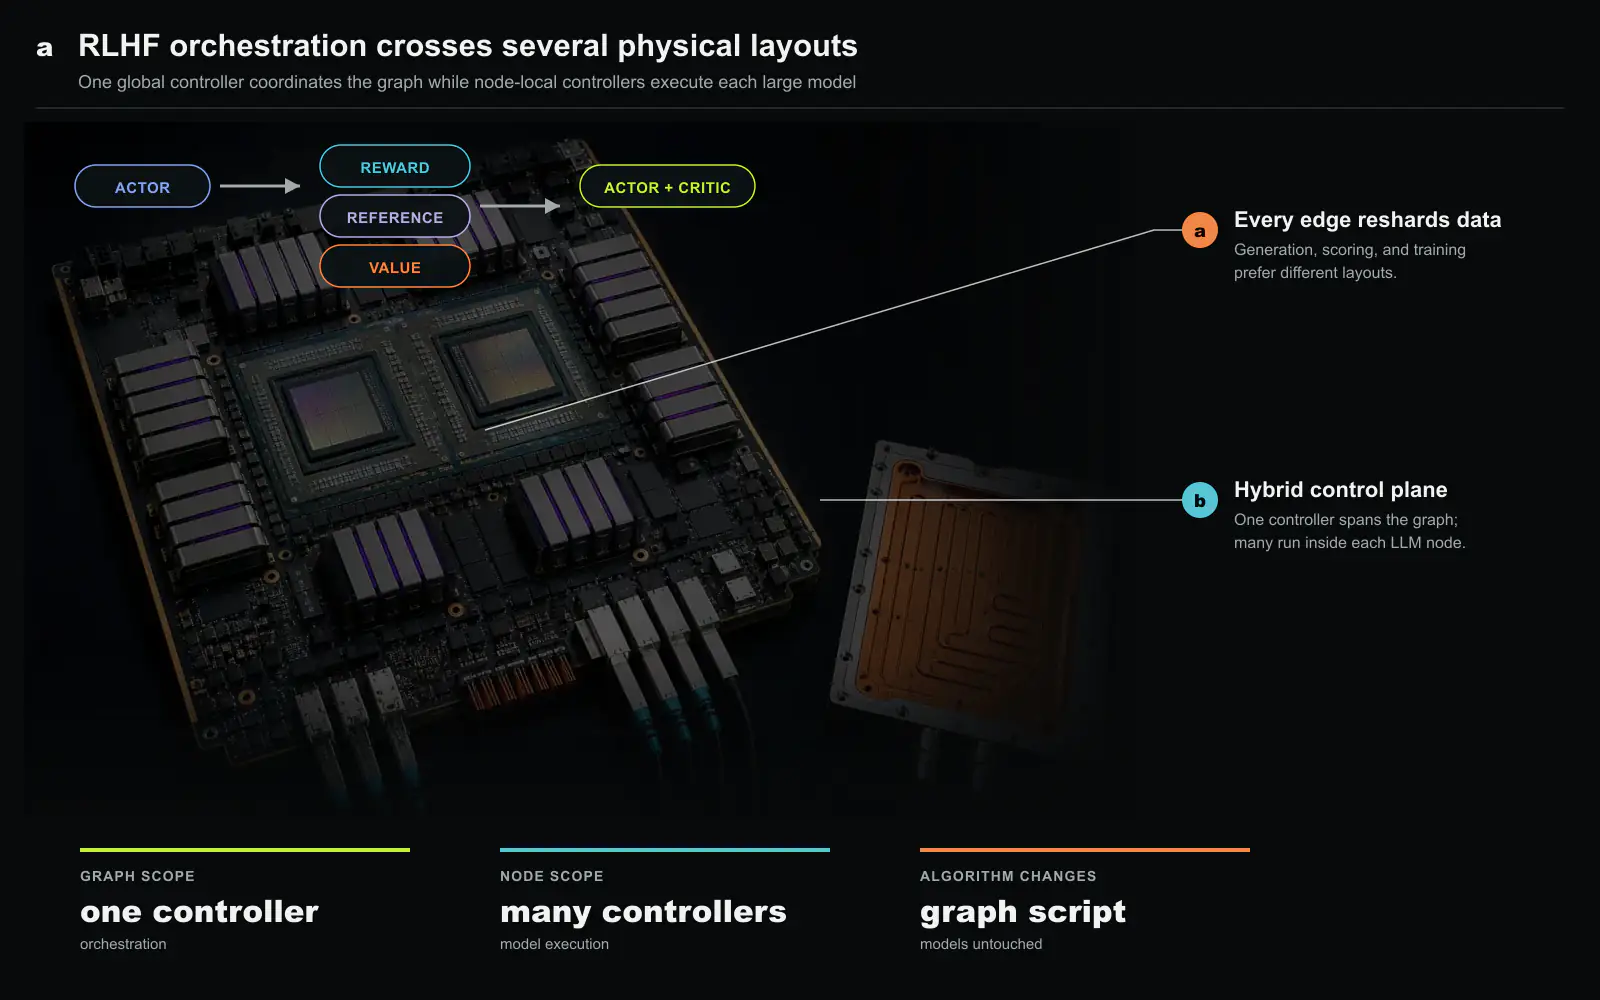
인간 피드백 강화학습(RLHF)의 개념적 데이터 흐름은 단순합니다. 액터가 응답을 생성하고, 크리틱과 레퍼런스 정책, 리워드 모델이 채점하고, 액터와 크리틱이 그 결과로 배웁니다. 그러나 실제 GPU 클러스터에서는 구성이 복잡해집니다. 상자 하나하나가 저마다의 텐서·파이프라인·데이터 병렬화로 분할된 분산 LLM이고, 화살표 하나하나가 서로 다른 두 분할 배치 사이의 다대다 재배치이기 때문입니다. ByteDance와 홍콩대는 EuroSys 2025에서 이 문제를 해결하는 시스템 구조를 발표했고[1], 그 해법은 이후 실제 인프라로 채택되었습니다. HybridFlow는 오픈소스 프레임워크 verl의 기반 설계이며, 현재 여러 추론 모델이 이 구조 위에서 RL 사후학습을 수행합니다. 논문은 당시 RLHF 시스템보다 처리량을 1.53~20.57배 높였다고 보고합니다. 더 지속적인 기여는 새 RL 알고리즘을 전체 시스템 재작성 없이 몇 줄의 수정으로 표현하게 만든 프로그래밍 모델입니다.
아래는 그 논지를 우리 표현으로 정리한 것입니다.
반씩만 맞는 두 패러다임
분산 ML이 데이터플로를 돌리는 방식은 둘입니다. 단일 컨트롤러는 그래프 전체를 소유하고 모든 연산을 원격 워커에 내려보냅니다. 최대로 유연하지만, 노드가 수십억 연산자의 LLM이면 스텝마다 디스패치 메시지가 클러스터를 건너다니느라 파멸적으로 수다스러워집니다. 멀티 컨트롤러는 장치마다 자기 프로그램을 줍니다. 제어가 CPU에서 GPU로 가는 빠른 경로에 머무니 디스패치 비용이 사라지고, Megatron류 학습과 현대 서빙 엔진이 모두 이 방식인 이유가 그것입니다. 대신 데이터플로 논리가 어디에도 살지 않게 됩니다. 각 모델의 스크립트가 이웃으로의 송수신을 직접 코딩해야 하므로, RLHF 그래프의 간선 하나를 바꾸려면 의존하는 모든 모델의 프로그램을 고쳐야 합니다. 2024년 세대의 RLHF 시스템들(DeepSpeed-Chat, OpenRLHF, NeMo-Aligner)[2][3][4]은 모두 멀티 컨트롤러 쪽을 골랐고 그 경직성을 물려받았습니다. 배치 계획 하나, 실행 패턴 하나, PPO 하나, 그리고 통신과 연산이 한데 꼬인 코드베이스입니다.
HybridFlow는 단일 컨트롤러와 다중 컨트롤러 중 하나를 시스템 전체에 강제할 필요가 없다고 판단합니다. RLHF 그래프의 노드는 몇 개뿐이므로 노드 수준을 조정하는 단일 컨트롤러의 비용은 작습니다. 비용이 컸던 부분은 노드 안에서 수많은 연산자를 일일이 전달하는 과정입니다. 그래서 이 프레임워크는 그래프 위에 Ray 기반 컨트롤러 하나를 두고[6], 각 모델 안에서는 다중 컨트롤러 워커 그룹을 실행합니다. 모델 클래스(학습은 Megatron-LM, FSDP, DeepSpeed 위에서, 생성은 vLLM 위에서 실행)가 분산 연산을 generate_sequences나 update_actor 같은 원시 호출 뒤에 캡슐화하고, 모든 호출에 전송 프로토콜을 붙입니다. 모델 자체의 분할 방식에 맞춰 출력을 모으는 collect 함수와 소비자 모델의 분할 방식에 맞춰 입력을 분산하는 distribute 함수입니다. 데이터는 GPU 사이에서 직접 이동하고 컨트롤러에는 비동기 결과 객체만 전달됩니다. 프로그래밍 복잡도는 코드 줄 수에서 드러납니다. PPO의 컨트롤러 스크립트는 8줄이고[5], Safe-RLHF는 5줄을 더하며, ReMax는 크리틱을 제거하고 생성 호출 하나를 추가합니다. 어느 경우에도 모델 내부는 수정하지 않습니다.
중복 변환 없이 액터를 옮기기
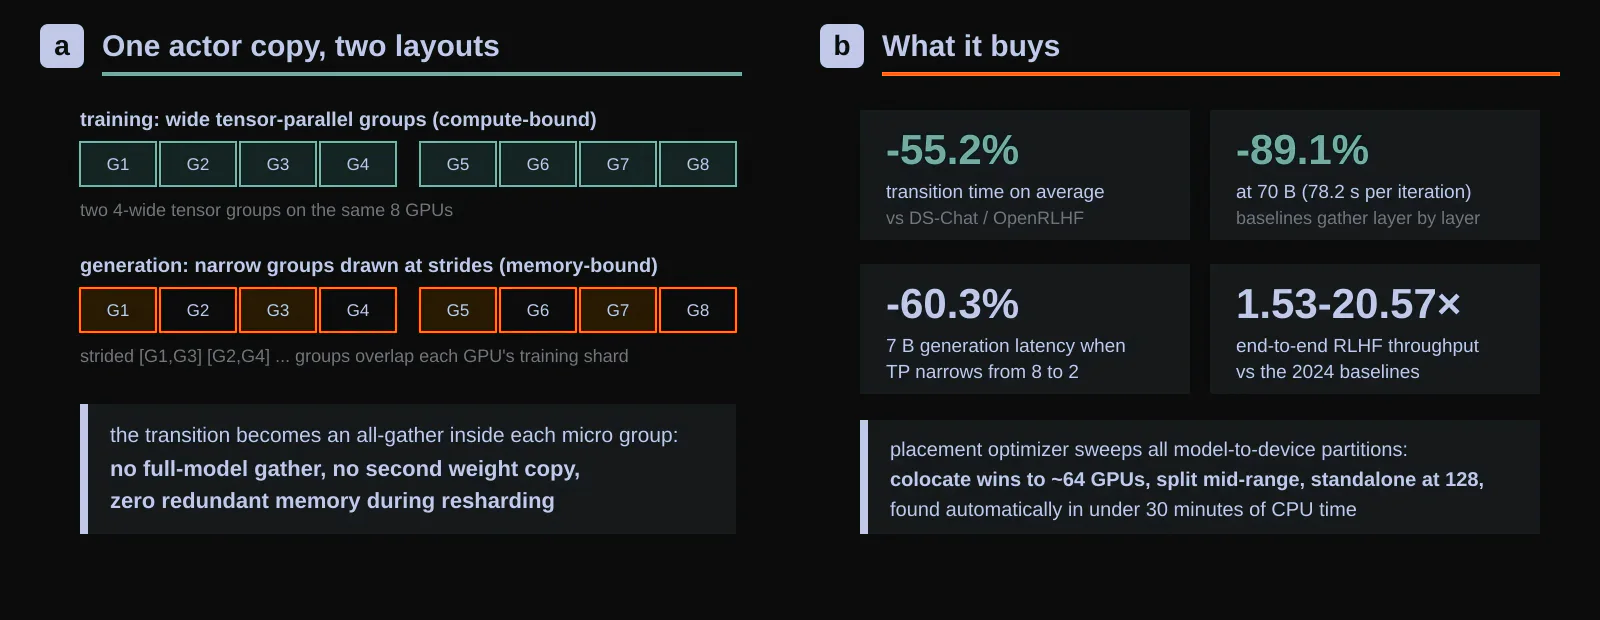
가장 무거운 노드는 액터입니다. 매 반복에서 학습(연산 위주, 넓은 모델 병렬화를 원함)과 생성(메모리 위주, 작은 복제본 여럿을 원함)을 둘 다 합니다. 기존 시스템들은 이 불일치를 서로 다른 세 방식으로 서투르게 다뤘습니다. NeMo-Aligner는 학습 배치를 생성에도 그대로 써서 GPU를 놀렸고, OpenRLHF는 액터 사본 둘을 다른 장치에 두고 반복마다 가중치를 동기화했으며, DeepSpeed-Chat은 같은 장치에서 리샤딩하되 그 과정에서 모든 GPU에 전체 모델을 모았는데, 70B 모델이면 이 전송이 반복 시간의 3분의 1을 먹을 수 있습니다. HybridFlow의 3D-HybridEngine은 가중치 사본 하나를 한 GPU 집합에 두고, 학습 배치(p-t-d)와 더 작은 텐서 병렬 그룹 + 마이크로 데이터 병렬 복제본의 생성 배치 사이를 제자리에서 리샤딩합니다. 요령은 생성 그룹을 긋는 방식에 있습니다. 각 GPU의 생성 샤드가 자기 학습 샤드와 겹치도록 랭크를 일정 간격으로 배정해서, 전환이 마이크로 그룹 내부에 갇힌 all-gather가 되고, 중복 가중치는 어디에도 상주하지 않습니다. 베이스라인 대비 전환 시간이 평균 55.2% 줄고 70B에서는 최대 89.1%(반복당 78.2초)까지 줄며, 생성 텐서 병렬을 좁힐 자유가 바로 이득으로 돌아옵니다. 학습 폭에서 2-way로 내리면 7B 생성 지연이 60.3% 줄어듭니다.
남은 자유도인 배치는 관례가 아니라 최적화기로 결정합니다. 모델을 가상 자원 풀에 묶는 방식이라 모델과 장치 분할의 모든 조합을 표현할 수 있습니다. 자동 매핑 알고리즘은 가능한 배치를 열거하고(PPO의 모델 4개라면 15가지), 함께 배치할 모델 집합마다 메모리 하한으로 GPU 수를 정한 뒤, 시뮬레이터로 모델별 병렬화를 탐색해 반복 시간이 가장 짧은 계획을 고릅니다. 이 탐색은 고정 배치 시스템이 활용하지 못했던 규모별 성능 차이를 드러냅니다. 대략 GPU 64장까지는 모든 모델을 같은 GPU 집합에 배치할 때 가장 빠르고, 중간 규모에서는 학습 모델과 채점 모델을 나눌 때 유리하며, GPU 128장에서는 완전히 독립적으로 배치할 때 가장 빠릅니다. 최적화기는 이 전환 지점을 CPU 시간 30분 안에 자동으로 찾습니다.
시험에서 확인한 성능과 적용 조건
A100 128장에서 7B~70B Llama 계열 모델로 평가했을 때 HybridFlow는 PPO 처리량 기준 DeepSpeed-Chat보다 평균 3.67배(최대 7.84배), OpenRLHF보다 평균 3.25배(최대 5.93배), NeMo-Aligner보다 평균 12.52배(최대 20.57배) 빨랐습니다. ReMax와 Safe-RLHF에서도 비슷한 차이가 나타났고, 전환 오버헤드가 비교 시스템의 실행 시간을 지배하는 70B에서 평균 이득이 가장 컸습니다(9.64배). 강한 확장 효율은 알고리즘과 모델 크기 전반에서 평균 66.8%였습니다. 다만 평가 조건을 함께 봐야 합니다. 주요 실험에서는 네 모델의 크기가 같고, 연속 배칭을 지원하지 않는 비교 시스템과 조건을 맞추기 위해 응답 길이를 고정했습니다. 최대 배율은 KV 캐시가 없는 생성 엔진 때문에 반복 시간의 최대 81.2%를 생성에 쓰던 NeMo-Aligner를 상대로 측정했습니다. 따라서 최대 배율 하나보다 모델마다 작업 특성에 맞는 병렬화와 배치를 적용했을 때 모든 비교 시스템보다 일관되게 높은 처리량을 보였다는 결과가 중요합니다.
최적 배치는 작업 조건과 함께 기록해야 할 이유
HybridFlow의 성능을 다른 환경으로 옮기려면 탐색 결과보다 탐색 조건을 먼저 보존해야 합니다. 모델별 메모리 하한, 장치 간 대역폭, 생성 길이, 채점 모델의 비율이 바뀌면 어느 모델을 함께 둘지에 대한 답도 달라집니다. 따라서 운영자는 선택된 배치 하나만 기록할 것이 아니라 비교에서 탈락한 후보와 각 후보의 병목도 남겨야 합니다. 그래야 GPU 세대나 정책이 바뀌었을 때 과거의 최적 배치를 그대로 답습하지 않고 필요한 범위만 다시 탐색할 수 있습니다.
또한 재배치는 무상으로 일어나지 않습니다. 모델 상태를 옮기는 시간, 통신 그룹을 다시 만드는 시간, 진행 중 요청을 비우는 시간까지 반복 시간에 포함해야 합니다. 짧은 실험에서 이기는 구성이 장시간 운영에서도 유리하려면, 예상한 부하 변화로 얻는 이득이 전환 비용과 실패 위험을 꾸준히 넘어야 합니다. 이 기준은 HybridFlow를 정적인 성능 최적화가 아니라 배치 수명 전체를 다루는 제어 문제로 읽게 합니다.
2026년 시점에서 이 논문의 가치는 벤치마크보다 구현체의 확장성에서 확인됩니다. verl은 공개 RL 사후학습에서 널리 쓰이는 기반이 됐고, 하이브리드 제어와 재분할, 액터의 학습·생성 전환 구조는 새로운 알고리즘을 전체 재작성 없이 추가할 수 있게 했습니다. 논문이 보고한 1.53~20.57배의 처리량은 당시 비교군에 대한 결과이지만, 같은 구조가 여러 세대의 알고리즘을 수용했다는 사실은 더 지속적인 근거입니다.
시스템 경계도 달라졌습니다. RL 사후학습에서는 생성 속도가 곧 학습 진도를 제한하므로, 서빙과 학습을 별도 시스템으로 최적화할 수 없습니다. 같은 액터 가중치를 학습용 분할과 생성용 분할 사이에서 얼마나 적은 비용으로 바꾸는지가 전체 처리량을 결정합니다. 이 판단은 RLHF에만 머물지 않습니다. 에이전트 파이프라인이나 여러 모델을 연결한 시스템처럼 작업 그래프는 작지만 각 단계가 거대한 경우에도, 전체 흐름의 유연성과 개별 단계의 효율을 분리해 설계하는 방식이 필요합니다.
배치가 달라져도 학습 의미는 같아야 할 이유
유연한 배치가 가치 있으려면 장치 구성이 바뀌어도 학습 절차는 달라지지 않아야 합니다. PPO, ReMax, Safe-RLHF는 호출하는 모델과 간선을 지나는 텐서가 다르지만, 배치 최적화기가 샘플의 식별자, 모델 버전, 갱신 순서를 바꿔서는 안 됩니다. HybridFlow의 전송 프로토콜은 단순한 복사 함수가 아니라 한 샤딩의 논리 배치를 다음 모델의 샤딩으로 정확히 복원한다는 계약입니다.
액터 경계에서는 이 계약이 특히 중요합니다. 생성은 좁은 복제본 여러 개를 쓰고 학습은 넓은 분할을 쓰더라도, 각 궤적이 어느 액터 버전에서 나왔는지 보존해야 합니다. 비동기 복사나 일부 장치의 실패로 한 생성 그룹만 이전 가중치를 사용하면 시스템은 빠르게 실행되면서 다른 알고리즘을 학습할 수 있습니다. 운영 환경에서는 샘플과 가중치 상태에 반복 식별자를 붙이고 전송 경계마다 확인해야 합니다.
장애 처리도 같은 계약에 들어가야 합니다. 긴 학습에서는 워커 교체, 엔진 재시작, 부분 통신 실패가 생깁니다. 작은 전체 그래프를 보는 컨트롤러가 어느 노드부터 다시 실행할지 결정하고, 각 워커 그룹은 연산을 안전하게 재시도할 수 있는지와 결과가 다음 단계에 이미 보였는지를 알려야 합니다. 이 정보가 없으면 유연한 오케스트레이션이 복구 상태를 더 복잡하게 만들 수 있습니다.
최적 배치에는 유효 기간이 있는 구조
자동 매핑의 답은 프로파일을 만든 시점의 작업부하에 묶입니다. 응답 길이, 정책 품질, 보상 모델 부하, 커널 버전, 클러스터 경합은 한 학습 과정에서도 바뀝니다. 정책이 좋아지며 더 긴 풀이를 만들거나 새 추론 엔진이 생성 시간을 줄이면 병목이 학습으로 돌아갈 수 있습니다. 초기 반복에 맞는 계획이 마지막 반복에도 최적이라는 보장은 없습니다.
운영자는 최적화기의 입력과 예측 시간을 남기고 실제 노드 시간과 비교해야 합니다. 오차가 지속될 때는 전체를 즉시 옮기기보다 제한된 재배치 시험을 수행합니다. 가중치 이동, 통신 그룹 생성, 캐시 준비, 중단된 반복 시간을 이득에서 빼야 합니다. 전환 뒤 5% 빠른 구성이 남은 시간이 20분인 작업에는 손해일 수 있고 며칠 남은 작업에는 가치가 있을 수 있습니다.
용량의 단위는 완료한 정책 갱신
GPU 이용률이 높아져도 유효한 RL 진도는 낮아질 수 있습니다. 생성 엔진이 토큰을 빠르게 만들어도 학습기가 동기화된 배치를 기다릴 수 있고, 학습 MFU가 높아도 생성 풀이 새 액터 버전을 기다릴 수 있습니다. 따라서 처리 용량은 완료한 정책 갱신 수를 기준으로 보고, 갱신마다 사용한 샘플, 생성 토큰, 가속기 시간을 함께 적어야 합니다.
알고리즘 명세, 실행 프로토콜, 하드웨어 배치를 서로 다른 객체로 관리하되 모든 실행에 세 버전을 기록하는 것이 실용적인 결론입니다. 새 RL 방식은 분산 커널을 다시 쓰지 않고 그래프만 바꾸고, 새 GPU는 학습 의미를 바꾸지 않고 배치만 바꿀 수 있습니다. 이 분리가 HybridFlow를 한 번의 벤치마크가 아니라 계속 확장되는 기반으로 만든 이유입니다.
출처와 저작권 안내
이 글은 Silicon & Systems가 작성한 편집 요약으로, 아래에 인용한 논문의 논지를 우리 표현으로 재서술한 것입니다. 원문의 문장, 도판, 표는 이 글에 재사용하지 않았으며, 이 페이지의 도판은 모두 이 요약을 위해 새로 제작했습니다. 논문은 EuroSys 2025에서 발표되었고, 확정본은 Proceedings of the Twentieth European Conference on Computer Systems에 실려 있습니다. (c) 2025 the authors, publication rights licensed to ACM. 저자 준비판은 arXiv:2409.19256에서 열람할 수 있습니다.