지난 20년간 DRAM 산업은 뚜렷한 시장 구분을 유지해 왔습니다. 데이터센터는 용량과 정비성, 신뢰성을 우선하는 RDIMM을 사용했고, LPDDR은 전력 효율을 우선하는 모바일 기기에 주로 납땜해 사용했습니다. 2026년 2월과 8월 사이, 발표 세 건이 이 시장의 경계를 크게 낮췄습니다. ISSCC에서는 한국의 두 공급사가 JEDEC 표준 제정 7개월 만에 동작하는 LPDDR6 실리콘을 나란히 공개했습니다[1][2][7]. Hot Chips에서는 NVIDIA가 메모리 시스템 전체를 모바일 계열 LPDDR5X 모듈로 채운 주력 서버 CPU를 상세 공개했습니다[3]. 다음 날 Samsung은 같은 LPDDR 계열 메모리가 자체 뱅크 안에서 연산까지 하며 엣지 가속기의 LLM 토큰 처리량을 3배로 올리는 모습을 보였습니다[4]. 세 발표가 공통으로 다루는 데이터센터 설계 제약은 전력입니다.
본지의 다른 메모리 글과 함께 보면 서버 메모리 계층의 변화가 더 분명해집니다. HBF는 대용량 계층을 확장하고 Raptor는 연산 다이 가까이에서 대역폭을 높입니다. 이 글이 다루는 변화는 CPU 쪽입니다. 세 발표를 차례로 살펴보고, LPDDR 계열 모듈이 기존 RDIMM을 대체하려면 성능과 운용성에서 무엇을 더 입증해야 하는지 정리합니다.
표준에서 실리콘까지 일곱 달
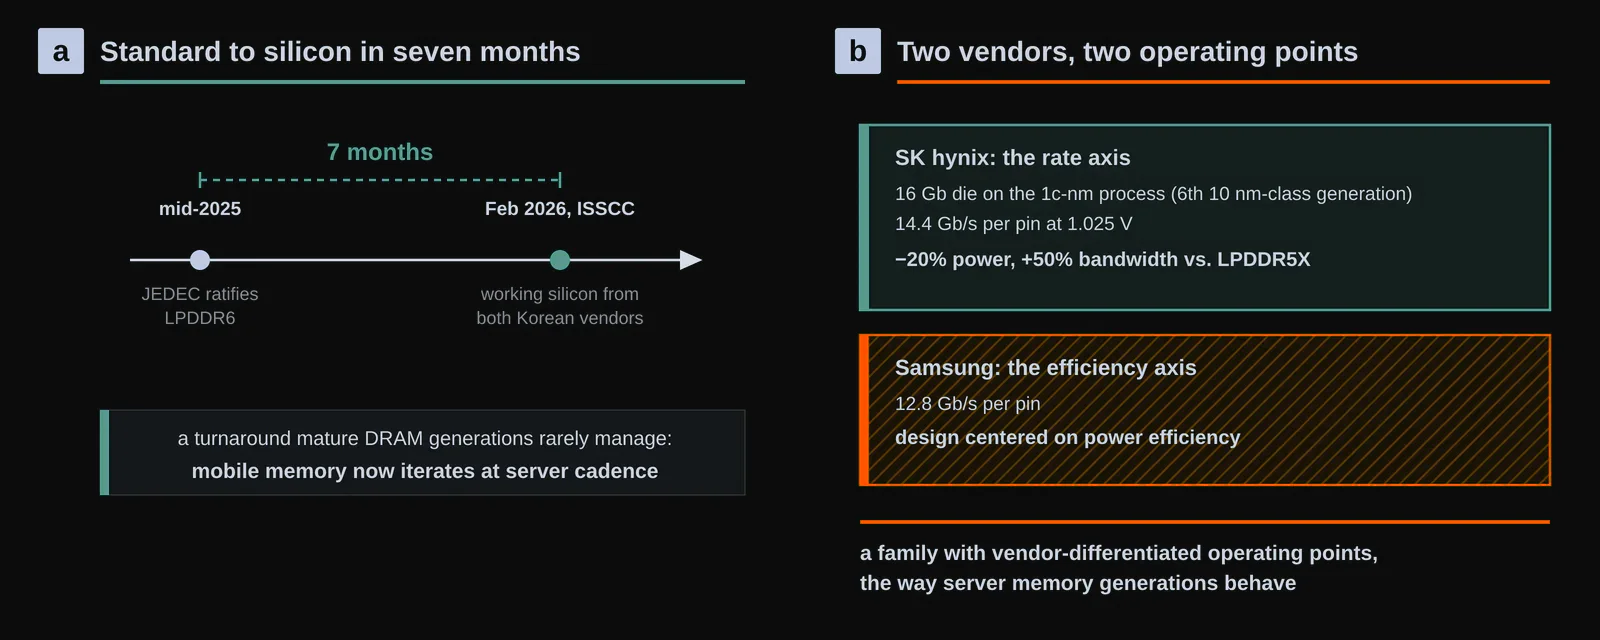
JEDEC은 2025년 중반에 LPDDR6를 제정했고, 2026년 2월 ISSCC에서 Samsung과 SK hynix가 나란히 동작 실리콘을 발표했습니다. 성숙한 DRAM 세대에서도 드문 7개월 회전입니다. 두 구현은 설계 공간을 시사적으로 갈라 가졌습니다. SK hynix는 속도를 밀었습니다. 1c-nm 공정(10nm급 6세대)의 16Gb 다이를 1.025V에서 핀당 14.4Gb/s로 돌리고, 자사 LPDDR5X 대비 전력 20% 절감과 대역폭 50% 향상을 내세웁니다[1][7]. Samsung은 반대축을 다듬어 핀당 12.8Gb/s에서 전력 효율을 중심에 둔 설계를 내놨습니다[2]. 이 분화가 말해 주는 것이 있습니다. LPDDR6는 단일 부품이 아니라 공급사별 동작점이 갈리는 제품군으로 도착하고 있는데, 이는 휴대폰 메모리가 아니라 서버 메모리 세대의 행동 양식입니다.
소켓 문제, 모듈이 푸는 방식
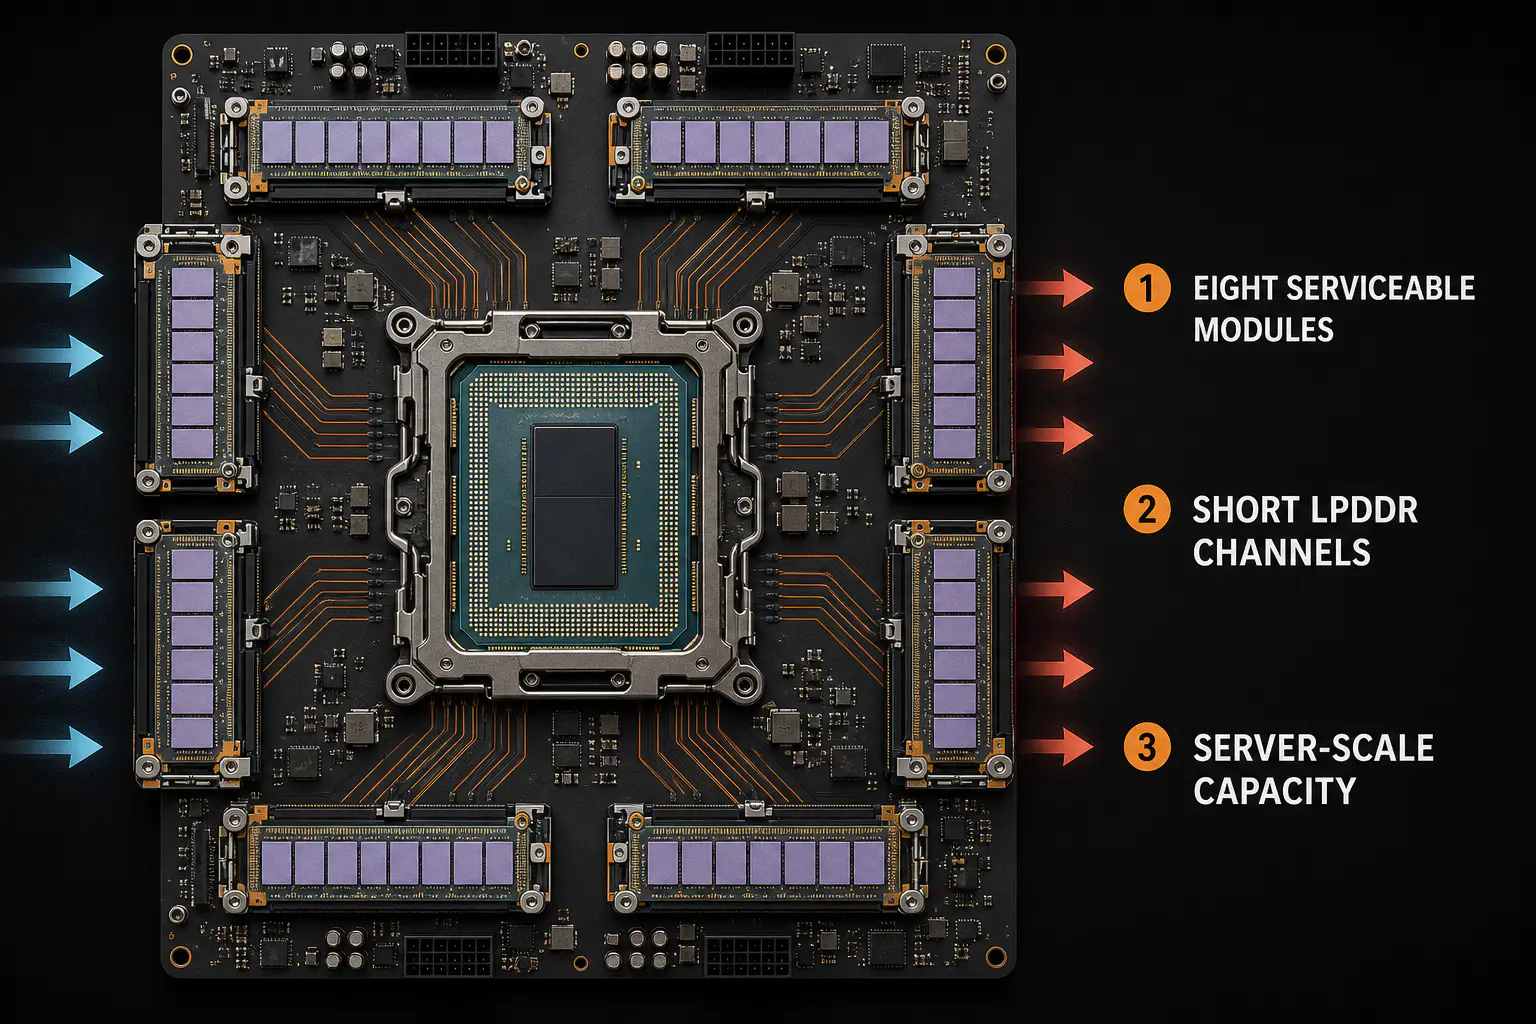
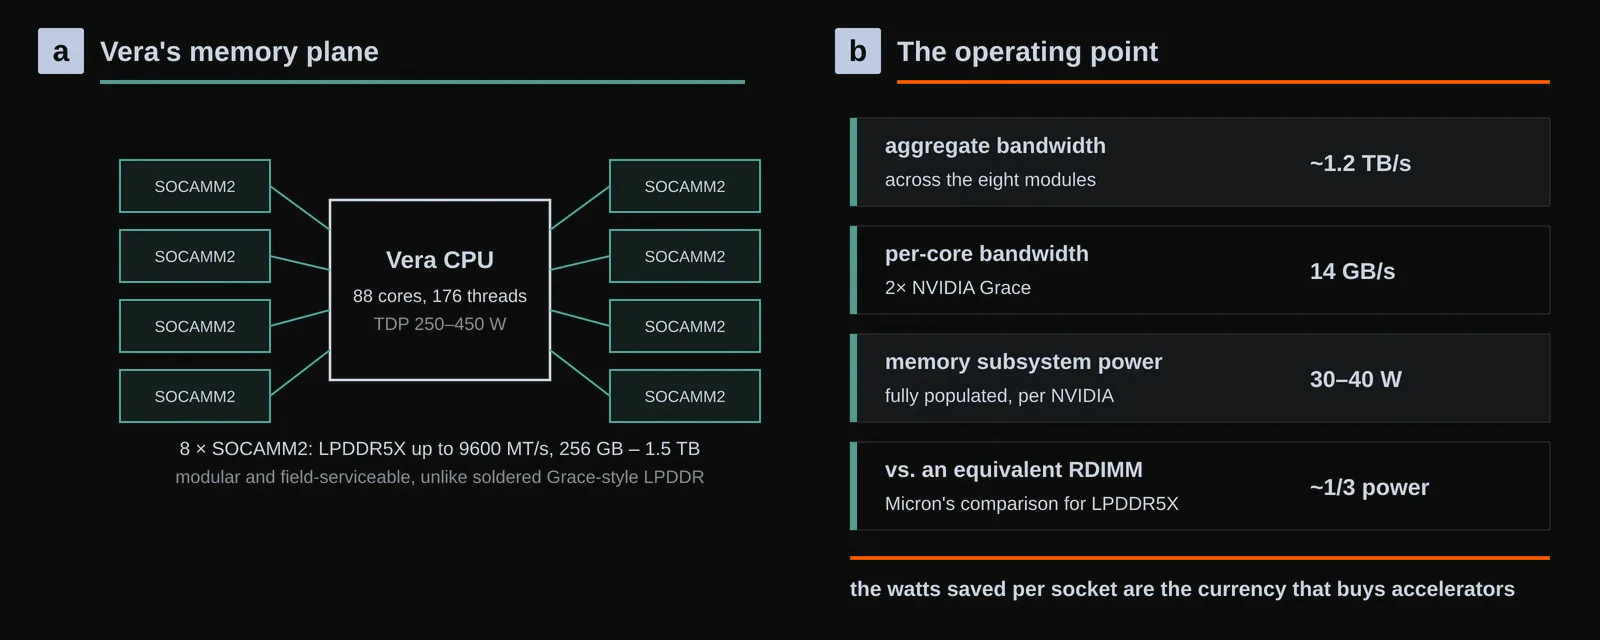
LPDDR을 서버 밖에 세워 둔 것은 속도가 아니라 속도 주변의 모든 것이었습니다. LPDDR은 납땜되어 왔으므로 패키지 하나의 고장이 보드 전체의 고장이었습니다. 부착점당 용량은 적층 RDIMM에 밀렸고, 데이터센터 운영자가 신뢰하는 RAS 장치들(스페어 로우, 오류 텔레메트리, 현장 교체 단위)은 담장의 RDIMM 쪽에서 자랐습니다. NVIDIA의 Grace는 그래도 담장을 넘었습니다. LPDDR5X를 CPU 옆에 납땜하고 정비성 비용을 감수했습니다. Hot Chips 2026에서 상세 공개된 Vera는 그 두 번째 반복이 어떤 모습인지 보여 줍니다. CPU당 SOCAMM2 모듈 슬롯 여덟 개에 256GB부터 1.5TB까지 채우고, LPDDR5X를 최대 9600MT/s로 돌려 합산 약 1.2TB/s를 냅니다. 코어당 14GB/s로 Grace의 2배입니다[3][5].
이 수고를 설명하는 것은 전력 수치지만 비교 범위를 분명히 해야 합니다. NVIDIA의 현재 Vera 아키텍처 페이지는 최대 1.2TB/s를 “기존 CPU 메모리”의 절반 전력으로 제공하고, 자사가 고른 x86 DDR5 기준선보다 대역폭은 2배, 코어당 대역폭은 3배라고 제시합니다[3]. 이는 독립적인 DIMM 대 모듈 실험이 아니라 공급사의 시스템 비교입니다. 그래도 랙 차원의 동기는 분명합니다. CPU 메모리에서 아낀 전력은 가속기, 냉각, 전력 변환 여유에 다시 배분할 수 있습니다. SOCAMM은 RDIMM의 장점 가운데 모듈성을 되찾았습니다. RDIMM이 수십 년간 쌓은 RAS 실적과 비교하려면 실제 장비군의 고장 자료가 공개되어야 합니다.
별도 리뷰 Vera CPU의 설계 기준에서는 이 메모리 중심 종합 글에서 다루지 않은 Olympus 코어, 일관성 패브릭, 벤치마크 조건, 시스템 수준 한계를 자세히 분석합니다.
표준 패키지 안에서 연산하는 메모리
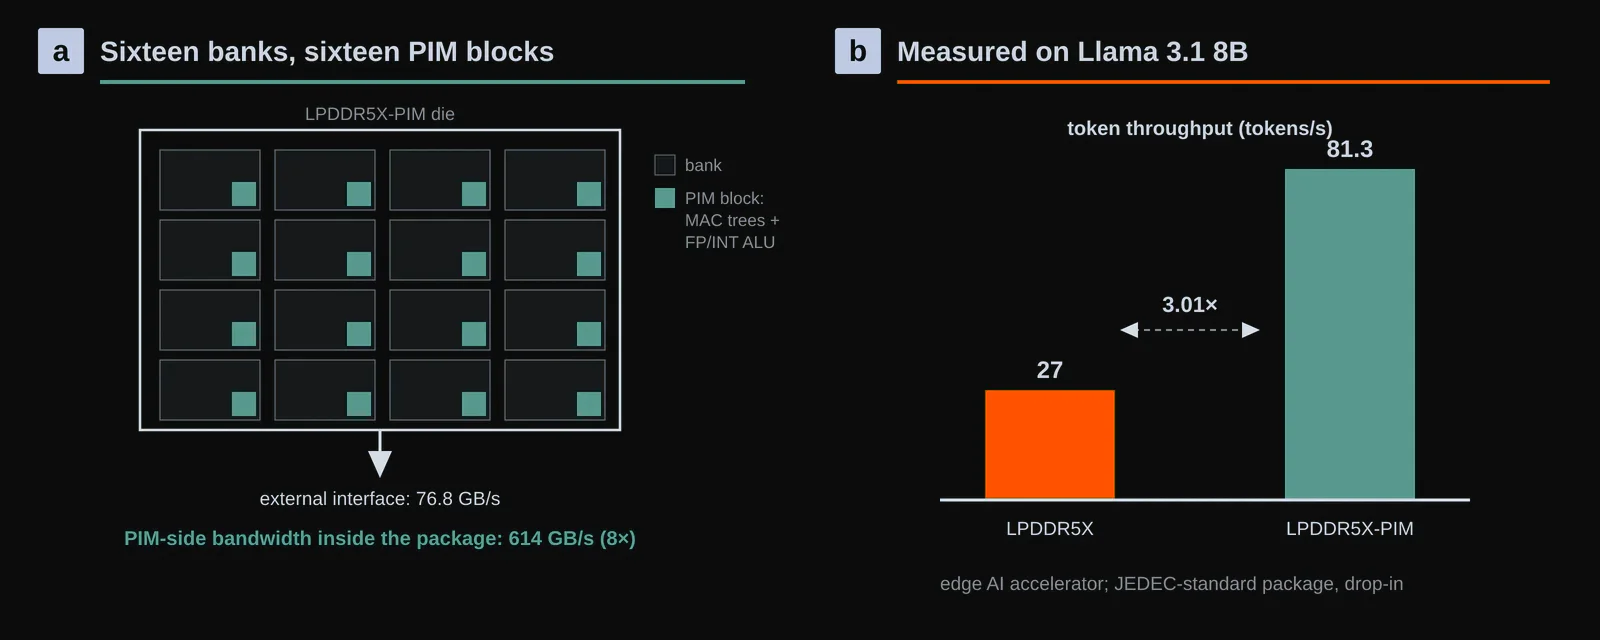
세 번째 발표는 연산을 메모리 인터페이스 안쪽으로 옮깁니다. DRAM 다이의 여러 뱅크가 내부에서 처리하는 데이터의 합은 외부 인터페이스 대역폭보다 크며, 프로세싱 인 메모리(PIM)는 뱅크 옆에 산술 로직을 두어 이 내부 대역폭을 활용합니다. Hot Chips 2026에서 공개된 Samsung LPDDR5X-PIM은 다이의 뱅크 16개에 PIM 블록 16개를 분산 배치했습니다. 각 블록은 곱셈 누산 트리와 부동소수점·정수를 모두 다루는 ALU를 갖추며, 다중 정밀도를 지원하는 첫 저전력 PIM 부품입니다[4][6]. 내부 PIM 대역폭은 614GB/s이고 기존 외부 인터페이스는 76.8GB/s로 8배 차이가 납니다. Llama 3.1 8B를 실행한 엣지 가속기에서 토큰 처리량은 초당 27개에서 81.3개로 3.01배 높아졌습니다. Raptor 글에서 다뤘듯 대역폭에 묶이는 디코드 단계가 직접적인 적용 대상입니다.
이것이 데모 너머를 겨냥한다는 신호가 둘 있습니다. 부품이 JEDEC 표준 패키지를 유지하므로 보드 변경 없이 기존 LPDDR5X 자리에 그대로 꽂힙니다. 그리고 표준화 기계가 이미 돌고 있습니다. Samsung과 SK hynix는 JEDEC에서 LPDDR6-PIM을 추진 중이고 Micron도 LPDDR6 세대에서 PIM을 들고 나올 것으로 알려져, 연산하는 메모리는 독점 실험이 아니라 표준 카탈로그 품목이 될 참입니다.
LPDDR의 기회는 CPU 메모리 평면에 있는 구조
하나씩 보면 각 발표는 점진적입니다. 더 빠른 세대, 교체 가능한 모듈, 실험실 데모입니다. 함께 보면 모바일 계열 DRAM이 서버의 요구 조건을 하나씩 받아들이는 흐름이 보입니다. 그렇다고 LPDDR이 모든 RDIMM과 HBM을 대체한다는 뜻은 아닙니다. HBM은 가속기에서 가장 높은 대역폭이 필요한 계층을 맡고, RDIMM은 성숙한 RAS, 넓은 플랫폼 지원, 큰 용량 구성에서 강점이 있습니다. LPDDR의 가까운 기회는 와트당 대역폭이 중요하고 모듈화로 정비성 문제를 줄일 수 있는 CPU 메모리 평면입니다. 남은 질문은 세 가집니다. 장비군 규모의 오류 거동, 대형 RDIMM 대비 용량과 업그레이드 비용, 일반 프레임워크가 쓸 수 있는 PIM 프로그래밍 모델입니다. 전기적 장점은 분명하지만 시장의 결론은 이런 시스템 조건이 정합니다.
서버용 LPDDR는 전력과 핀의 선택
LPDDR는 좁은 채널을 많이 사용하고 신호 에너지를 낮춰 총대역폭을 만듭니다. 메모리 컨트롤러와 장치가 가까운 CPU·가속기 패키지나 소형 모듈에 적합할 수 있지만 전력만 낮아지는 것이 아닙니다. 채널 수, 패키지와 보드 배선, 컨트롤러 면적, 명령 동작, 수리 방식이 함께 바뀝니다.
시스템 입력 전력당 유효 메모리 작업을 측정하고 용량, 대역폭, 지역성을 붙여야 합니다. SOCAMM 같은 모듈은 교체성을 남기지만 커넥터, 기계, 열, 신호 제약을 새로 만듭니다. 가장 유리한 구성만 보지 않고 모든 채널과 최대 지원 용량을 채운 상태를 검증해야 합니다.
신뢰성과 수리 방식이 서버 경계를 정하는 기준
서버는 오류 검출, 위치 파악, 예측 교체, 장기간 운전을 요구합니다. 온다이 ECC, 메모리 컨트롤러 ECC, 모듈 코드워드는 서로 다른 장애를 보호하므로 수정 오류 수, 주소 격리, 백그라운드 점검, 영역 폐기를 장비 관리에 보여 줘야 합니다.
모듈은 호스트를 유지한 채 용량을 복구할 수 있지만 커넥터 위험이 있고, 납땜 메모리는 전기 특성이 좋아도 보드 전체가 수리 단위가 될 수 있습니다. 장애율, 예비 전략, 수리 시간, 메모리 한 건 때문에 함께 빠지는 정상 연산 용량을 총비용에 넣어야 합니다.
메모리 안의 연산에 필요한 좁고 명확한 계약
메모리 근처 연산은 이동량을 줄일 수 있지만 공급사 전용 경로에 용량과 프로그램을 묶을 수 있습니다. 정밀도, 순서, 보호, 대체 경로가 명확한 작은 연산 집합으로 제공하는 편이 안전합니다. 설정, 데이터 배치, 동기화 비용이 절감한 전송보다 작은지 런타임이 판단하고, 실패하면 일반 경로에서 같은 결과를 낼 수 있어야 합니다.
LPDDR, DDR, HBM, CXL 메모리, 플래시는 하나의 순위가 아니라 서로 다른 용량, 지연, 대역폭, 전력, 영속성, 수리성을 제공합니다. 서버용 LPDDR의 최종 근거는 표준과 초기 실리콘을 넘어 오류 가시성, 수리 모델, 최대 용량 검증, 소프트웨어 배치, 서버 수명 동안의 유효 작업당 전력을 함께 보여 주는 것입니다.
구매할 때는 완성된 메모리 도메인을 비교해야 할 이유
공정한 비교에는 소켓이나 가속기, 메모리 컨트롤러, 채운 용량, 보드, 냉각, 펌웨어, 운영체제가 모두 들어갑니다. 부품의 핀 속도만 비교하면 동시에 동작할 채널 수, 제공 용량, 한 채널 장애 뒤의 성능을 알 수 없습니다. 최대 지원 용량을 채우고 읽기와 쓰기를 섞어 열이 안정될 때까지 대역폭, 꼬리 지연, 전력, 수정 오류를 측정해야 합니다.
장애와 유지보수도 시험해야 합니다. 모듈을 뺄 수 있는 구성에서는 하나를 제거하거나 오류를 주입해 주소 격리와 재훈련, 남은 배치 가능 연산을 확인합니다. 납땜 구성에서는 보드 교체 시간과 예비 수량을 측정합니다. 부팅 펌웨어, 메모리 훈련, NUMA 탐색, 오류 보고, 가상화, 재설정, 성능 계수가 같은 토폴로지를 설명하는지도 검증해야 합니다.
마지막으로 작업별 교차점을 보여 줘야 합니다. 어느 작업 집합 크기와 동시성, 대역폭에서 LPDDR 구성이 DDR나 HBM 대안보다 전력당 완료 작업을 더 많이 내고, 어느 지점에서 용량과 지연, 수리 비용이 결과를 뒤집는지 밝혀야 합니다. LPDDR6, SOCAMM2, 메모리 측 연산은 설계 선택지를 늘립니다. 실제 서버 인프라가 되는 조건은 전기 경로, 신뢰성 계약, 소프트웨어, 작업, 교체 모델을 하나의 배포 범위로 증명하는 것입니다.
출처와 저작권 안내
이 글은 Silicon & Systems가 작성한 편집 종합입니다. ISSCC 2026과 Hot Chips 2026 발표 내용을 NVIDIA의 현재 Vera 아키텍처 페이지 및 위의 보충 보도와 대조해 우리 표현으로 다시 썼습니다. 회사가 제시한 비교 수치는 독립 벤치마크와 구분해 표시했습니다. 원문의 문장, 표, 도판, 슬라이드는 재수록하지 않았고 이 페이지의 도판은 모두 이 글을 위해 새로 만들었습니다. 인용된 발표의 저작권은 각 회사에 있습니다(2026).