H800은 수출 규제에 맞춰 성능을 낮춘 Hopper GPU입니다. FP64 연산 성능이 줄었고, NVLink 대역폭도 H100의 900 GB/s에서 400 GB/s로 내려갔습니다. 딥시크는 이 GPU 2,048장으로 6,710억 파라미터 V3를 학습했고, 부족한 노드 내 대역폭은 노드당 400 Gbps InfiniBand NIC 8장으로 보완했습니다. ISCA 2025 산업 트랙에서 이 회사의 인프라 팀은 그 제약을 해결한 과정을 상세히 기록한 문서를 발표했습니다[1]. 어떤 모델 구조가 인터커넥트 때문에 선택됐는지, 성능 상한이 어디에서 생기는지, 다음 세대 하드웨어에 어떤 기능이 필요한지를 번호까지 붙여 제시합니다. 하이퍼스케일러는 구축을 마친 클러스터를 설명하고[6][7] 벤더는 앞으로의 로드맵을 소개하지만, 실제 사용자가 실리콘의 한계를 수치로 정리한 자료는 드뭅니다. 따라서 이 논문은 표준화가 진행 중인 스케일업 패브릭에 대한 구매자 측 요구사항으로 읽을 가치가 있습니다.
아래는 그 논지를 우리 표현으로 정리한 것입니다. 논문은 모델 아키텍처와 수치 형식, 네트워킹을 두루 다루지만 무게중심은 하나의 주장에 있습니다. Mixture of Experts(MoE) 추론에서 추론 모델의 디코드 속도는 FLOPS가 아니라 인터커넥트의 속성이라는 것입니다.
대역폭 상한 아래의 공동 설계
모델 아키텍처는 하드웨어 제약이 큰 지점마다 데이터 이동과 연산량을 줄이도록 설계됐습니다. Multi-head Latent Attention(MLA)은 모든 어텐션 헤드의 키-값 상태를 학습 가능한 잠재 벡터 하나로 사영해 디코딩 시 토큰당 70 KB만 캐시합니다. 그룹 쿼리 방식은 Qwen-2.5 72B가 327 KB, LLaMA-3.1 405B가 516 KB를 사용해 각각 4.66배와 7.28배 큽니다[1]. DeepSeekMoE는 V3의 6,710억 파라미터 중 토큰당 370억만 활성화하며, 논문은 이를 학습 연산 기준 토큰당 약 250 GFLOPS로 계산합니다(405B 밀집 모델은 2,448 GFLOPS). FP8은 추론 뒤 적용하는 양자화가 아니라 학습 수치 형식으로 사용했습니다. 저자들에 따르면 V3는 처음부터 끝까지 FP8로 학습한 최초의 오픈소스 대형 모델입니다. 활성값에는 1×128 타일 단위, 가중치에는 128×128 블록 단위 양자화를 적용했으며, 16B와 230B 모델의 절제 실험에서 BF16 대비 정확도 손실은 0.25% 미만이었습니다[2]. Multi-Token Prediction 모듈은 스텝마다 두 번째 토큰의 초안을 만들어 80~90% 수락률을 얻었고 생성 속도를 1.8배 높였습니다.
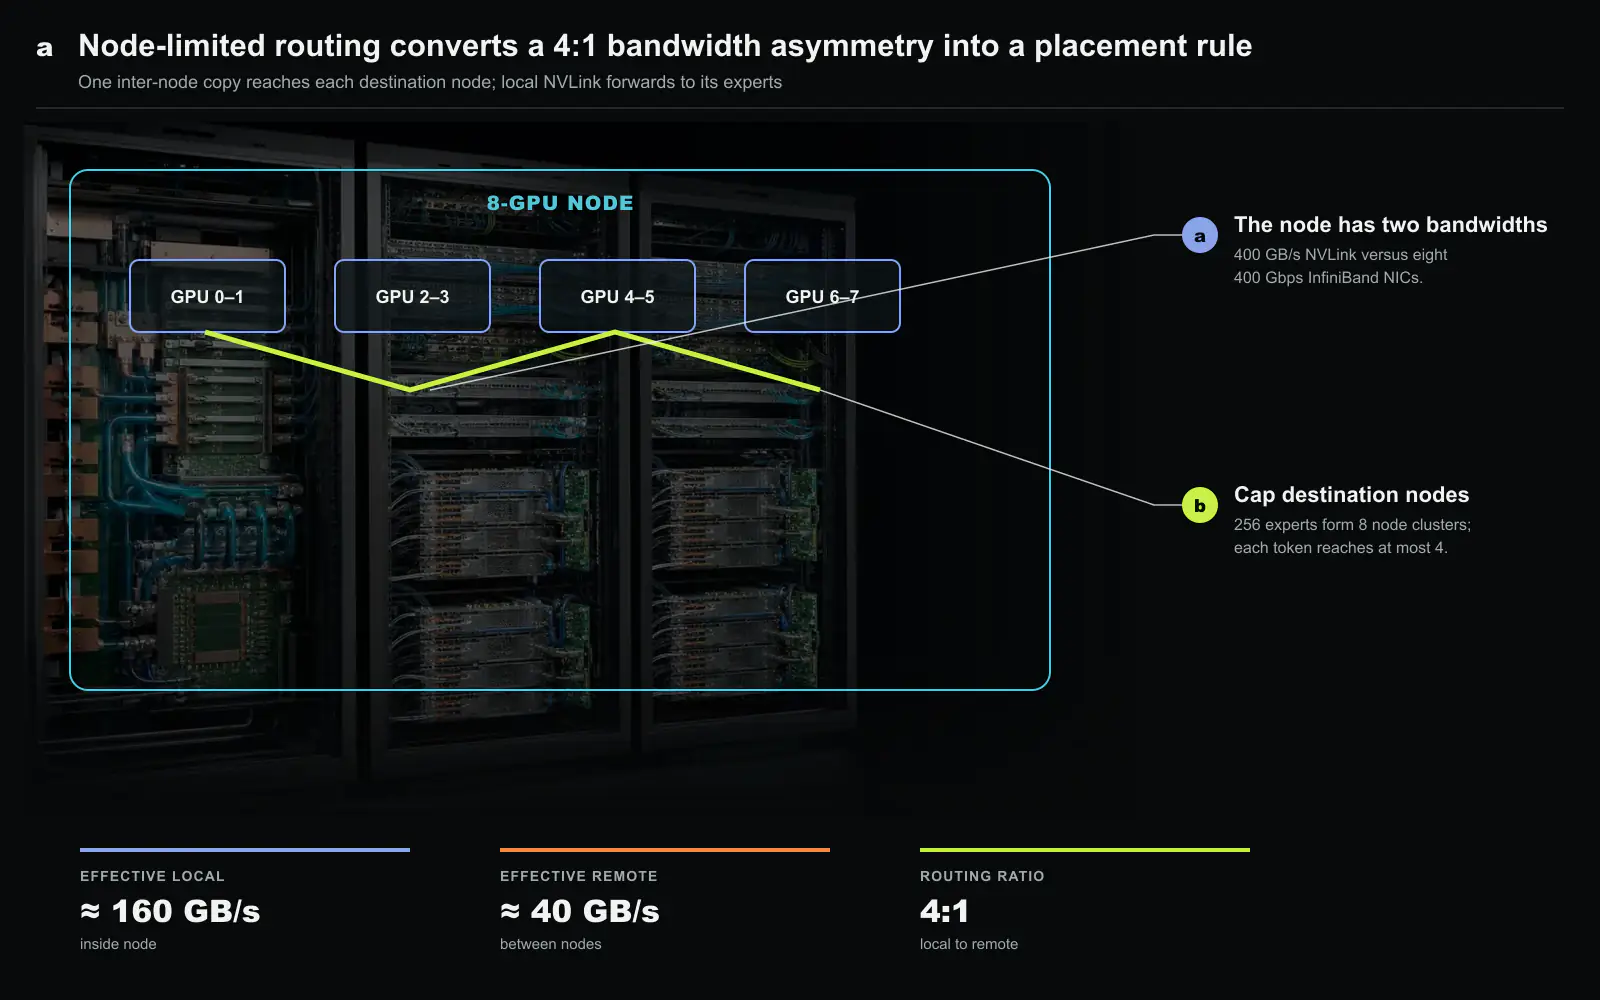
인터커넥트가 모델을 빚어낸 흔적이 가장 뚜렷한 곳은 전문가 배치입니다. H800 노드에서 NVLink의 실효 대역폭(약 160 GB/s)과 InfiniBand NIC 한 장의 실효 대역폭(약 40 GB/s)의 비율은 대략 4:1입니다. 그래서 V3는 256개 라우팅 전문가를 노드당 8개 그룹으로 묶고, 각 토큰의 전문가 집합이 걸치는 노드를 4개로 제한합니다. 토큰은 목적지 노드마다 InfiniBand를 한 번만 건너고, 그 다음은 NVLink가 노드 안의 형제 GPU들로 뿌려서 비싼 트래픽을 중복 제거합니다. 모델의 라우팅 함수를 대역폭 비율이 공동 집필한 셈입니다.
마이크로초로 쓴 디코드 상한
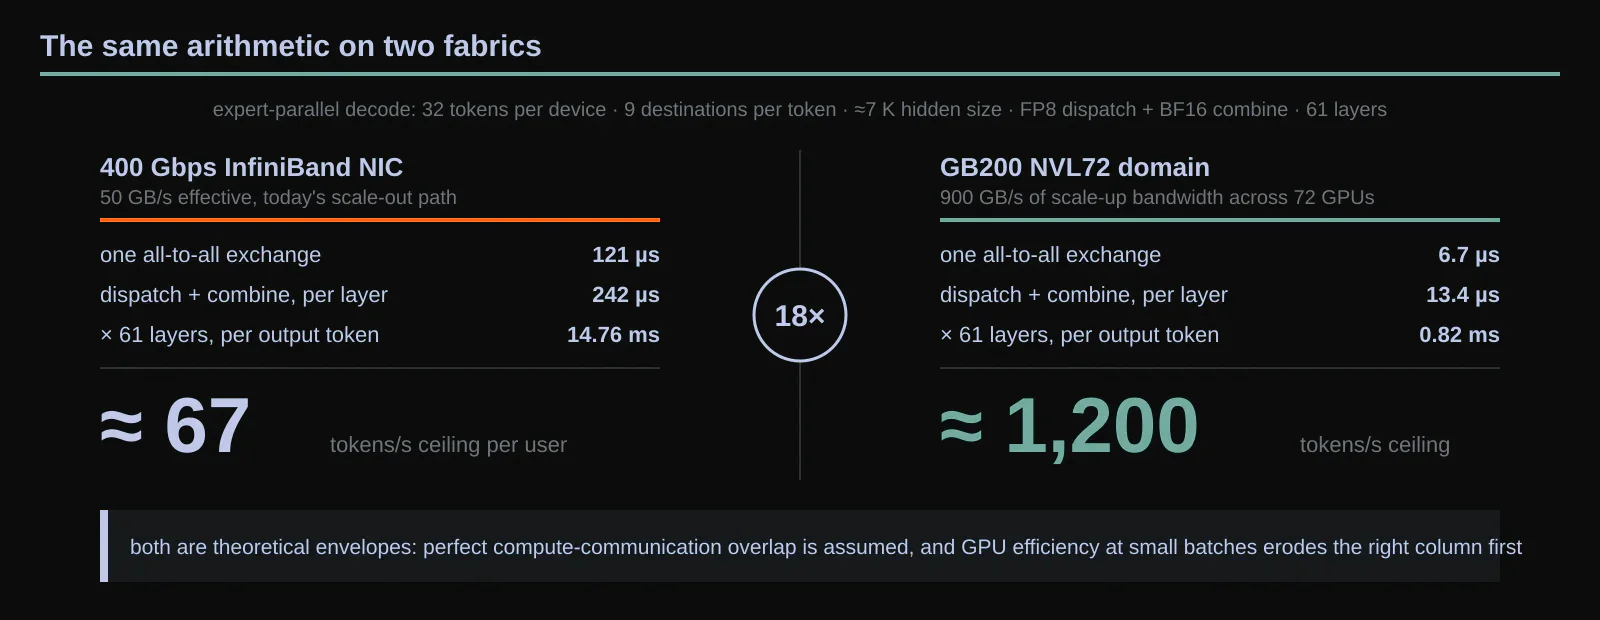
논문의 핵심 분석은 통신 대역폭과 토큰 처리량의 관계를 계산한 부분입니다. 전문가 병렬 디코딩에서 각 레이어는 올투올 교환을 두 번 수행하고(디스패치는 FP8, 컴바인은 BF16), 각 토큰은 은닉 크기 약 7K로 9개 전문가(라우팅 8 + 공유 1)를 상대합니다. 장치당 32토큰 배치를 50 GB/s(400 Gbps) NIC로 보내면 교환 한 번에 약 121 µs가 들고, V3의 61개 레이어에서 두 번씩 반복하면 연산으로 통신을 완전히 가리더라도 출력 토큰당 최소 14.76 ms가 필요합니다. 다른 손실을 반영하기 전부터 사용자당 처리량 상한은 초당 약 67토큰입니다. 같은 공식을 GB200 NVL72 도메인(72개 GPU에 걸친 900 GB/s 단방향 스케일업 대역폭)에 대입하면 교환당 시간은 6.7 µs, 출력 토큰당 최소 시간은 0.82 ms, 처리량 상한은 초당 약 1,200토큰입니다. 이론상 18배 차이지만 배치가 작아지면 네트워크보다 GPU 효율이 먼저 낮아지므로, 저자들은 이 값을 이론 상한으로 구분합니다[1].
이 계산은 패브릭 대역폭을 실제 모델 처리량과 연결합니다. 테스트타임 스케일링에서는 초당 생성 토큰 수가 모델 품질을 높이는 데 사용할 수 있는 추론 연산량을 제한하고, 강화학습에서는 학습 진도도 제한합니다. MoE 모델의 토큰 속도가 올투올 지연에 묶인다면 NVL72나 개방형 스케일업 패브릭의 가치는 GB/s뿐 아니라 초당 토큰의 변화로 평가해야 합니다.
통신량을 줄이기 위해 연산 자원을 더 쓰는 방식
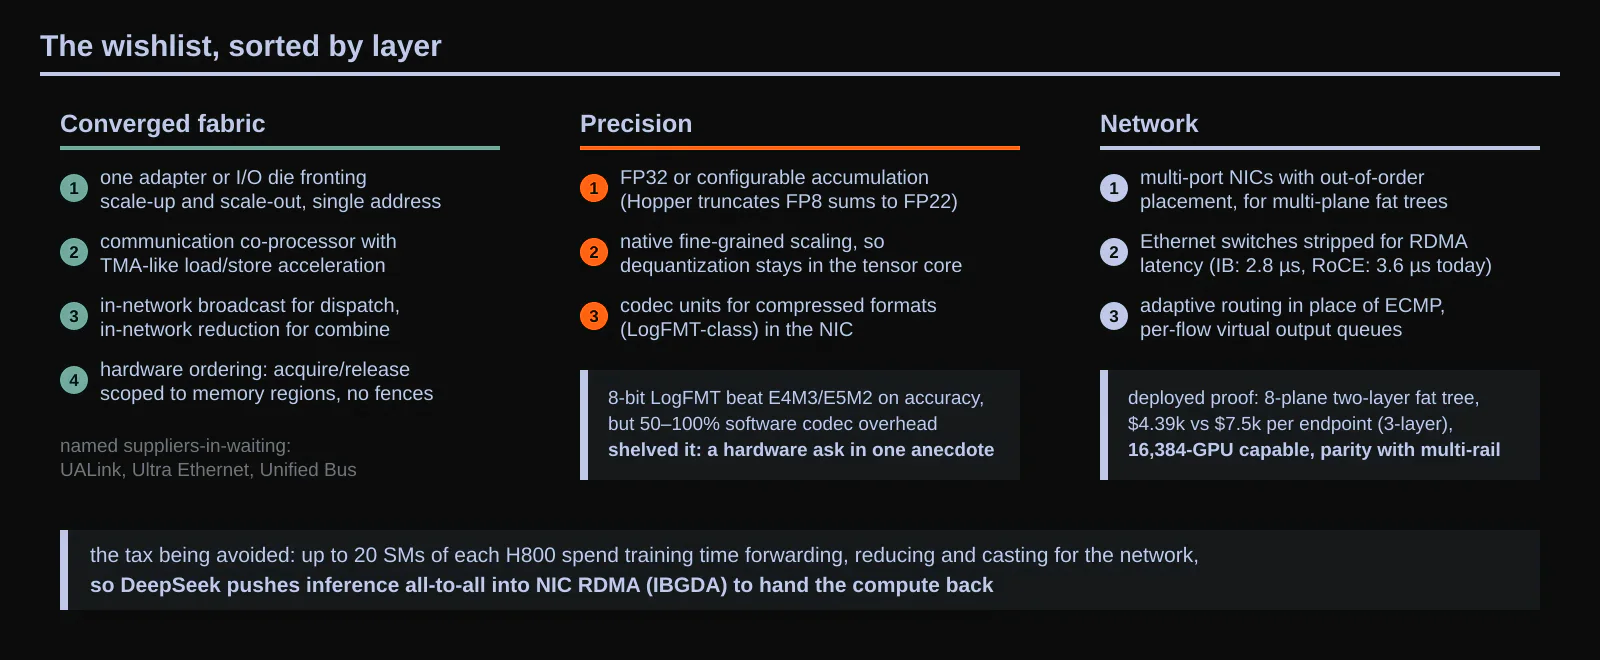
현재 구조의 비용은 지연뿐 아니라 NVLink와 InfiniBand 사이의 전달을 소프트웨어가 처리한다는 데서 발생합니다. GPU의 스트리밍 멀티프로세서(SM)가 작업 큐를 채우고, RDMA 버퍼와 텐서 버퍼 사이에서 데이터를 옮기며, 컴바인 단계의 리덕션과 분할된 메모리 레이아웃 관리, 데이터 형식 변환까지 수행합니다. 학습 중에는 H800의 SM 중 최대 20개가 이러한 통신 작업에 사용됩니다. 추론에서는 올투올 트래픽을 NIC RDMA로 보내 SM을 연산에 다시 사용하고, IBGDA(InfiniBand GPUDirect Async)로 GPU 스레드가 도어벨을 직접 기록해 CPU 프록시를 제거했습니다. 저자들의 주장은 이런 소프트웨어 우회가 필요한 경계 자체를 하드웨어에서 줄여야 한다는 것입니다.
하드웨어 요구사항은 이 진단에서 도출됩니다. 첫째, 스케일업과 스케일아웃을 하나의 틀로 수렴시킬 것. 단일 주소 아래에서 두 도메인을 모두 상대하는 통합 네트워크 어댑터 또는 I/O 다이를 만들고, 스케일아웃에서 도착한 패킷을 스케일업 패브릭으로 올바른 GPU까지 전달할 정도의 스위칭 기능을 넣으라는 것입니다. 둘째, 보조 통신 작업을 하드웨어로 옮길 것. 텐서 메모리 가속기처럼 로드/스토어를 가속하는 전용 통신 코프로세서, 디스패치를 위한 망 내 브로드캐스트, 컴바인을 위한 망 내 리덕션이 여기에 해당합니다. 셋째, 소프트웨어 동기화를 하드웨어 순서 보장으로 대체할 것. 이상적으로는 메모리 영역 단위의 획득/해제 시맨틱을 제공해서, 메모리 시맨틱 통신이 메시지마다 펜스와 플래그의 왕복을 물지 않게 하라는 요구입니다. 저자들은 이를 실현할 후보로 UALink[3], Ultra Ethernet[4], 그리고 두 도메인 통합의 새로운 접근이라고 평가한 UB-Mesh의 Unified Bus[5]를 이름까지 짚어 거론합니다.
수치 형식과 네트워크를 함께 설계해야 할 이유
수치 정밀도 분석에서도 필요한 하드웨어 기능을 제시합니다. Hopper 텐서 코어는 FP8 곱을 사실상 FP22(가수 13비트)로 누적합니다. 딥시크 프레임워크가 부분합을 CUDA 코어로 옮겨 고정밀로 누적하는 이유입니다. 논문은 FP32 또는 설정 가능한 누적 정밀도와, 역양자화가 텐서 코어 안에서 끝나도록 세밀한 스케일링 인자를 직접 지원할 것을 요구합니다(Blackwell의 마이크로스케일링 형식을 첫 산업적 대응으로 언급합니다). 자체 개발한 로그 기반 수 형식 LogFMT도 하드웨어 지원의 중요성을 보여 줍니다. 실험에서 8비트 LogFMT는 학습 정확도가 E4M3와 E5M2보다 높았고 10비트는 BF16에 근접했지만, 범용 GPU에서 인코딩과 디코딩을 수행하자 통신 커널 오버헤드가 50~100% 늘어 실제 학습에는 사용하지 않았습니다. NIC가 압축 코덱을 지원해야 적용할 수 있는 형식입니다.
스케일아웃 구성은 모델과 네트워크를 함께 설계한 효과를 운영 환경에서 보여 줍니다. V3는 GPU-NIC 쌍마다 전용 평면을 배정한 8평면 2계층 팻트리에서 학습됐습니다. 논문은 이 토폴로지의 비용을 엔드포인트당 4,390달러로, 대체한 3계층 트리를 7,500달러로 계산하며 원리상 GPU 16,384장까지 확장할 수 있다고 봅니다(실제 배치는 정책 제약으로 2,000장을 조금 넘었습니다). 측정한 NCCL과 전문가 병렬 트래픽은 단일 평면 멀티레일 네트워크와 비슷했고, DeepEP 라이브러리는 GPU 16~128장 구간에서 GPU당 40 GB/s 이상을 유지했습니다. RoCE에 필요한 기능도 구체적으로 제시합니다. RDMA 지연에 맞춰 불필요한 기능을 줄인 이더넷 스위치[8], 충돌이 잦은 ECMP 해싱을 대신할 적응형 라우팅, 올투올 인캐스트가 동시에 실행되는 올리듀스의 대역폭을 잠식하지 않게 하는 흐름별 가상 출력 큐입니다. 저자들의 측정에서 InfiniBand 지연은 2.8 µs로 RoCE의 3.6 µs보다 낮았지만, 64포트 스위치의 제한과 가격 때문에 장기적인 확장 수단으로는 부족하다고 평가합니다.
차세대 패브릭의 요구 조건을 드러내는 제한된 링크
이 논문은 시스템 보고서이면서 동시에 구매자 요구사항입니다. 전자의 관점에서는 줄어든 스케일업 대역폭을 라우팅 공동 설계와 전체 FP8 학습, 다중 평면 네트워킹으로 보완한 과정을 보여 줍니다. 후자의 관점에서는 UALink와 Ultra Ethernet, Unified Bus가 경쟁하는 패브릭에 필요한 기능을 초당 토큰과 마이크로초로 제시합니다. 망 내 리덕션부터 영역 단위 순서 보장까지, 추가 실리콘과 비용이 필요한 기능을 왜 선택해야 하는지 설명합니다.
2025년의 산업적 의미는 두 번째 관점에 더 가깝습니다. 레인당 200 Gbps로 가속기 1,024개를 묶는 스케일업 표준과 메모리 시맨틱 CXL 패브릭은 본지의 원칩형 데이터센터 설계와 스위치드 CXL 실리콘에서 다뤘습니다. 이 논문은 공급 기술만으로는 알기 어려웠던 구매자의 요구를 채워 줍니다. 다만 가장 큰 패브릭 수치는 실측이 아니라 이론 상한이고, H800의 400 GB/s 제약도 물리 법칙이 아니라 정책에서 생겼습니다. 그 조건을 분리해 읽더라도 요구한 기능은 더 빠른 하드웨어에 그대로 적용됩니다.
학습과 디코드가 요구하는 서로 다른 패브릭
DeepSeek의 요구를 하나의 대역폭 수치로 합치면 안 됩니다. 학습은 그래디언트, 활성값, 옵티마이저 상태, 전문가 토큰을 비교적 큰 집합 통신으로 옮깁니다. 디코드는 작은 토큰 배치를 마이크로초 단위 지연 목표 아래 반복해서 라우팅합니다. 큰 올리듀스에서 높은 지속 대역폭을 내는 패브릭도 디코드에서는 메시지 시작, 끝단 제어, 꼬리 지연 때문에 기다릴 수 있습니다.
구매 평가에는 텐서 병렬 집합 통신, 전문가 올투올, 파이프라인 전송, 체크포인트 경로를 나눠 메시지 크기, 순서 보장, 순간 부하, 중첩 뒤에도 드러난 시간을 적어야 합니다. 저정밀 연산도 바이트와 연산량만 줄이는지 보지 않고 누산, 스케일링, 통신 뒤의 수렴과 최종 품질을 함께 검증해야 합니다.
하드웨어 요구는 실행 가능한 수용 시험으로 바뀌어야 할 이유
스케일업 대역폭은 실제 전문가·텐서 병렬 메시지 분포로, 지연시간은 링크 통과뿐 아니라 소프트웨어 실행과 큐 대기를 포함해 시험해야 합니다. 저정밀 형식은 충분한 학습 단계에서 같은 토큰 예산과 품질을 비교해야 합니다. 구성 요소의 GB/s나 이용률과 함께 목표 지연과 품질 안에서 완료한 학습·디코드 토큰을 두 번째 분모로 둬야 미세 시험의 개선을 전체 시스템 성능으로 잘못 옮기지 않습니다.
공동 설계는 되돌릴 수 있어야 할 이유
소프트웨어는 병렬화, 양자화, 라우팅을 빠르게 바꿀 수 있지만 실리콘의 선택은 오래 남습니다. 한 모델의 일정을 하드웨어에 고정하기보다 프로그래밍 가능한 집합 통신, 데이터 이동, 명확한 저정밀 연산을 제공해야 합니다. 새 모델에서 특화 경로가 맞지 않으면 일반 집합 통신과 정밀도로 돌아갈 수 있어야 단계적으로 검증할 수 있습니다. 모델 구조가 하드웨어 사양의 일부를 쓰는 시대의 답은 한 모델에 고정된 장치가 아니라, 런타임이 비용을 보고 선택할 수 있는 측정 가능한 기능입니다.
출처와 저작권 안내
이 글은 Silicon & Systems가 작성한 편집 요약으로, 아래에 인용한 논문의 논지를 우리 표현으로 재서술한 것입니다. 원문의 문장, 도판, 표는 이 글에 재사용하지 않았으며, 이 페이지의 도판은 모두 이 요약을 위해 새로 제작했습니다. 논문은 ISCA 2025 산업 트랙에서 발표되었고, 확정본은 Proceedings of the 52nd International Symposium on Computer 아키텍처에 실려 있습니다. (c) 2025 the authors, publication rights licensed to ACM. 저자 준비판은 arXiv:2505.09343에서 열람할 수 있습니다.