추론 요청이 갑자기 늘었을 때 남는 GPU가 있다는 사실만으로는 충분하지 않습니다. 해당 모델의 가중치가 GPU에 올라가 있어야 계산을 시작할 수 있고, 전체 모델을 적재하는 동안 기존 인스턴스의 대기열은 계속 길어질 수 있습니다. 장치 수로는 여유가 있어도 짧은 시간 안에 사용할 수 있는 처리 용량은 부족한 상황입니다.
BlitzScale은 새 인스턴스가 도움을 주기 시작하는 시점을 앞당깁니다[1]. Shanghai Jiao Tong University와 Huawei Cloud 연구진은 네트워크를 이용한 가중치 배포와 인스턴스 간 협력 실행을 결합했습니다. 새 GPU가 모든 레이어를 준비할 때까지 기다리지 않고, 먼저 적재한 레이어부터 기존 인스턴스 대신 계산하도록 합니다.
따라서 이 기술의 목표는 모델 파일을 빨리 복사하는 것만이 아닙니다. 원래 대기해야 했던 요청을 조금이라도 일찍 처리해 지연 목표 안에 끝내는 것이 중요합니다. 모델 전체의 준비 완료 시간과 실제 처리량이 증가하는 시점은 같지 않을 수 있으며, 논문은 이 차이를 활용합니다.
호스트 캐시에 없는 모델의 확장 비용
서빙 인스턴스를 시작하려면 실행 환경을 만들고 GPU 메모리에 가중치를 적재해야 합니다. CUDA 컨텍스트와 커널을 미리 준비해 초기화 비용을 줄여도, 수십 또는 수백 GB의 모델 데이터는 새 장치로 이동해야 합니다. 짧은 버스트에 대응할 때는 이 데이터 이동 시간이 허용 가능한 대기 시간보다 길 수 있습니다.
호스트 DRAM에 모델을 캐시하면 저장장치에서 읽는 것보다 빠르게 적재할 수 있습니다. 다만 여러 모델을 서비스하는 플랫폼에서 모든 호스트에 모든 모델을 둘 수는 없습니다. 이전에 사용한 모델이 이미 캐시에서 제거됐을 수도 있고, 확장 대상 호스트가 늘어날수록 필요한 복사본이 없는 호스트를 만날 가능성도 커집니다.
문제는 클러스터 전체에 데이터가 없다는 것이 아니라, 선택한 호스트에서 빠르게 가져올 수 없다는 데 있습니다. 다른 호스트의 DRAM이나 이미 서빙 중인 GPU에는 같은 가중치가 존재할 수 있습니다. BlitzScale은 이런 복사본을 확장의 공급원으로 사용해, 대상 호스트의 로컬 캐시 적중 여부에 대한 의존을 줄입니다.
O(1) 캐싱이 줄이는 대상
논문 제목의 O(1)은 호스트 수가 늘어날 때 모델별로 필요한 호스트 캐시 복사본 수를 가리킵니다. 모델의 종류나 크기가 늘어나도 전체 저장 바이트 수가 일정하다는 뜻은 아닙니다. 실행 중인 여러 GPU가 서빙을 위해 보유해야 하는 가중치 복사본까지 없애는 것도 아닙니다.
전역 파라미터 관리자는 호스트 메모리와 배포된 GPU에 있는 가중치 위치를 추적합니다. 모델이 이미 실행 중이면 해당 GPU에서 가져올 수 있고, 실행 중인 인스턴스가 없으면 호스트 메모리의 복사본이 전송을 시작합니다. 모든 확장 후보 호스트에 같은 모델을 따로 남겨두지 않아도 된다는 점이 용량 측면의 이점입니다.
이 구조는 클러스터의 합산 메모리에 필요한 파라미터를 보관할 수 있고, 공급원의 위치가 유효하다는 전제를 둡니다. 유일한 호스트 캐시 복사본이 있던 장치가 고장 나면 해당 모델을 다시 복구하고 분산해야 합니다. 중복 캐시를 줄일수록 용량은 절약되지만, 공급원 배치와 장애 복구의 중요성은 커집니다.
받으면서 전달하는 가중치 배포
한 공급원이 모든 대상에 모델 전체를 각각 보내면 공급원의 송신 경로가 병목이 되기 쉽습니다. BlitzScale은 전송을 체인 형태로 연결합니다. 첫 대상이 앞부분을 받은 뒤 다음 대상으로 전달하는 동안, 공급원은 뒷부분을 계속 보냅니다. 서로 다른 링크가 모델의 다른 부분을 동시에 이동시키는 방식입니다.
큰 데이터를 적절한 링크에서 전송하면 대상 수만큼 공급원의 전송 시간을 반복하는 비용을 피할 수 있습니다. 다만 시작 지연, 전달 단계, 가장 느린 링크의 제한이 없어지는 것은 아닙니다. 수신과 전달이 충분히 겹치고 데이터가 큰 조건에서 유리한 방식이지, 임의의 네트워크에서 대상 수와 무관한 완전한 상수 시간을 보장하는 것은 아닙니다.
계획기는 NVLink처럼 빠른 로컬 연결을 가진 GPU를 묶고, 여러 호스트 간 경로로 서로 다른 가중치 조각을 보낸 뒤 로컬에서 모으는 방법도 사용합니다. 가능하면 느린 상위 네트워크를 거치지 않는 공급원을 선택합니다. 확장 요청이 들어온 뒤 최적의 전역 계획을 오래 계산할 수 없으므로, 빠르게 구성할 수 있는 탐욕적 계획을 사용합니다.
이 때문에 물리 연결 구조가 소프트웨어 정책에 직접 영향을 줍니다. 빠른 GPU 간 연결이 있는 그룹과 PCIe 중심의 그룹은 같은 방식으로 가중치를 나눠 받을 수 없습니다. 논문도 두 종류의 클러스터를 평가하며, 모든 환경에 같은 로컬 통신 성능이 있다고 가정하지는 않습니다.
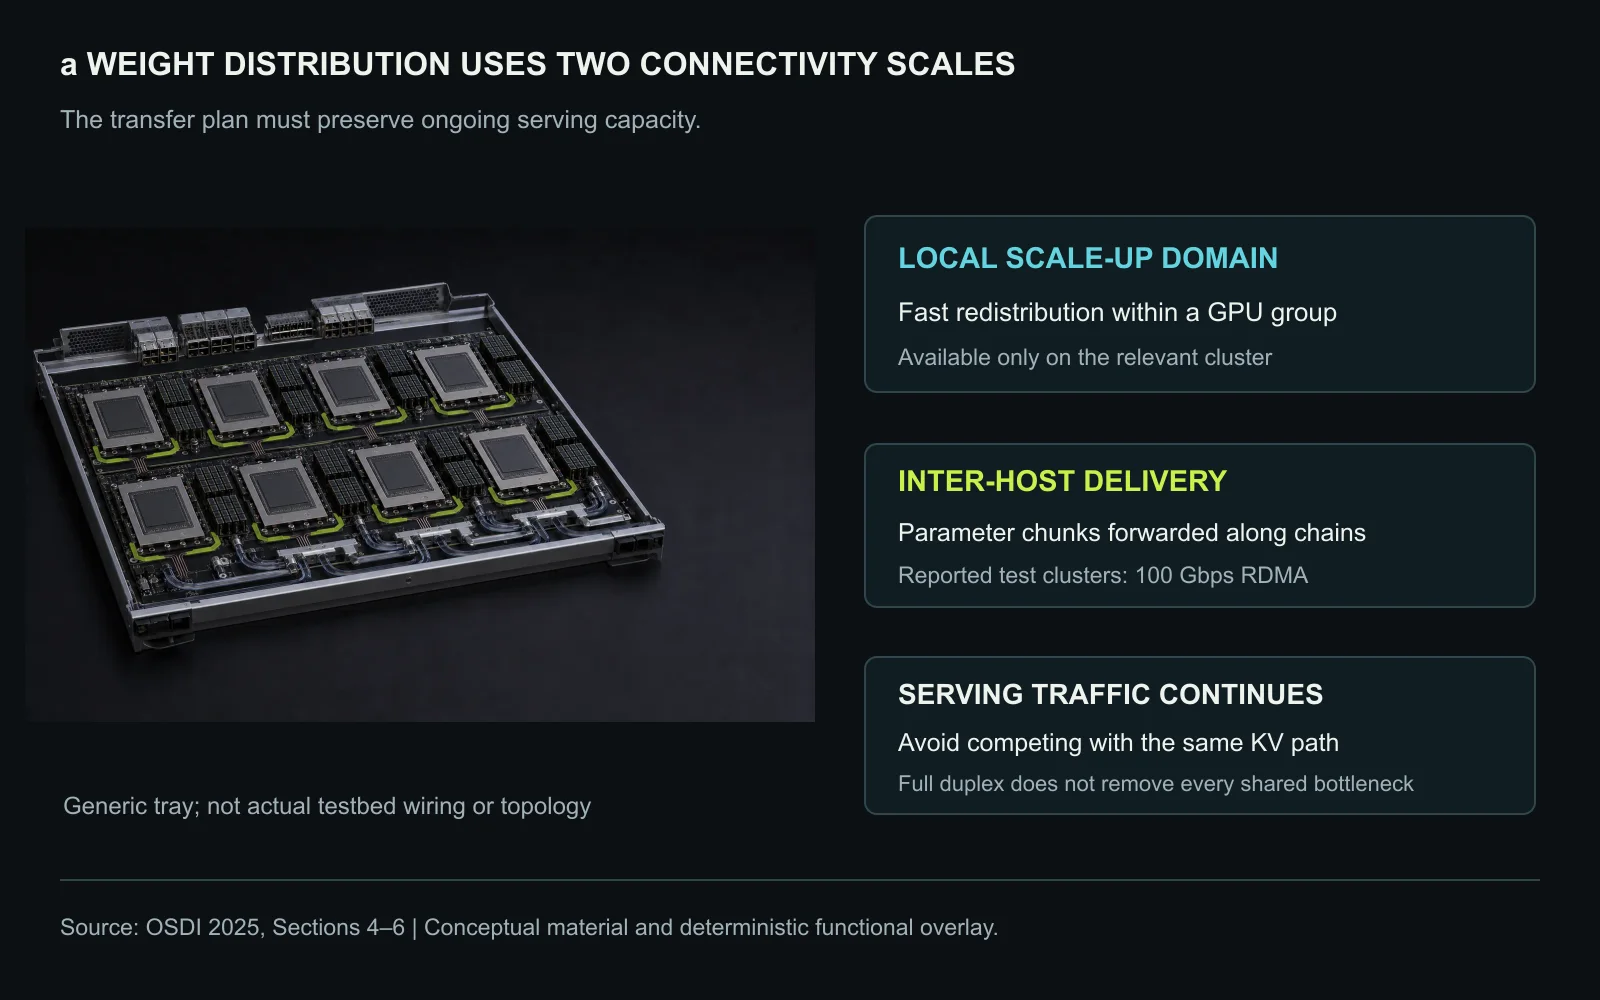
기존 서빙을 방해할 수 있는 확장 트래픽
프리필과 디코드를 분리한 구성에서는 프리필이 만든 KV 캐시를 디코드 인스턴스로 보내는 동안 새 인스턴스의 가중치도 전송해야 할 수 있습니다. 두 전송이 같은 송신 경로를 사용하면 기존 요청의 KV 이동이 늦어집니다. 모델 적재를 앞당겼더라도 이미 실행 중인 요청의 토큰 간격이 늘어난다면 확장의 목적을 충분히 달성한 것이 아닙니다.
BlitzScale은 서빙 트래픽의 방향을 고려해 공급원과 체인을 선택합니다. 예를 들어 프리필 인스턴스의 KV 송신과 경쟁하지 않도록 디코드 인스턴스에서 가중치를 가져오는 방법이 있습니다. 체인을 여러 개로 나누면 한 대상이 다음 대상에게 가중치를 전달하는 동시에 자신의 KV를 보내야 하는 경합도 줄일 수 있습니다.
전이중 링크를 사용하더라도 PCIe와 메모리 대역폭, 스위치를 다른 트래픽과 공유할 수 있으므로 모든 간섭이 사라지지는 않습니다. 논문은 빠른 로컬 그룹과 리프·스파인 구조로 네트워크를 단순화해 다루지만, 실제 운영에서는 전송 방향뿐 아니라 해당 경로에서 어떤 자원이 함께 사용되는지 확인해야 합니다.
일부 레이어만 준비된 인스턴스의 활용
전체 가중치가 도착해야 일을 시작할 수 있다면 전송 속도를 높여도 준비 구간은 남습니다. 새 인스턴스가 앞 레이어를 계산하면서 뒤 레이어를 적재하는 방식도, 그 인스턴스 혼자 결과를 완성해야 한다면 마지막 레이어를 기다려야 합니다. 계산과 적재가 겹친다는 사실만으로 즉시 추가 처리량이 생기지는 않습니다.
BlitzScale은 새 인스턴스를 과부하 상태의 기존 인스턴스와 연결합니다. 새 인스턴스가 준비된 앞부분을 계산하고 중간 활성값을 보내면, 기존 인스턴스가 나머지 레이어를 계산합니다. 요청 하나에 필요한 전체 모델 계산은 모두 수행합니다. 덜 적재된 모델로 불완전한 답을 만드는 방식이 아닙니다.
기존 인스턴스는 요청마다 처리할 레이어가 줄어 대기열을 더 빨리 소화할 수 있습니다. 가중치가 추가로 도착하면 새 인스턴스에 맡기는 범위도 늘어납니다. 전체 적재가 끝난 뒤에는 두 인스턴스가 각각 완전한 모델을 실행하며 정상적으로 요청을 나눕니다. 영구적인 모델 분할보다 확장 중의 부분적인 준비 상태를 활용하는 임시 실행 구조에 가깝습니다.
이득을 내려면 기존 인스턴스에서 덜어낸 계산량이 활성값 전송과 조정 비용보다 커야 합니다. 네트워크가 느리거나 대기 중인 요청이 적으면 협력 실행의 가치가 줄어들 수 있습니다. 따라서 준비된 레이어가 있다는 사실과 그 레이어를 원격으로 실행하는 편이 유리하다는 판단은 구분해야 합니다.
앞으로 도착할 레이어까지 활용하는 ZigZag
가장 단순한 정책은 현재 적재된 레이어를 새 인스턴스에서 최대한 실행한 뒤 즉시 기존 인스턴스로 넘기는 것입니다. 하지만 확장 초기에는 적재된 부분이 짧아 대부분의 계산이 기존 인스턴스에 남습니다. 새 인스턴스를 사용하고도 요청은 다시 기존 인스턴스 앞에서 오래 기다릴 수 있습니다.
ZigZag는 이 대기 시간에 다음 레이어가 도착한다는 사실을 활용합니다. 기존 인스턴스가 바쁘다면 요청을 곧바로 넘기지 않고, 새 레이어가 준비됐을 때 새 인스턴스에서 추가 계산을 수행할 수 있도록 남겨둡니다. 이미 처리한 요청을 다시 선택해 다음 레이어를 실행하므로, 시간이 지나면서 과부하 인스턴스에서 더 많은 일을 덜어냅니다.
논문은 파이프라인 분할을 위한 최적화 문제와, 매번 이를 풀지 않고 동작하는 우선순위 큐 기반 구현을 제시합니다. 요청 순서와 다음 레이어의 준비 여부를 함께 고려하고, 기존 인스턴스가 진행할 수 있을 때 작업을 가져갑니다. 의도적으로 기다리면 항상 빨라진다는 뜻이 아니라, 혼잡한 장치 앞에서의 대기를 새 장치의 유용한 계산으로 바꾸는 방식입니다.
디코드 확장에서 필요한 역할 전환
디코드 인스턴스를 직접 확장하면 가중치 수신과 KV 수신이 같은 방향에서 경쟁할 수 있습니다. 논문은 일부 프리필 인스턴스를 디코드로 전환하고, 줄어든 프리필 용량을 협력 실행으로 보충하는 방법을 사용합니다. 프리필과 디코드가 같은 모델의 가중치를 쓴다는 점을 활용한 전환입니다.
이 사례는 확장을 빈 GPU의 개수만으로 결정하기 어렵다는 것을 보여 줍니다. 이미 준비된 인스턴스의 역할에 따라 사용할 수 있는 데이터 경로와 전환 비용이 달라집니다. 구현은 토큰 처리 부하와 KV 점유량을 관찰하지만, 언제 얼마나 확장할지를 정하는 정책 전체를 해결한 것은 아닙니다. 논문도 워크로드별 정책과 MoE 등 모델 내부 병렬 구성 변경은 추가 연구 과제로 남깁니다.
실제 시험 환경과 비교 조건
평가에는 NVLink를 가진 A800 32개 클러스터와 PCIe 기반 로컬 연결을 가진 A100 16개 클러스터가 사용됐습니다. 보고된 두 시험 환경의 호스트 간 RDMA는 100 Gbps입니다. 본문에서 가능성을 설명하며 언급한 더 빠른 네트워크 수치를 실제 시험 조건으로 옮겨 적어서는 안 됩니다.
BurstGPT, AzureCode, AzureConv의 요청 기록은 시간적 패턴을 유지하면서 시험 클러스터에 맞게 크기를 조정했습니다. 평균 부하는 클러스터의 최대 처리 용량에 대한 비율로 설정했습니다. 주요 평가는 모델과 기록의 특정 조합을 사용하며, 모든 모델에 모든 기록을 교차 적용한 전수 시험은 아닙니다. 실제 기록을 활용했지만 대규모 운영 배포의 결과와는 구분해야 합니다.
자동 확장 기준은 ServerlessLLM이며, 필요한 호스트 캐시가 항상 있다고 가정한 AllCache도 비교합니다. 같은 확장 정책을 적용해 캐시 미스와 전송 방식의 영향을 구분합니다. 캐시가 없는 기존 시스템만 상대로 개선을 보인 것인지, 캐시가 있어도 추가 이득이 남는지 확인하기 위한 구성입니다.
하나로 묶으면 안 되는 지연 감소율
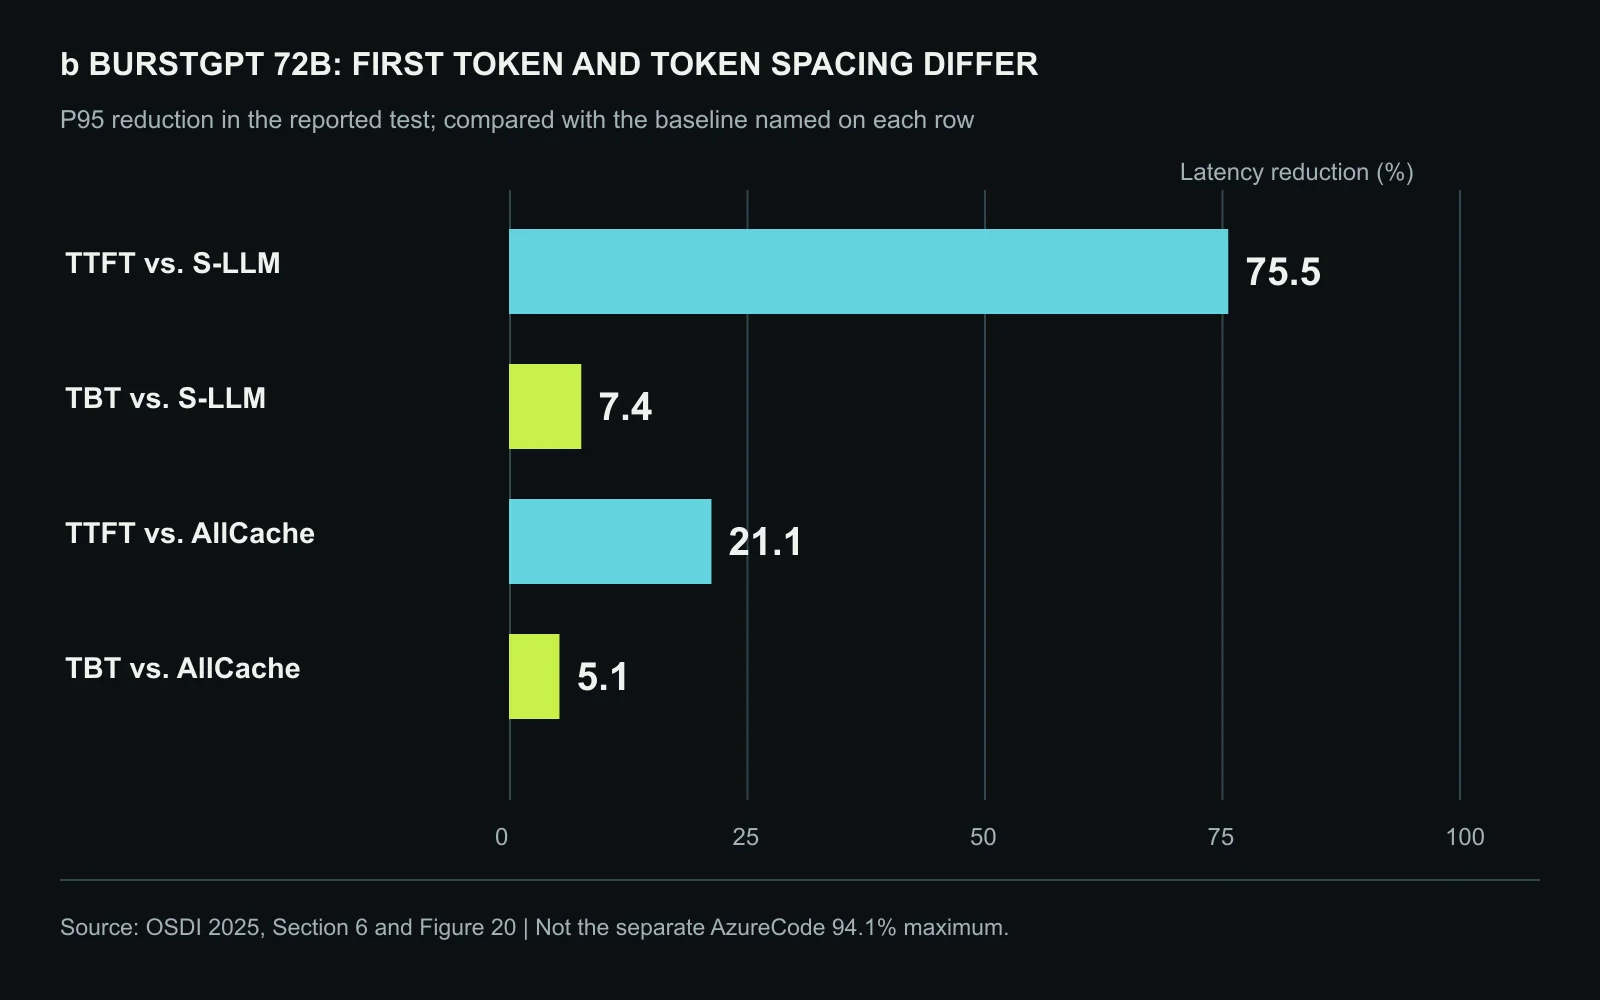
BurstGPT와 72B 모델 조합에서 보고된 P95 첫 토큰 지연 감소율은 ServerlessLLM 대비 75.5%입니다. 같은 시험의 토큰 간격 감소율은 7.4%로 훨씬 작습니다. AllCache와 비교하면 첫 토큰 지연은 21.1%, 토큰 간격은 5.1% 줄어듭니다. 무엇을 기준으로 어느 지연을 줄였는지 함께 봐야 합니다.
약 94%라는 큰 토큰 간격 개선은 AzureCode의 8B 모델 시험에서 나옵니다. 버스트 간격과 캐시 제거, 디코드 확장 시점 때문에 느린 적재가 특히 불리해진 조건입니다. 다른 시험에서는 디코드 용량을 미리 준비할 수 있어 토큰 간격 개선이 작습니다. 최대값을 모든 모델의 디코드 성능으로 일반화할 수 없습니다.
별도의 24B 모델 시험에서는 프리필 인스턴스 6개를 확장하는 데 약 1.2초가 걸렸고, AllCache는 약 2초가 걸렸습니다. 전체 적재가 끝나기 전부터 처리에 기여하는 모습도 제시합니다. 이 결과는 유용한 용량이 생기는 시점과 완전한 준비 시점의 차이를 보여주지만, 모든 모델을 1초 이내에 시작할 수 있다는 보장은 아닙니다.
GPU 사용 시간과 설비 절감의 차이
AzureConv의 24B 비교에서 BlitzScale의 GPU 사용 시간은 전체 용량을 고정 배치한 기준의 51.62%로 표시됩니다. ServerlessLLM은 71.08%입니다. 여기서 GPU 사용 시간은 시점별 할당 GPU 수를 시험 기간에 걸쳐 합산한 값입니다. 두 백분율의 차이를 같은 숫자의 상대 감소율로 읽으면 안 됩니다.
시험의 지연 목표를 만족하면서 GPU 사용 시간을 줄였다는 점은 자원 효율의 근거가 됩니다. 그러나 그 비율만큼 GPU 구매량이나 전력비, 전체 운영비가 줄었다는 뜻은 아닙니다. 반환한 GPU를 다른 모델이 사용할 수 있는지, 여러 모델의 부하가 동시에 늘어나는지, 장애에 대비한 예비 용량을 얼마나 남겨야 하는지에 따라 실제 절감이 달라집니다.
전체 용량을 미리 배치한 시스템이 요청을 더 빨리 처리하더라도, 자동 확장은 필요한 지연 수준을 더 적은 자원으로 맞추는 데 의미가 있습니다. 따라서 비교할 때 허용 지연과 위반 비율을 명확히 해야 서로 다른 운영 지점을 같은 성능으로 취급하지 않습니다.
도입 전 확인할 전환 과정
실제 도입에서는 확장 필요를 감지하는 시간, 추가 처리량이 처음 생기는 시간, 새 인스턴스가 독립적으로 준비되는 시간을 따로 측정해야 합니다. 이미 대기열이 허용 범위를 넘은 뒤 확장 신호가 나온다면 가중치를 빠르게 보내는 것만으로는 해결하기 어렵습니다. 부하 감지와 데이터 이동을 함께 검증해야 합니다.
공급원 장애와 모델 버전 일치도 중요합니다. 서로 다른 버전의 가중치가 우연히 준비돼 있다는 이유로 한 요청의 앞뒤 레이어를 섞어 실행해서는 안 됩니다. 전역 파라미터 관리와 임시 레이어 분할에서는 데이터의 위치뿐 아니라 모델의 동일성과 전환 상태도 정확성의 일부입니다. 적재 중 실패나 취소가 발생했을 때의 복구를 시험해야 합니다.
마지막으로 기존 KV 전송과 다른 서빙 트래픽이 흐르는 상태에서 가중치를 배포해야 합니다. 활용 가능한 대역폭은 비어 있는 링크의 명목 속도가 아니라 버스트 시점의 실제 경로에 남는 여유입니다. BlitzScale의 중요한 제안은 덜 준비된 자원도 유용하게 쓸 수 있다는 것이며, 운영상의 가치는 그 도움을 기존 요청의 안정성을 해치지 않고 얼마나 일찍 제공하느냐에 달려 있습니다.
출처와 저작권 안내
이 글은 OSDI 2025 논문을 검토해 독립적으로 작성한 편집 분석입니다. 원문 저작권은 저자들에게 있으며(© 2025), 측정값은 원문의 보고이고 운영 적용에 관한 설명은 본지의 해석입니다. 도판은 이 글을 위해 새로 만들었으며, 개념적인 하드웨어 재질 표현은 시험 장비의 사진이나 실제 배선 명세가 아닙니다.