스토리지 벤치마크는 가장 큰 숫자 하나로 제품 순위를 정하지 않을 때 더 유용합니다. MLPerf 스토리지 2.0에는 26개 기관이 제출한 200건 이상의 성능 결과가 실렸습니다[1]. 로컬 드라이브, 공유 파일시스템, 블록과 객체 스토리지, 소프트웨어 정의형 시스템, 스토리지 내부 가속까지 구성이 다양합니다. 이를 하나의 순위로 합치면 작업부하와 구성의 차이가 사라집니다. 대신 이 벤치마크는 운영자가 실제로 궁금해하는 두 질문을 일정한 조건으로 바꿉니다. 이 스토리지는 몇 개의 가속기를 쉬지 않게 만들 수 있습니까? 장애가 난 학습 작업의 상태를 얼마나 빨리 저장하고 복구할 수 있습니까?
순차 대역폭 사양만으로는 답하기 어려운 질문입니다. 학습에서는 여러 프레임워크 데이터 로더가 많은 파일을 읽고, 수천 개 워커가 보조를 맞춰 전진합니다. 체크포인트를 만들 때는 방향이 바뀌어 모든 랭크가 거의 동시에 상태를 씁니다. 한 경로에서 빠른 시스템이 다른 경로에서도 빠르다는 보장은 없습니다. 그래서 2.0은 학습과 체크포인트 시험을 분리하고, 각 결과의 설정과 로그, 시스템 설명을 함께 공개합니다[2].
GPU를 모사해야 더 큰 스토리지를 시험할 수 있는 조건
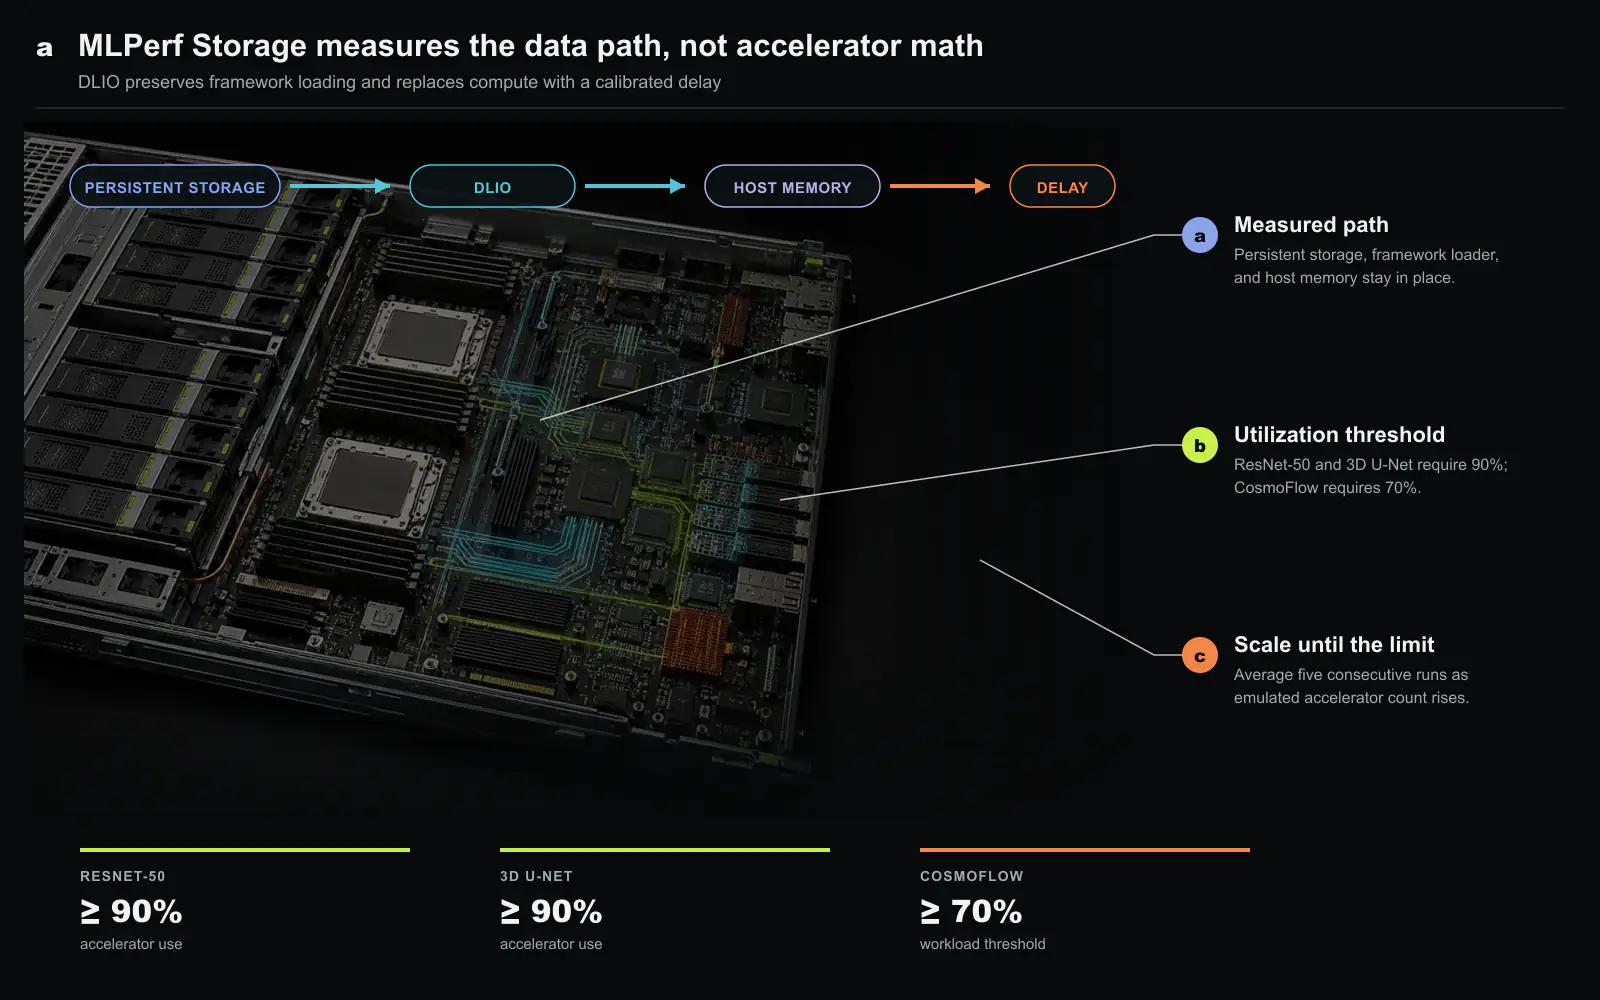
학습 시험에서 제출자가 결과에 적힌 GPU를 실제로 보유할 필요는 없습니다. Argonne National Laboratory가 개발한 DLIO는 프레임워크의 데이터 경로를 그대로 실행하되, 각 batch의 가속기 연산 시간을 측정값에 맞춘 sleep()으로 대신합니다. PyTorch나 TensorFlow는 실제처럼 스토리지에서 호스트 메모리까지 파일을 읽습니다. A100 또는 H100이 계산했을 시간만 모사하는 방식입니다. 호스트 메모리에서 가속기 메모리로 옮기는 구간은 측정 대상이 아닙니다.
이 설계 덕분에 가속기 수를 장비 구매비가 아니라 시험 변수로 쓸 수 있습니다. 모사 가속기 수를 늘리다가 I/O가 목표 이용률을 유지하지 못하는 지점을 찾습니다. 결과에는 연속된 다섯 번의 실행이 필요하며 최종값은 그 평균입니다. 여러 실행 가운데 좋은 결과만 골라 중간 실패를 버릴 수 없습니다. 따라서 가속기 수는 순간 최고점이 아니라 일정 시간 유지한 동작점입니다.
통과 기준도 작업부하마다 다릅니다. 작은 ImageNet 계열 레코드를 읽는 ResNet-50은 가속기 이용률 90% 이상을 요구합니다. 큰 의료 영상 샘플을 다루는 3D U-Net도 90%입니다. 반면 CosmoFlow는 자체 연산과 I/O 특성을 반영해 70%를 기준으로 씁니다[2]. 모든 결과에 90% 기준을 적용하면 정상적인 CosmoFlow 제출 결과를 잘못 탈락시키게 됩니다.
대역폭과 확장 규모는 서로 다른 답
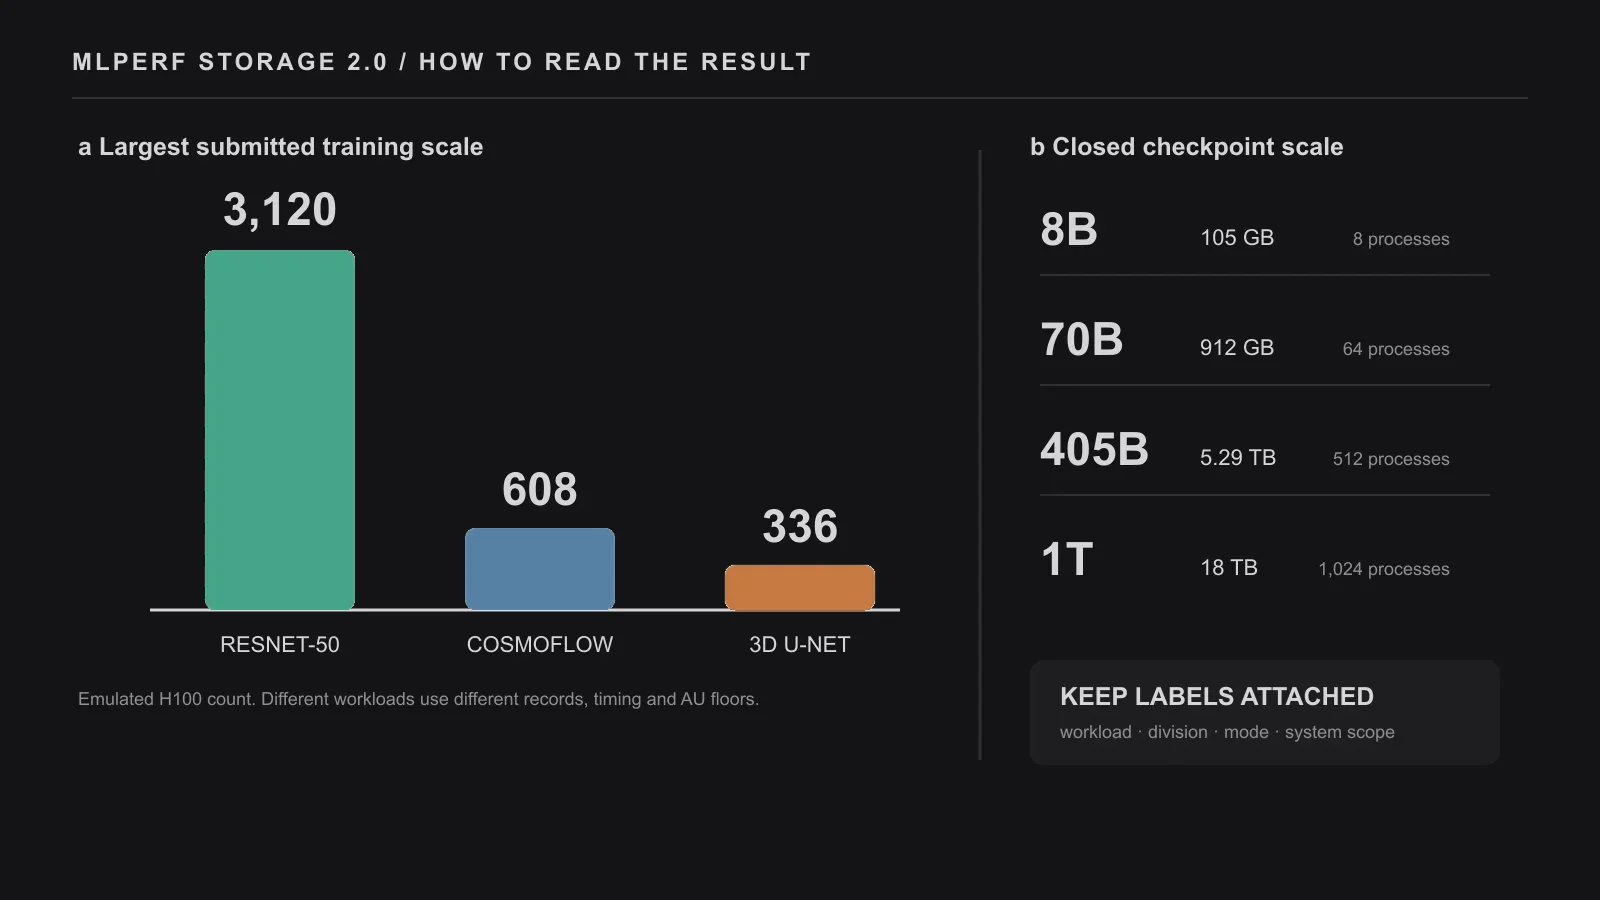
공개된 CSV 결과는 두 축을 함께 봐야 하는 이유를 보여 줍니다[3]. 제출된 학습 구성 가운데 가장 큰 규모는 ResNet-50에서 모사 H100 3,120개, CosmoFlow에서 608개, 3D U-Net에서 336개였습니다. 하지만 가장 높은 평균 I/O 대역폭은 세 작업부하 모두 이 최대 규모에서 나오지 않았습니다. ResNet-50은 H100 2,160개에서 약 384 GB/s, CosmoFlow는 528개에서 약 280 GB/s, 3D U-Net은 176개에서 약 490 GB/s였습니다.
이 수치를 제품 순위 세 줄로 읽으면 안 됩니다. 레코드 크기, 배치, 모사 연산 시간, 이용률 기준이 작업부하마다 다릅니다. 같은 작업부하 안에서도 가장 많은 가속기를 유지한 실행과 가장 높은 대역폭을 낸 실행이 다를 수 있습니다. 확장 규모는 이용률 하한을 지키며 어디까지 갈 수 있는지를 말합니다. 대역폭은 그 곡선의 특정 지점에서 이동한 데이터 양입니다. 구매 검토에는 둘 다 필요합니다.
세 학습 작업부하는 1.0과 2.0 사이의 비교 가능성도 유지했습니다. MLCommons는 이번에 제출된 시스템이 이전 버전보다 대략 두 배 많은 가속기를 지원했다고 설명합니다[1]. 다만 이는 전체 결과군의 관찰이지 모든 스토리지 구조가 두 배 빨라졌다는 뜻은 아닙니다. 소프트웨어 버전, 클라이언트 수, 네트워크 토폴로지, 제출 시스템의 크기는 각 공개 자료에서 따로 확인해야 합니다.
1조 매개변수 체크포인트는 모두가 함께 멈추는 사건
새 체크포인트 시험은 Llama 8B, 70B, 405B, 1T의 네 규모를 모사합니다. 8B, 70B, 405B의 전체 상태는 각각 105GB, 912GB, 5.29TB로 적혀 있습니다. 1T는 문서 버전까지 붙여 말해야 합니다. 공개 당시 기술 설명은 15TB(이 중 옵티마이저 상태 13.2TB), 현재 규칙 표는 18TB로 표시합니다[2][4]. 비교 조건을 고정한 closed 부문에서는 프로세스 수가 각각 8, 64, 512, 1,024개입니다. 전체(default) 모드는 분산 체크포인트 전체를 쓰고 읽습니다. 한 호스트가 자기 몫만 시험하는 부분(subset) 모드도 있지만 이동하는 데이터 양이 다르므로 같은 조건처럼 비교할 수 없습니다.
각 제출 결과는 체크포인트를 열 번 쓰고, 필요하면 파일시스템 캐시를 비운 뒤, 다시 열 번 읽습니다. 쓰기가 끝난 데이터가 영구 스토리지에 도달하도록 fsync도 켭니다. 실행시간은 모든 프로세스 가운데 가장 늦은 값으로, 처리량은 가장 느린 프로세스의 속도로 정합니다. 분산 작업은 마지막 프로세스가 준비돼야 재개할 수 있으므로 의도적으로 보수적인 집계입니다.
전체 규모 결과는 사건의 크기를 보여 줍니다. 한 closed 405B 결과는 5.29TB 체크포인트를 평균 5.69초, 930.2GB/s로 썼습니다. 다른 결과는 같은 모델 규모를 8.01초, 660.9GB/s로 복구했습니다. 1T closed 결과 하나는 쓰기 34.82초와 444.6GB/s, 읽기 22.29초와 692.4GB/s를 보고합니다. 해당 CSV의 checkpoint_size_GB는 15,426.6입니다. 제출 처리량을 재계산할 때는 이 원시 필드를 분모로 써야 합니다. 공식 설명의 15TB와 현재 규칙의 18TB는 서로 다른 문서에 붙은 명목값이지, 계산할 때 임의로 바꿔 넣을 숫자가 아닙니다. 이런 문서 변화 때문에 벤치마크 결과에는 규칙 버전과 원시 파일을 함께 붙여야 합니다.
숫자마다 네 개의 꼬리표가 필요한 조건
MLPerf 스토리지 수치는 작업부하, 부문, 모드, 시스템 범위를 떼는 순간 오해하기 쉽습니다. open 부문은 변경 내용을 공개하면 지정 설정을 바꿀 수 있습니다. closed 부문은 비교 가능성을 위해 변경을 제한합니다. 로컬 부분 체크포인트는 한 노드에 배정된 샤드만 측정하지만 전체 모드는 분산 상태 전부를 포함합니다. 클라이언트 노드와 네트워크도 제출 시스템의 일부이므로 스토리지 장비 이름만으로는 결과를 재현할 수 없습니다.
캐시 처리도 중요합니다. 클라이언트별 체크포인트 몫이 메모리에 남을 만큼 작으면 규칙에 따라 읽기 전에 캐시를 비워야 합니다. 다른 호스트가 체크포인트를 읽기 전에 스토리지 재매핑이 필요하다면 그 시간도 복구 결과에 더합니다. “저장은 끝났다”와 “다른 호스트에서 복구할 수 있다”가 서로 다른 주장이 되지 않게 만든 규정입니다.
빠진 범위도 분명합니다. 학습 연산은 모사되며 호스트와 가속기 메모리 사이의 전송은 제외됩니다. 2.0은 온라인 또는 오프라인 전처리도 측정하지 않습니다. 실제 애플리케이션의 버스트 정렬, 메타데이터 부하, 장애 양상을 모두 재현하는 시험도 아닙니다. 그러므로 이 결과만으로 구매 결정을 끝낼 수는 없습니다. 대신 스토리지가 확장을 멈추는 지점을 반복 가능한 방법으로 찾아, 다음 단계의 애플리케이션 시험을 어디서 시작할지 알려 줍니다.
체크포인트 대역폭은 신뢰성 용량
스토리지 구매에서는 학습 I/O와 체크포인트를 두 종류의 처리량 시험으로 보기 쉽습니다. 그러나 클러스터 규모에서는 경제적 역할이 다릅니다. 학습 I/O는 정상 실행 중 가속기에 데이터를 제때 공급하는지를 정합니다. 체크포인트는 장애가 잦아질 때 얼마만큼의 작업 손실을 감당할지를 정합니다. 체크포인트 경로가 빨라지면 저장 간격을 줄이고 되돌아갈 작업량을 낮추며, 복구한 작업을 더 빨리 재개할 수 있습니다. 입력 데이터셋과 GPU당 데이터 속도가 같아도 클러스터가 커질수록 그 가치가 올라갑니다.
따라서 최고 GB/s를 지원 GPU 수로 바로 바꿀 수 없습니다. 체크포인트 크기, 동시 쓰기 시간, 복원 시간, 장애 간격, 프레임워크가 멈추는 방식, 모사 가속기에 적용한 이용률 하한이 함께 필요합니다. 가장 느린 랭크나 저장 대상이 배리어에서 전체 작업을 기다리게 할 수 있으므로 꼬리 시간도 중요합니다. 최고 속도가 낮아도 완료 시간 분포가 좁은 시스템이 총 대역폭은 높지만 꼬리가 긴 시스템보다 더 많은 학습 진척을 보호할 수 있습니다.
인수 시험은 MLPerf의 두 모드를 하나의 유효 가속기 시간 지표로 연결해야 합니다. 정상 학습 이용률을 측정하고 실제 간격으로 체크포인트를 시작한 뒤 장애를 주입해 최근 상태를 복원하며, 전체 주기에서 작업에 기여한 가속기 시간을 보고합니다. 공유 네오클라우드의 간섭을 반영하려면 메타데이터 부하와 동시 작업 조건에서도 시험을 반복해야 합니다. MLPerf 스토리지 2.0은 구성 요소를 비교할 재현 가능한 방법을 제공합니다. 구매자는 이를 임대한 가속기 시간 중 데이터 공급과 복구를 모두 통과한 비율이라는 최종 지표로 구성해야 합니다.
결과는 제품명이 아닌 구성
MLPerf Storage 결과는 클라이언트 수, 모델, 체크포인트 패턴, 스토리지 구성, 네트워크, 용량, 캐시 상태, 소프트웨어 버전에 묶입니다. 이 꼬리표를 떼면 재현 가능한 측정이 아니라 홍보 수치가 됩니다. 모사 GPU 방식은 실제 가속기 없이 큰 스토리지를 시험하는 장점이 있지만, 클라이언트 CPU나 네트워크가 요청을 제시간에 만들지 못하면 부하 생성기를 측정하게 됩니다. 클라이언트 자원 사용과 I/O 발행 시점도 확인해야 합니다.
따뜻한 캐시는 반복 학습이나 조정된 운영 경로를, 차가운 캐시는 첫 실행과 복구를 나타낼 수 있습니다. 어느 조건인지 밝히고 가능하면 둘을 함께 보여 줘야 유지한 캐시에 성능이 얼마나 의존하는지 알 수 있습니다.
점수를 체크포인트 마감 시간으로 바꿔야 할 이유
체크포인트 바이트, 주기, 작성자 수, 허용 중단, 복구 시점 목표에서 필요한 지속 대역폭을 계산해야 합니다. 메타데이터, 동기화, 복제, 꼬리 지연의 여유도 더해야 합니다. 데이터 적재와 집합 통신이 함께 있는 조건에서 모든 작성자가 끝나고 다음 보호 시점 전에 복구 가능한 상태가 되는지가 최종 결과입니다.
빠른 체크포인트는 주기를 줄여 장애 뒤 잃는 작업을 줄이지만 배경 대역폭과 용량을 더 사용합니다. 장애율, 체크포인트와 재시작 시간, 저장 비용을 함께 놓아야 최적 주기를 정할 수 있습니다.
확장 결과에는 장애 상태가 붙어야 할 이유
스토리지 노드를 늘려 대역폭을 높이면 체크포인트가 더 많은 구성 요소에 의존할 수 있습니다. 노드와 경로 장애, 저하 상태의 처리량, 재구축 영향이 마감 시간을 지키는지 시험해야 합니다. 전체 체크포인트 수명주기에는 생성뿐 아니라 시작, 메타데이터, 삭제, 보존, 동시 데이터셋도 포함됩니다.
표준 재생과 구매자의 체크포인트 크기, 작성자 수, 순간 부하, 데이터 트래픽, 장애를 반영한 재생을 함께 수행하는 것이 좋습니다. 비용은 복제 뒤 사용 용량과 네트워크, 전력, 예비 자원까지 포함해 마감 시간 안에 커밋한 바이트나 보호한 가속기 시간으로 나눠야 합니다. 표준 점수에 구성과 마감 시간, 저하 운전, 실제 작업을 붙일 때 구매 근거가 됩니다.
출처와 저작권 안내
이 글은 Silicon & Systems가 MLPerf 스토리지 2.0 규칙, 체크포인트 기술 설명, 발표 자료, 공개 결과 파일을 분석해 작성한 편집 글입니다. 설명과 도판은 모두 새로 만들었으며 원문의 표나 도판을 옮기지 않았습니다. MLPerf는 MLCommons의 상표입니다. 벤치마크 코드와 결과 저장소는 Apache License 2.0으로 배포되며, 공개 배경은 공식 결과 발표에서 확인할 수 있습니다. 업체별 보충 설명은 독립 평가가 아니라 제출자의 공개 자료로 취급했습니다.