모든 HBM 시스템은 같은 데이터 이동 비용을 부담합니다. DRAM 스택은 연산 다이에서 수 밀리미터 떨어져 있고, 둘은 인터포저와 양쪽 PHY를 거쳐 통신합니다. 비트 하나를 HBM4 베이스 다이로 옮기는 데만 약 2.4pJ이 듭니다. 토큰을 하나씩 생성하는 디코드 단계에서는 출력 토큰마다 활성 가중치와 KV 상태를 연산기 앞으로 가져와야 하므로 이 비용이 모든 바이트에 반복됩니다. ISCA 2026의 Raptor 논문과 뒤이은 Hot Chips 발표는 다른 길을 제시합니다. TSMC 4nm 연산 다이를 커스텀 DRAM에 맞대어 붙여 긴 전기적 인터페이스 자체를 없애는 방식입니다[1][2]. 36µm 마이크로범프 피치의 수직 인터페이스는 비트당 0.37pJ, HBM4 경로의 약 1/6.5 에너지로 동작합니다. 제품 목표는 카드 한 장의 메모리 대역폭 100TB/s입니다. 함께 봐야 할 숫자는 용량 32GB입니다.
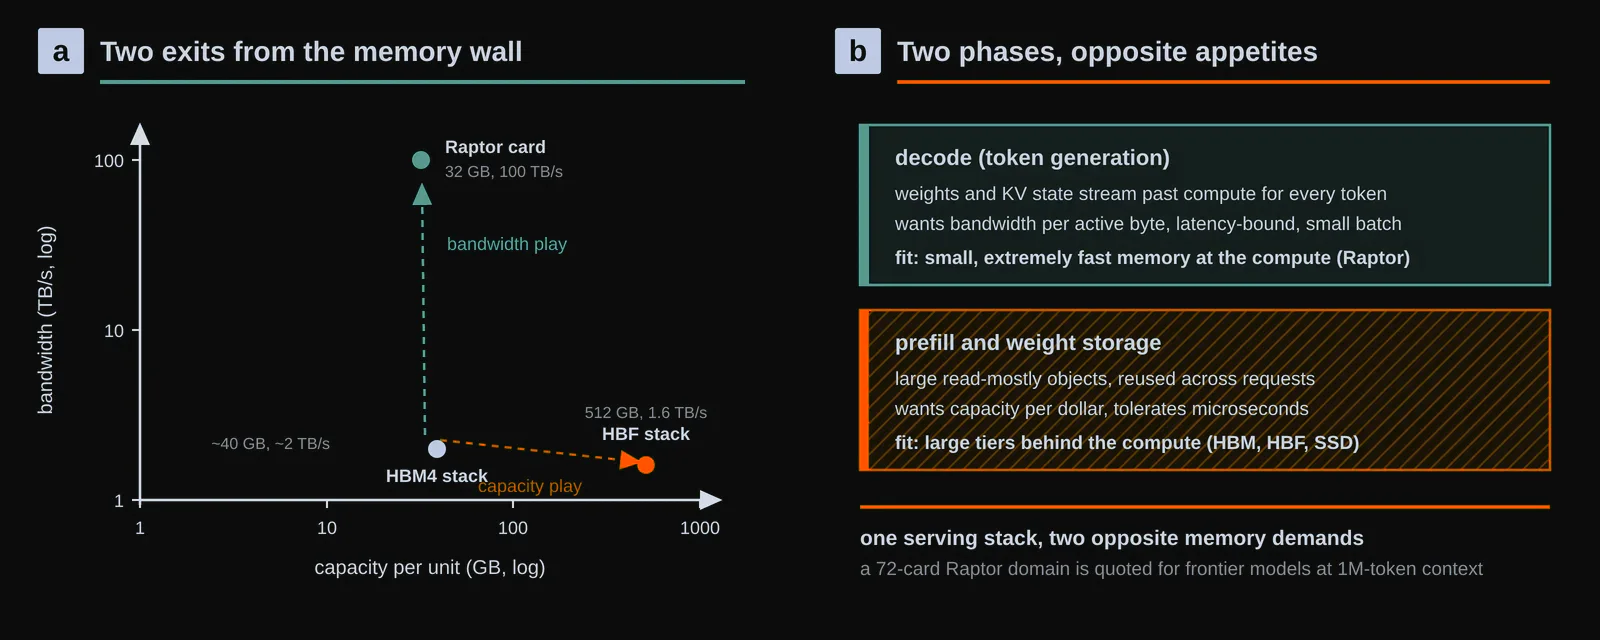
HBF 규격이 HBM급 대역폭에 512GB 스택을 약속한 지 3주 만에 나온 Raptor는 교과서적인 대조군입니다. 메모리 벽은 지금 양쪽 끝에서 동시에 공략당하고 있습니다. HBF는 지연을 내주고 용량을 얻고, Raptor는 용량을 내주고 대역폭을 얻습니다. 아래에서는 아키텍처와 이를 성립시키는 패키징 선택, 그리고 실제로 입증된 범위가 어디까지인지를 정리합니다.
SRAM에서 적층 DRAM으로
Raptor는 d-Matrix가 수년째 쌓아 온 아키텍처의 2막입니다. 현재 출하 중인 가속기 Corsair는 디지털 인메모리 컴퓨팅(DIMC)을 구현합니다. 곱셈 누산 로직이 메모리 어레이 안에 살고 있어, 가중치는 제자리에 있고 연산이 데이터 쪽으로 옵니다. Corsair 칩렛 하나는 DIMC 코어 256개와 SRAM 256MB를 담는데[5], 바이트당 대역폭은 압도적이지만 용량은 메가바이트 단위로 배급됩니다. 모델은 수많은 칩렛에 쪼개져야 하고, SRAM의 비트당 비용이 그 확장의 상한을 긋습니다. 자연스럽게 이어지는 질문은 같은 메모리 중심 연산 구조를 DRAM의 높은 집적도 위에 구현할 수 있느냐는 것이었습니다.
3DIMC가 그 답인데, 스타트업치고는 준비 과정이 구체적입니다. 2025년 11월에 Alchip과 공동 개발한 커스텀 DRAM 다이를 발표했고[4], Pavehawk라는 전용 테스트 칩으로 DRAM과 로직의 적층 조합을 실험실에서 검증했습니다[5]. ISCA 논문은 제품 발표에서 보기 어려운 부분을 더합니다. 폭이 넓고 뱅크 수가 많으며 열까지 받는 DRAM 스택을 실제로 운용하는 데 필요한 장치를 설명하고, 생성형 AI 작업부하 여섯 개로 평가합니다[1]. Hot Chips 발표는 여기에 제품과 패키징 관점을 보탭니다.
뒤집힌 스택
패키징은 모든 HBM 시스템이 쓰는 배치를 뒤집었고, 뒤집음마다 이유가 있습니다. 로직이 위로 갑니다. 수랭 콜드 플레이트가 4nm 연산 다이에 직접 닿으므로 열에 민감한 DRAM을 거쳐 열을 빼낼 필요가 없습니다. DRAM은 아래에서 인터포저 역할도 맡습니다. PCIe와 다이 간(D2D) 신호가 DRAM 다이의 TSV를 타고 패키지 기판까지 내려가므로 메모리 다이가 저장소이자 배선이 됩니다[2][7]. 두 다이 사이에는 SerDes도 PHY도 인터포저 횡단도 없고 36µm 피치의 면대면 마이크로범프만 있습니다. PHY는 긴 거리를 안정적으로 건너기 위한 회로입니다. 거리를 없애면 PHY의 전력과 지연도 함께 줄일 수 있습니다.
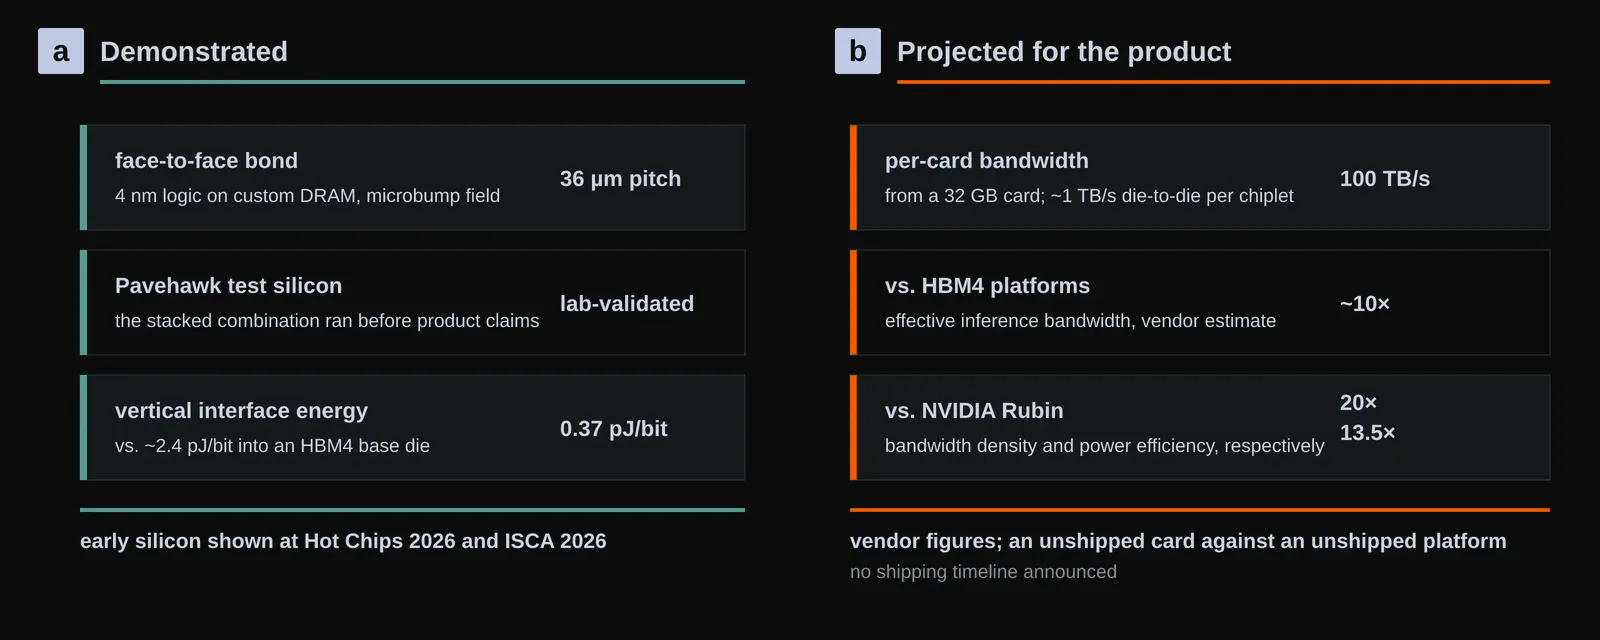
주장되는 효과는 곱으로 쌓입니다. 비트당으로는 수직 인터페이스가 0.37pJ, HBM4 경로의 약 2.4pJ와 대비됩니다. 카드당 합산 메모리 대역폭 목표는 약 100TB/s입니다. d-Matrix는 이를 HBM4 기반 플랫폼 대비 유효 추론 대역폭 약 10×로 설명하고, NVIDIA Rubin 세대와 비교해 메모리 서브시스템의 대역폭 밀도 약 20×, 전력 효율 13.5×를 주장합니다[7]. 이 제품 수준 비교는 출하 카드의 독립 측정이 아니라 회사의 전망입니다.
논문의 기여는 눈에 덜 띄지만 실현 가능성을 판단할 때 더 중요합니다. 스트림 블로킹은 KV 캐시 트래픽을 설정 가능한 수의 3D-DRAM 채널에 배치합니다. 별도 핀 없이 동작하는 데이터 버스 반전(DBI)은 한 사이클에 많은 마이크로범프가 동시에 스위칭할 때 생기는 전력 부담을 낮춥니다. 토폴로지를 보존하는 여분 자원은 고장난 부분을 대체해도 채널 구성을 유지하며, 온도를 고려한 리프레시와 인터리브 ECC는 로직 아래에서 더 뜨거워진 DRAM의 오류 위험을 다룹니다. 두 다이를 붙이면 거리는 줄지만 매핑, 전력, 고장, 열 문제가 생깁니다. 논문은 네 문제에 각각 대응하는 장치를 제안합니다[1].
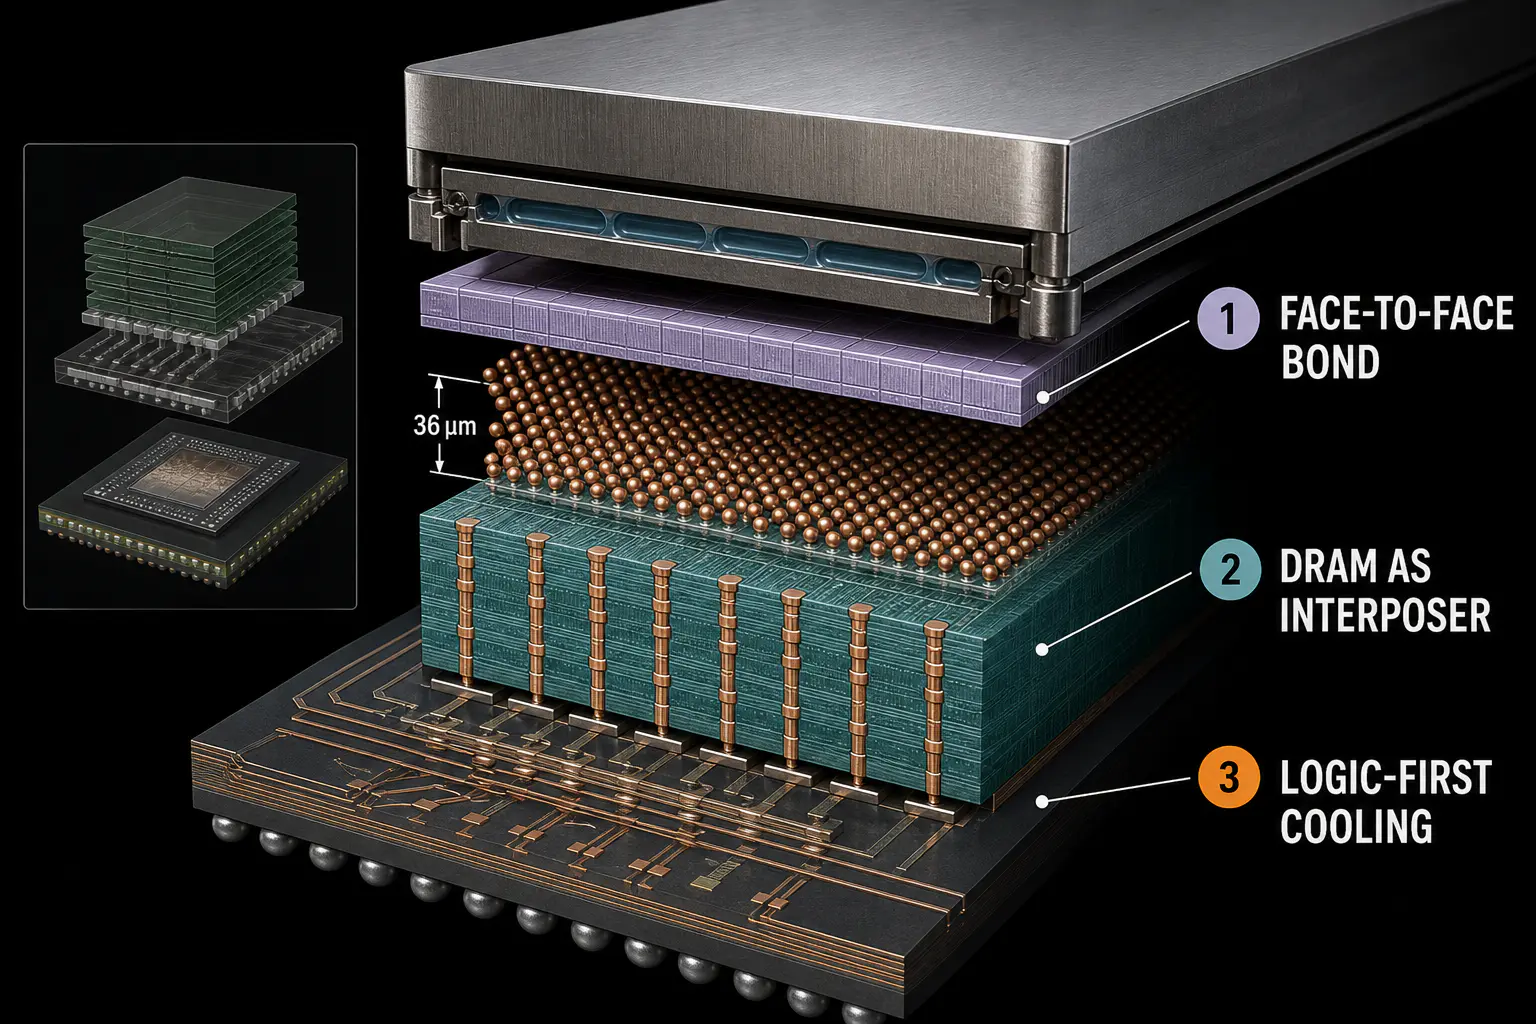
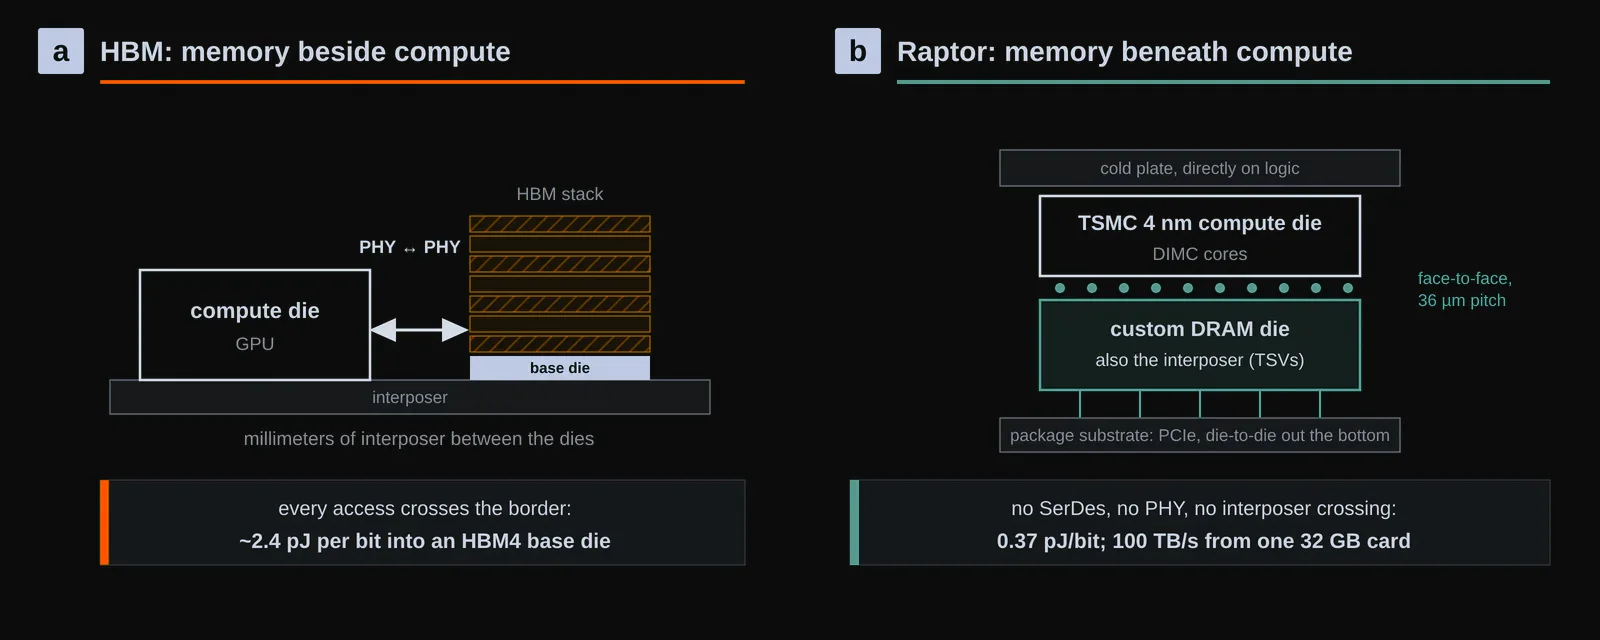
32GB가 제공하는 이점과 제약
32GB 카드 한 장에는 최상위 AI 모델이 들어가지 않습니다. 따라서 여러 카드를 하나의 배치로 묶어야 합니다. 회사가 제시한 예에서는 카드 72장의 스케일업 도메인이 100만 토큰 컨텍스트의 Kimi K3급 모델을 나누어 담고, 칩렛당 약 1TB/s의 D2D 대역폭으로 모델 조각을 연결합니다[2]. 지연시간이 중요한 소규모 배치 생성에서는 작지만 빠른 메모리 여러 개가 크지만 상대적으로 느린 메모리 몇 개보다 유리할 수 있다는 판단입니다. HBF와 반대 방향처럼 보이지만 겨냥하는 구간이 다릅니다. 디코드는 활성 데이터에 대한 대역폭을 원하고, 프리필과 가중치 보관은 큰 용량을 원합니다.
장점만큼 유보 조건도 분명합니다. 카드당 용량이 HBM4급 GPU의 약 1/16이므로 활용률은 샤딩 소프트웨어와 카드 사이 인터커넥트에 달려 있습니다. 본지의 스케일업 패브릭 리뷰에서 다뤘듯 규모가 커지면 최고 대역폭뿐 아니라 지연시간의 예측 가능성도 중요합니다. 스타트업과 디자인 서비스 파트너의 커스텀 DRAM은 HBM 업체들이 10년간 다듬은 공급망과 수율을 새로 확보해야 합니다. 로직 아래 DRAM의 열 문제도 뒤집힌 스택으로 관리할 뿐 없어지는 것은 아닙니다. 상용 공급 시점과 대량 구매 가격은 아직 발표되지 않았습니다. 현재 공개된 증거는 초기 실리콘, 학회 평가, 그리고 향후 제품 사양입니다.
주장을 증거 등급별로 정렬하면
증거는 세 단계로 나누어 읽는 편이 정확합니다. 첫째는 소자 증거입니다. Pavehawk는 3D 접합이 동작함을 확인했고 수직 인터페이스에서 약 0.37pJ/bit를 보고했습니다. 둘째는 논문 평가입니다. 작업부하에는 음성 모델 Whisper와 Canary, 언어 모델 Llama 3.1 70B, DeepSeek-V3, Kimi K2, GPT-OSS가 포함됩니다. ISCA 연구는 이 결과군에서 자사 HBM 구성보다 4.71×, SRAM 구성보다 2.44× 높은 처리량을 보고하고, 네트워크 지연시간과 대역폭 변화에 대한 민감도도 시험했습니다[1]. 이는 논문의 모델링 및 초기 실리콘 방법론 안에서 비교한 결과이며 시판 GPU 카드와의 실측 대결은 아닙니다. 셋째는 제품 전망입니다. 카드당 100TB/s, HBM4 플랫폼 대비 약 10×, Rubin 대비 대역폭 밀도 20×와 전력 효율 13.5×가 여기에 속합니다. 아직 출하되지 않은 시스템끼리의 비교이므로 논문 평가와 한데 묶으면 안 됩니다. 파네시아의 CXL 스위치 논문에서 실리콘 측정과 보정된 전망을 구분했던 것과 같은 기준입니다.
PHY를 없앤 이점은 계층 배치로 완성되는 조건
이 설계의 핵심은 메모리와 연산 다이를 함께 설계해 PHY 전송을 없앤 데 있습니다. 논문이 제시한 0.37pJ/bit와 2.4pJ/bit의 6.5× 차이는 기존 인터페이스가 소비하던 에너지를 수치로 보여 줍니다. 다만 d-Matrix가 이를 제품 경쟁력으로 연결하려면 소프트웨어, 공급망, 칩 간 인터커넥트까지 함께 입증해야 합니다. 메모리 업체들도 베이스 다이에 로직을 넣고 근메모리 연산을 검토하고 있으므로 방향 자체는 분명합니다. HBF가 저비용 대용량 계층을 추가하고 Raptor가 최고 대역폭 계층을 확장한다면, HBM은 두 계층 사이에서 역할이 다시 정해질 수 있습니다. 결국 시스템 효율은 어떤 데이터를 어느 계층에 둘지 결정하는 소프트웨어에 달려 있습니다.
PHY 비용은 열과 수율의 문제로 바뀌는 과정
직접 본딩은 기존 DRAM 인터페이스 경로를 줄이지만 연산과 메모리의 제조·운영을 더 강하게 묶습니다. 불량 다이, 본딩 결함, 열 집중이 전체 스택의 가치를 낮출 수 있으므로 성공한 패키지 하나의 성능보다 양품 다이 수율과 본딩 뒤 회수 가능한 용량을 봐야 합니다.
로직은 높은 전력 밀도와 클럭을 원하고 DRAM은 낮은 온도에서 보존과 신뢰성이 유리합니다. 가까운 배치는 배선을 줄이는 대신 온도를 결합합니다. 지속 추론에서 로직과 메모리 온도, 출력 제한, 유지 대역폭을 함께 측정해야 짧은 최고값을 운영 성능으로 오해하지 않습니다. 예비 영역, 비활성 타일, 등급화로 일부 결함을 회수할 수 있지만 판매 용량과 처리량이 달라지므로 소프트웨어가 보는 구성도 밝혀야 합니다.
용량은 모델 경계에서 계산해야 할 이유
32 GB가 가까이 있다는 사실만으로 어느 모델이 들어가고 얼마나 빨라지는지 알 수 없습니다. 가중치 정밀도, KV 캐시 형식, 배치 크기, 문맥 길이, 임시 버퍼가 같은 용량을 나눠 씁니다. 작업마다 가중치, 동적 상태, 작업 공간, 남은 여유를 구분해야 합니다.
모델이 한 패키지에 들어가면 외부 통신을 피하지만 여러 패키지로 나뉘는 순간 패브릭과 병렬화가 다시 병목이 됩니다. 로컬 대역폭과 전체 시스템 처리량을 분리하고, 정밀도와 품질을 맞춰 비교해야 패키지의 바이트와 알고리즘이 줄인 바이트를 구분할 수 있습니다.
초기 실리콘 다음에 필요한 자격 검증
초기 실리콘은 본딩 구조가 실제로 동작함을 보여 줍니다. 제품 주장은 여러 샘플의 지속 추론, 열 반복, 메모리 오류, 본딩 신뢰성, 성능 편차와 소프트웨어 복구를 확인한 뒤에 가능합니다. 일반 가속기와 외부 메모리, 한 패키지에 맞는 모델, 여러 패키지가 필요한 모델을 나눠 비교하면 3D 메모리, 연산 구조, 스케일아웃 비용의 기여를 분리할 수 있습니다.
Raptor는 메모리 인터페이스의 경계를 바꿀 수 있다는 근거입니다. PHY 에너지와 지연을 패키지 설계 문제로 옮겼으며 반복적인 가중치와 상태 접근이 많은 생성 추론에 의미가 있습니다. 수율, 지속 열, 신뢰성, 소프트웨어, 다중 패키지 확장이 붙어야 초기 실리콘 결과가 플랫폼 근거로 완성됩니다.
출처와 저작권 안내
이 글은 Silicon & Systems가 작성한 편집 요약입니다. 핵심 기술 원문은 Nair 등의 ISCA 2026 논문이며, Hot Chips 발표와 회사의 공개 자료에서 제품 및 패키징 맥락을 보충했습니다. 구조, 평가 결과, 한계를 모두 우리 표현으로 다시 썼습니다. 원문의 문장, 표, 도판, 슬라이드는 재수록하지 않았고 이 페이지의 도판은 모두 이 글을 위해 새로 만들었습니다. 학회 논문의 저작권은 (c) IEEE 2026, 발표와 회사 자료의 저작권은 (c) d-Matrix, Inc. 2026에 있습니다.