장문맥 서빙 시스템은 캐시 적중을 기록하고도 접두부를 다시 계산할 수 있습니다. 요청한 KV 블록이 CPU 메모리에 있더라도 새 토큰의 프리필 연산보다 적재 시간이 길면 전송을 가릴 수 없습니다. 첫 번째 캐시 미스가 끝나기 전에 여러 요청이 같은 접두부를 요구하면 모두 미스처럼 처리되기도 합니다. NVIDIA와 여러 대학이 OSDI 2026에서 발표한 Strata는 이 상황을 캐시 용량이 아니라 스케줄링의 문제로 봅니다[1].
Strata는 데이터 경로와 제어 경로를 함께 바꿉니다. GPU 보조 I/O가 잘게 흩어진 KV 페이지를 큰 전송으로 묶고, 호스트 메모리와 GPU HBM이 서로 다른 배치를 사용하도록 분리합니다. 캐시 인식 스케줄러는 배치를 만들기 전에 전송량과 연산량을 계산하고, 중복 계산을 미루며, 프리필이 데이터를 기다릴 때 디코드 작업을 넣습니다. 논문의 장문맥 시험에서 같은 첫 토큰 시간(TTFT)을 기준으로 vLLM-LMCache보다 최대 5배, TensorRT-LLM보다 최대 3.75배 높은 처리량을 기록했습니다. 재사용하는 문맥이 길고 I/O가 주 자원이 되는 조건에서 이득이 가장 컸습니다.
작은 페이지는 한 문제를 풀고 다른 문제를 만드는 방식
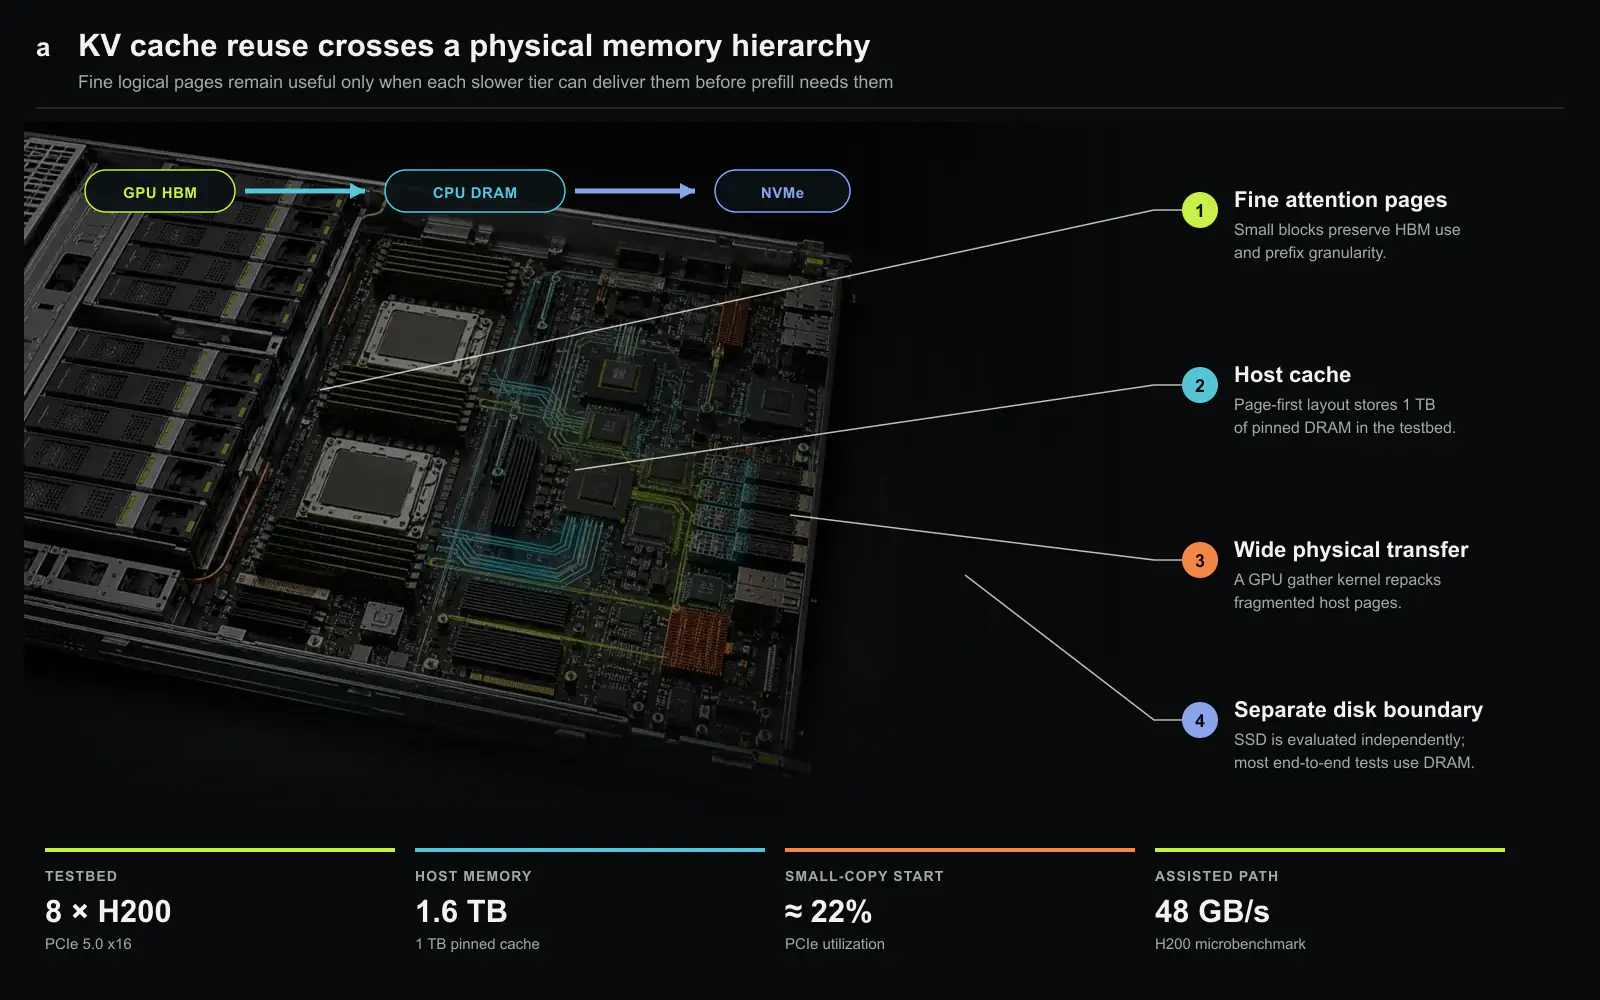
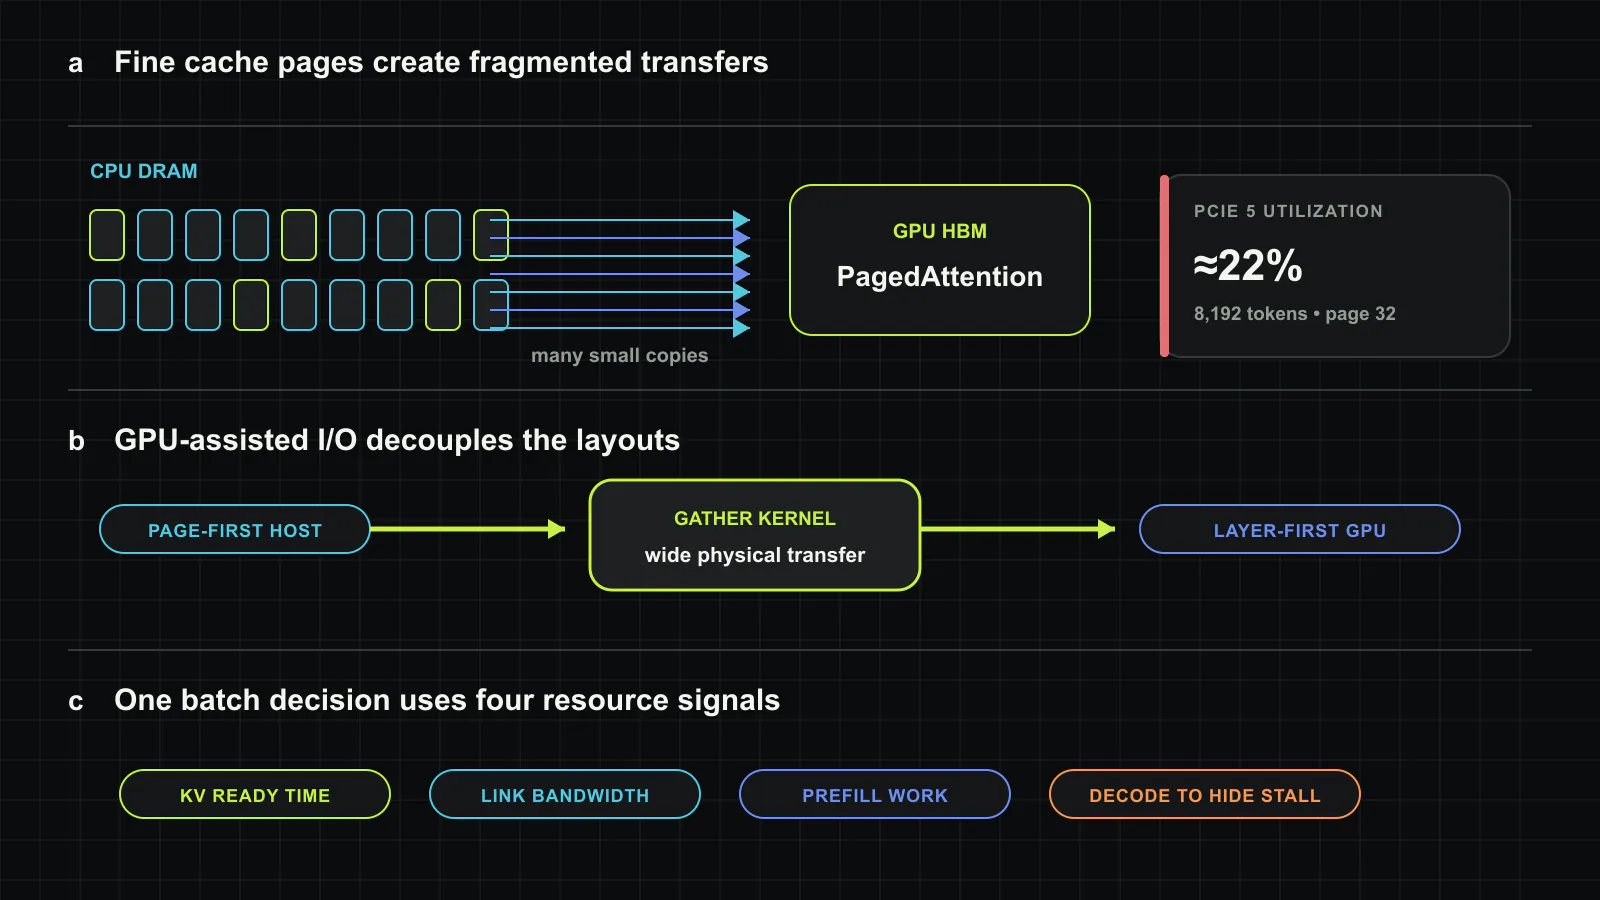
PagedAttention은 KV 상태를 작은 단위로 나누어 길이가 다른 요청들이 HBM의 큰 연속 영역을 미리 차지하지 않게 합니다. SGLang은 토큰 1개 페이지를 쓸 수 있고, 평가한 vLLM과 TensorRT-LLM의 계층형 구성은 32토큰 페이지를 사용했습니다. 작은 페이지는 할당과 재사용 단위를 세밀하게 만들지만 하나의 논리적 문맥을 수천 개의 불연속 전송으로 바꿉니다. Llama-3.1-8B에서 32토큰 페이지로 8,192토큰의 KV 상태를 옮길 때 PCIe 5.0 이론 대역폭의 약 22%만 사용했습니다. CPU와 GPU 사이 링크가 더 빠른 Grace Hopper에서는 소프트웨어가 너무 작은 전송을 반복해 이용률이 약 5%까지 내려갔습니다.
페이지를 키우는 것도 정답은 아닙니다. Mistral-24B와 ShareGPT 시험에서 페이지를 512토큰까지 늘리자 캐시 적중률이 낮아졌고 평균 TTFT는 최대 2배, P90 TTFT는 최대 2.9배 증가했습니다. 큰 페이지는 전송에는 유리하지만 요청이 재사용하지 않을 토큰까지 저장하고 가져옵니다. 런타임은 세밀한 캐시 단위와 큰 물리 전송을 동시에 확보해야 합니다.
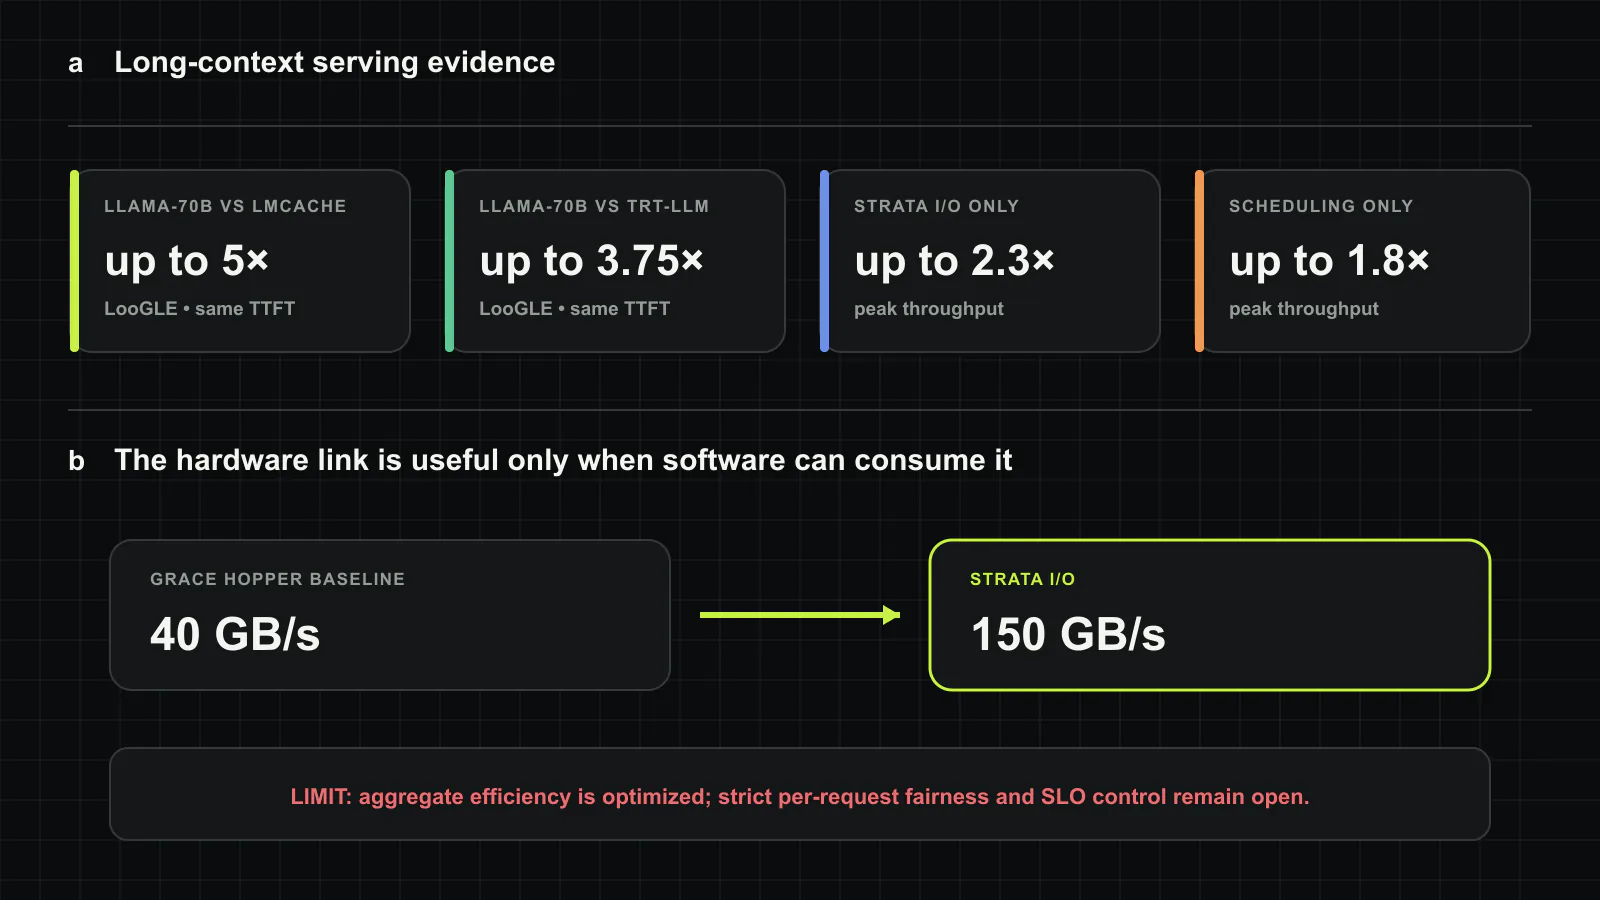
Strata는 GPU 커널의 많은 스레드로 작은 호스트 페이지를 모아 넓은 전송을 수행합니다. 호스트의 KV 상태는 페이지 우선 배치로 저장하면서, GPU에서는 어텐션 커널에 필요한 레이어 중심 배치를 유지합니다. 캐시 정책과 전송 모양을 분리한 것입니다. H200 미세 시험에서 GPU 보조 경로는 48 GB/s, CUDA 12.8의 일괄 복사 API는 38 GB/s를 기록했습니다. Grace Hopper에서는 Strata의 I/O 경로가 지속 전송 대역폭을 40 GB/s에서 150 GB/s로 높였습니다.
캐시가 언제 준비되는지 스케줄러가 알아야 할 이유
전송 효율만 높여도 모든 대기가 사라지지는 않습니다. 최적화한 I/O 경로를 사용한 뒤에도 보고된 프로파일에서 캐시 적재가 프리필 실행 시간의 최대 24%를 차지했습니다. Strata는 SGLang의 RadixTree 메타데이터를 메모리 계층까지 표시하도록 확장합니다. 스케줄러는 각 페이지의 위치, 적재 진행 여부, 다음 배치가 요구할 대역폭을 조회합니다.
이 상태에서 세 가지 정책이 나옵니다. 첫째, 같은 문맥을 공유하는 요청은 첫 캐시 미스가 해결될 때까지 조정해 접두부 중복 계산을 막습니다. Mooncake 도구 에이전트 트레이스에서는 요청의 38%가 1초 안에 도착한 다른 요청과 시스템 프롬프트를 제외하고도 6,000토큰 이상의 접두부를 공유했습니다. 둘째, 캐시 적재량이 큰 요청과 새 토큰 연산이 충분한 요청을 한 배치에 넣어 전송 시간을 가립니다. 셋째, 어떤 프리필 조합으로도 I/O를 가릴 수 없으면 디코드 배치를 실행해 GPU가 쉬지 않게 합니다.
정책마다 효과가 나는 구간이 다릅니다. 요청률이 낮으면 작은 배치 안에서 보완적인 작업을 고를 수 있으므로 스케줄링의 기여가 큽니다. 요청률이 높아지면 전송 경로가 병목이 됩니다. Qwen2.5-14B와 LooGLE의 요소별 시험에서 스케줄링만 적용하면 SGLang 계층형 기준선보다 최대 처리량이 1.8배, GPU 보조 I/O만 적용하면 2.3배가 됐습니다. 빠른 링크와 이를 모르는 스케줄러는 여전히 잘못된 배치를 만들기 때문에 둘을 함께 사용해야 합니다.
5배 결과는 긴 문맥을 반복해서 쓰는 조건의 값
주요 시험 장비는 H200 GPU 8개, Intel Sapphire Rapids CPU, DRAM 1.6 TB로 구성된 노드이며 GPU마다 PCIe 5.0 x16을 사용했습니다. Llama-3.1-8B, Qwen2.5-14B, Llama-3.1-70B를 LooGLE, NarrativeQA, ReviewMT, ShareGPT에서 평가했습니다. 8B와 14B는 GPU 1개, 70B는 텐서 병렬 GPU 4개를 사용했습니다. CPU 캐시에는 고정 메모리 1 TB를 할당했고, 데이터셋에 요청 시각이 없으므로 포아송 분포로 도착을 생성했습니다.
LooGLE에서 같은 TTFT를 기준으로 vLLM-LMCache보다 Llama-8B는 최대 2.6배, Qwen-14B는 2.1배, Llama-70B는 5배 높은 처리량을 보였습니다. TensorRT-LLM 계층형 캐시와 비교한 최댓값은 각각 1.9배, 1.9배, 3.75배입니다. ReviewMT는 디코드가 길어 전체 시간에서 프리필 I/O 비중이 작습니다. Llama-8B에서 두 기준선보다 2.3배 높았습니다. NarrativeQA의 CPU 캐시를 미리 채운 조건에서는 세 모델에서 vLLM-LMCache의 2.3~2.6배 처리량을 기록했습니다.
짧은 문맥의 ShareGPT에서는 기반 엔진 차이를 고려하면 비슷한 성능을 유지했습니다. 시험한 조건에서 뚜렷한 추가 비용이 없다는 의미이지 짧은 문맥이 Strata로 빨라진다는 뜻은 아닙니다. 같은 문맥이 바로 이어지면 계층형 오프로딩 자체가 필요하지 않습니다. 유사한 요청 사이의 거리가 멀면 지연 적중 방지 기능은 이득이 없습니다. 논문의 분해 실험에서도 각 메커니즘은 자신이 다루는 자원이 제약일 때만 작동했습니다.
빠른 복사는 GPU 자원을 사용하는 방식
GPU 보조 I/O는 모델 커널이 사용할 수 있는 스트리밍 멀티프로세서를 일부 점유합니다. Strata가 간섭을 제한하지만 교환 관계는 남습니다. 새 일괄 DMA API는 중요한 적재 경로에서는 느렸지만 SM과 경쟁하지 않으므로 비동기 GPU·CPU 백업 경로에 적합합니다. 운영 시스템은 한 복사 방식만 쓰기보다 방향에 따라 다른 방식을 선택할 수 있어야 합니다.
스케줄러는 전체 전송과 연산 효율을 최적화하며 엄격한 공정성을 보장하지 않습니다. 기아 방지 장치는 있지만 개별 요청을 다르게 취급해 요청별 SLO를 어길 수 있습니다. 디스크 프리페치는 일부만 다루고, 현재 설계는 표준 어텐션의 밀집 KV 캐시를 대상으로 하므로 희소 또는 선형 어텐션 상태는 별도 지원이 필요합니다. 대부분의 종단 간 비교도 CPU 메모리를 사용했습니다. 기준선의 디스크 지원이 제한적이어서 디스크 평가는 H20 별도 시험으로 분리했습니다.
서빙 용량에는 캐시 재사용 거리를 함께 적어야 할 이유
Strata를 적용하면 처리량 수치 옆에 적어야 할 조건이 늘어납니다. 모델, 문맥 길이, 페이지 크기, 호스트 메모리, CPU·GPU 링크, 캐시 재사용 거리, 요청률, 초기 캐시 상태, TTFT 목표가 모두 결과를 바꿉니다. 데이터가 프리필보다 늦게 도착하면 적중률 95%만으로 충분하지 않습니다. 스케줄러가 대역폭을 소비할 작업을 만들지 못하면 150 GB/s 링크도 충분하지 않습니다.
운영 원칙은 캐시 준비 상태를 일급 스케줄링 신호로 올리는 것입니다. HBM 용량은 로컬에 남길 범위를 정합니다. 호스트 용량은 재사용할 수 있는 범위를 정합니다. 전송 시간은 재사용과 재계산 중 어느 쪽이 빠른지를 정합니다. 요청 순서는 첫 적재가 다음 요청에 도움이 되는지를 정합니다. 앞의 두 값만 보여 주는 시스템은 저장된 문맥을 측정할 뿐 제시간에 전달할 수 있는 문맥을 측정하지 않습니다.
캐시 수용도 시간 문제
계층형 캐시는 용량을 늘리기 전에 어떤 접두부를 받아들일지 정해야 합니다. 호스트 DRAM에 들어가는 접두부를 모두 보존하면 명목 적중률은 오르지만 유효 적중률은 오히려 낮아질 수 있습니다. 큰 항목은 고정 메모리를 차지하고 다음 전송 작업을 만들며, 더 빨리 다시 쓰일 작은 접두부 여러 개를 밀어냅니다. 한 번 계산하기 비쌌다는 사실만으로는 충분하지 않습니다. 다음 요청이 현재 대기열에서 재계산보다 빠르게 가져올 수 있는 시점에 돌아오는지를 봐야 합니다.
이 판단은 캐시 정책과 스케줄링 정책을 연결합니다. 일반적인 LRU 정책은 마지막 접근 이후의 시간만 봅니다. Strata가 제공하는 상태에는 페이지 위치, 남은 바이트, 같은 데이터를 기다리는 요청 수, 전송을 가릴 연산량이 더해집니다. 운영자는 같은 정보를 사용해 HBM, 호스트 DRAM, NVMe 가운데 어느 계층에 둘지 결정할 수 있습니다. 승격은 다시 쓸 가능성뿐 아니라 제시간에 전달할 가능성이 높은 접두부를 우선해야 합니다.
여러 고객이 한 시스템을 쓰면 정책의 책임도 커집니다. 한 고객의 큰 접두부가 호스트 메모리를 채우고 다른 고객의 짧은 요청이 배치를 쉽게 만들 수 있습니다. 전체 처리량만 최적화하면 후자를 계속 우선할 수 있습니다. 따라서 운영 환경에는 Strata의 효율 메커니즘 위에 할당량이나 가중 SLO가 필요합니다. 준비 상태는 판단에 필요한 측정값을 주지만, 누구에게 이득을 배분할지는 별도 정책으로 정해야 합니다.
배포할 때는 세 종류의 지표를 분리해야 할 이유
첫째는 용량 지표입니다. 토큰당 KV 바이트, 접두부 길이 분포, 활성 디코드에 남길 HBM, 고정 호스트 메모리, 디스크로 내려가는 비율을 기록합니다. 둘째는 이동 지표입니다. 전송 크기별 유효 대역폭, 동시 복사의 간섭, 페이지 수집 비용, 적재 결정부터 GPU에서 사용할 수 있을 때까지의 시간을 기록합니다. 셋째는 서비스 지표입니다. 하나의 평균 대신 캐시 재사용 거리, 요청 등급, 초기 상태별 TTFT와 처리량을 기록합니다.
세 지표군을 나누면 원인을 잘못 짚는 일을 줄일 수 있습니다. 캐시를 키운 뒤 TTFT가 늘면 용량 지표만 보고 메모리를 더 붙이기 쉽습니다. 이동 지표는 작업 집합이 커지면서 재사용 거리가 늘고 적재가 겹쳤는지 보여 줄 수 있습니다. 서비스 지표는 큰 접두부를 가진 한 등급만 악화됐는지 구분합니다. 결과에 따라 캐시 수용 정책, 데이터 배치, 링크 예약, SLO 격리 중 필요한 조치가 달라집니다.
처음에는 관찰 모드로 도입하는 편이 안전합니다. 기존 스케줄러가 실제 배치를 수행하는 동안 새 정책은 배치와 준비 시간을 예측만 합니다. 예측한 대기와 실제 대기를 비교해 모델이 지속적으로 틀리는 작업을 찾을 수 있습니다. 이후 반복 접두부의 중복 계산 방지, 균형 배치, GPU 보조 복사 순으로 켜면 제어 정책의 오류와 GPU 자원 간섭을 분리해 확인할 수 있습니다.
이 구조는 KV 캐시 밖에도 적용되는 범위
Strata는 자원이 존재하지만 사용할 시점에는 준비되지 않은 시스템을 다룹니다. 원격 메모리, 분리형 가속기, 체크포인트 상태, 모델 가중치에도 같은 문제가 있습니다. 용량 지표는 바이트와 장치가 있다고 말합니다. 실행 시점 지표는 언제 쓸 수 있는지, 이동하는 동안 어떤 작업을 실행할 수 있는지까지 말해야 합니다.
앞으로의 서빙 API는 적중 여부만 알려 주기보다 준비 시간을 범위로 제공할 필요가 있습니다. 접두부마다 위치, 예상 전송 시간, 오차 범위, 허용 가능한 간섭을 스케줄러에 주면 대기, 재계산, 적재, 다른 배치 실행 가운데 하나를 고를 수 있습니다. 이 계약이 있으면 PCIe, 일관성 링크, 패브릭 연결 메모리도 같은 기준으로 비교할 수 있습니다.
Strata가 모든 시스템에 CPU 메모리 KV 계층이 필요하다고 증명한 것은 아닙니다. 장문맥에서는 메모리 계층과 요청 스케줄러를 따로 구매하거나 평가할 수 없다는 점을 보여 줍니다. 빠른 링크는 가능한 일정을 바꾸고, 더 나은 일정은 캐시 바이트의 가치를 바꿉니다. 최종 지표는 저장 용량이 아니라 접두부가 어텐션에 준비되는 전체 경로를 포함해 TTFT와 처리량 목표 안에서 완료한 요청 수여야 합니다.
출처와 저작권 안내
이 글은 Silicon & Systems가 작성한 편집 요약입니다. 논문의 작동 원리, 평가 조건, 결과, 한계를 우리 표현으로 다시 썼습니다. 원문의 문장, 표, 도판은 옮기지 않았으며, 본문의 도판 3개와 카드 이미지는 보고된 사실을 바탕으로 이 글을 위해 새로 만들었습니다. 저작권 (c) 2026 원저자. 원문은 USENIX OSDI 2026 페이지에서 공개되어 있습니다.