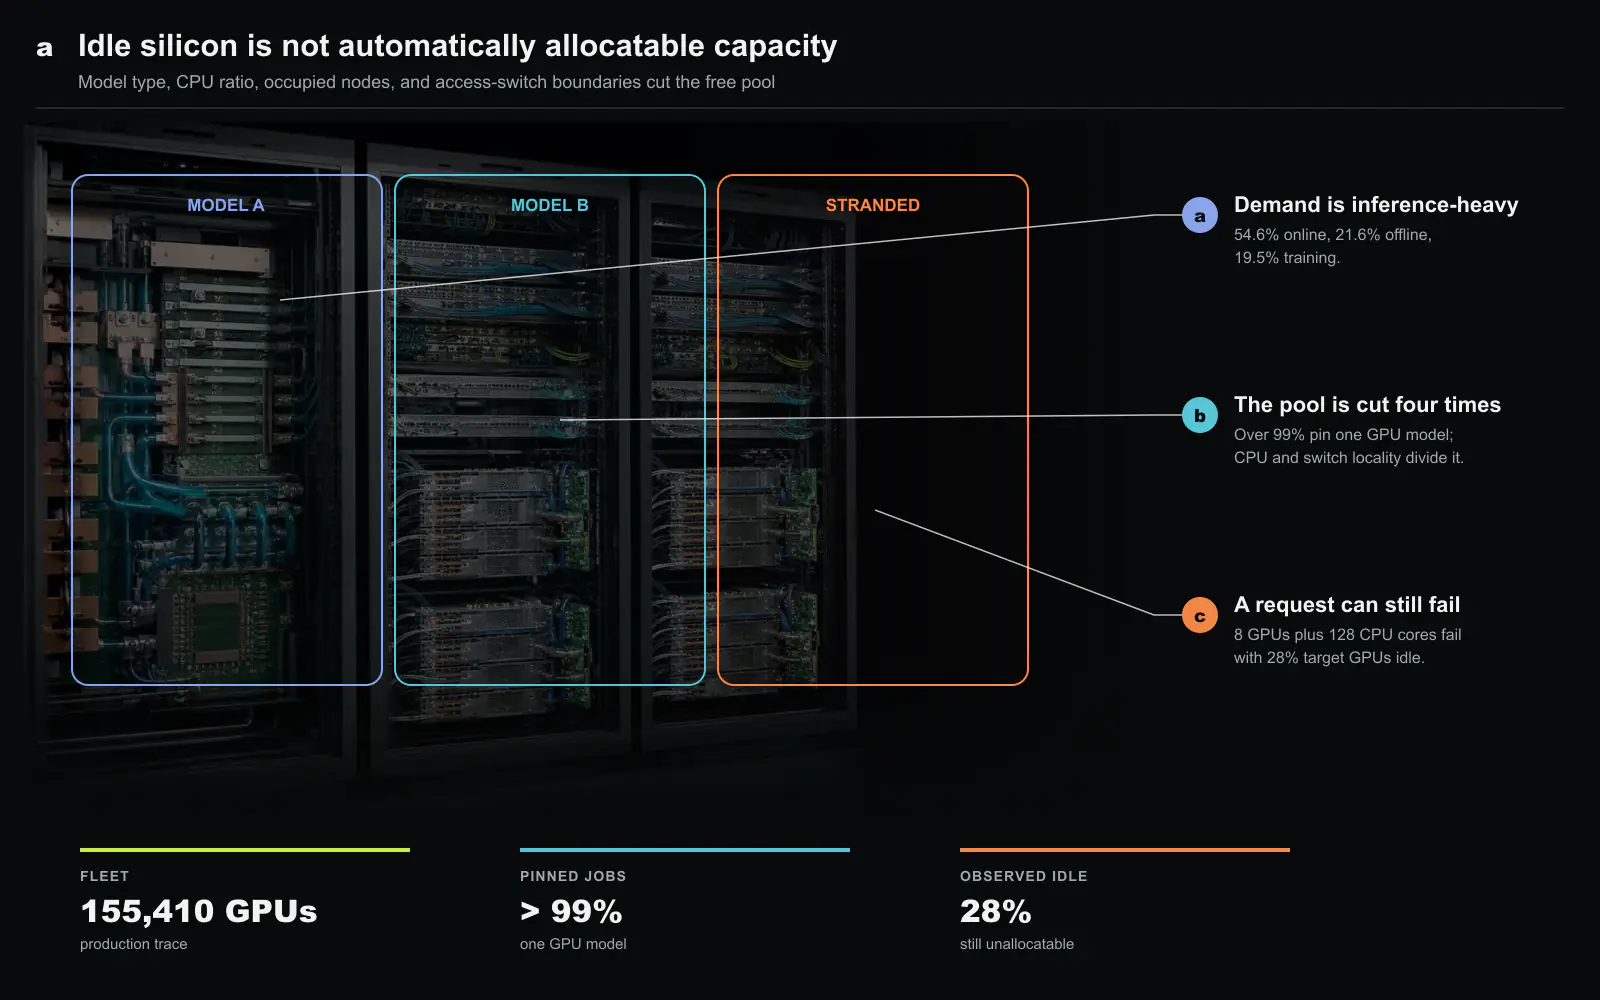
Alibaba의 ASI 플랫폼은 사내 81개 부서에 GPU 15만5,410장을 제공합니다. 이 정도면 파편화가 사라질 것 같지만, 6개월간의 실제 운영 추적 기록은 반대를 보여 줍니다[1]. 작업의 99% 이상이 특정 GPU 모델을 지정하고, 대규모 작업은 연속된 네트워크 위치를 요구하며, 호스트의 CPU 코어가 부족하면 비어 있는 GPU도 쓸 수 없습니다. GPU 8장과 CPU 코어 128개를 요청한 작업이 시작하지 못했을 때 대상 GPU의 유휴 비율은 최대 28%였습니다.
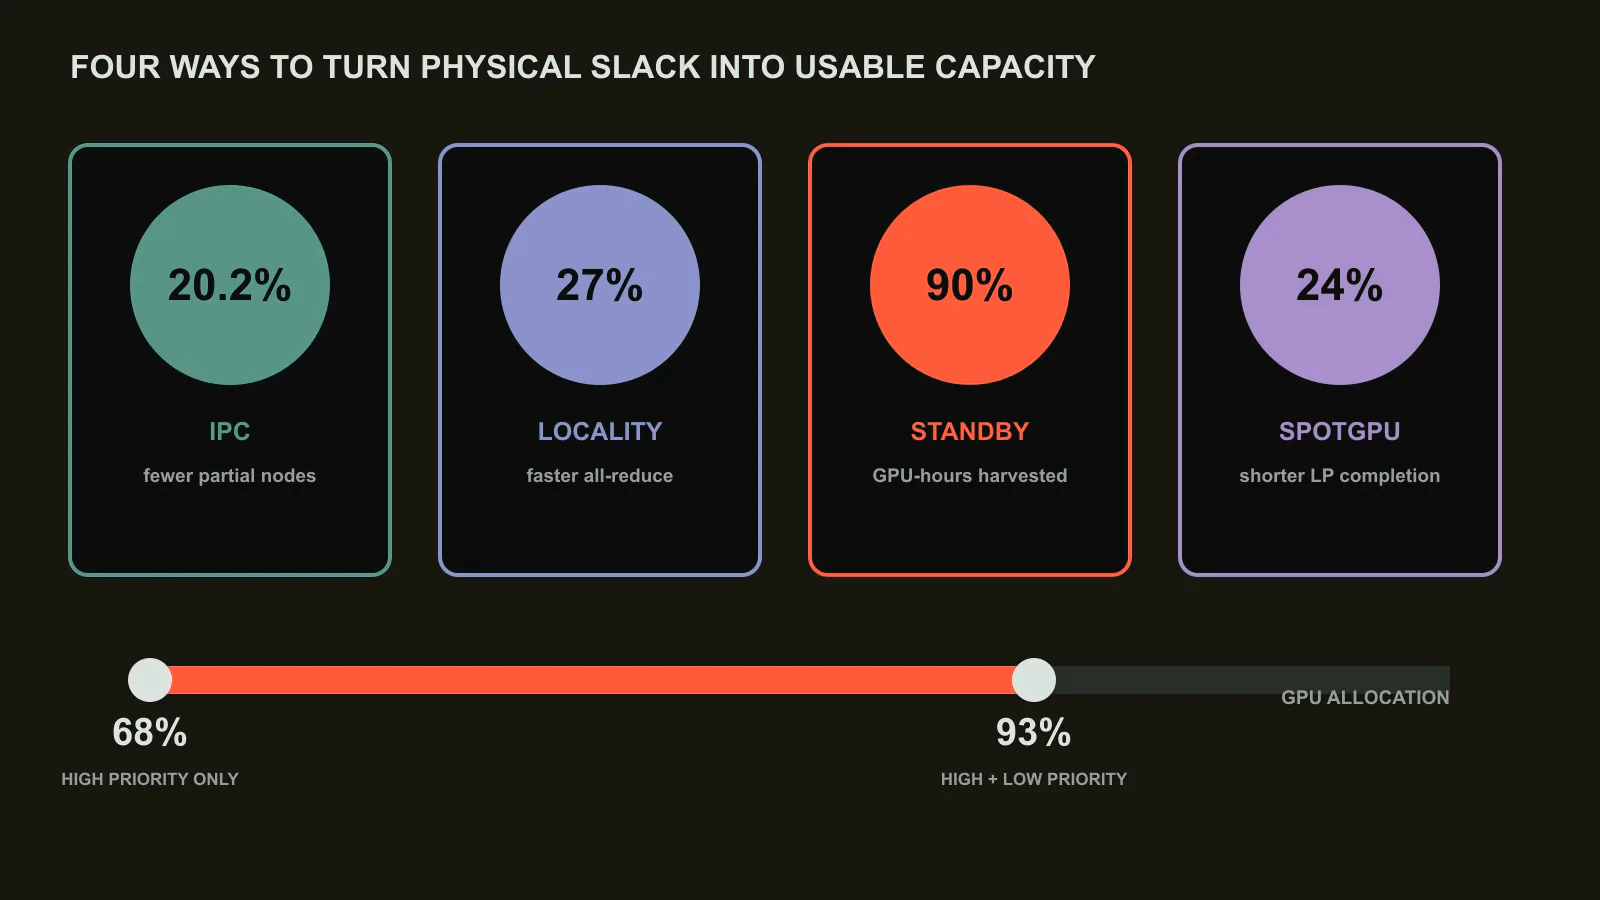
OSDI 2026 논문의 가치는 공유 장비군을 재고 목록이 아니라 운영체제로 설명하는 데 있습니다. 서로 다른 하드웨어, 높은 우선순위의 서비스, 심야 여유분, 애플리케이션 이식성이 모두 스케줄러 상태가 됩니다. Alibaba는 배치 복구, 네트워크 위치를 고려한 packing, 회수 가능한 작업, 장치별 소프트웨어 최적화를 결합합니다. 높은 우선순위와 낮은 우선순위 작업을 합친 GPU 할당률은 68%에서 93%로 오릅니다. 두 숫자의 차이는 GPU를 더 산 결과가 아닙니다. 사용 가능하다는 말의 정의를 더 정확히 만든 결과입니다.
하나의 장비군에 섞여 있는 서로 다른 작업
작업 구성은 과거 공개 추적 기록[2][3]과 다릅니다. 온라인 추론이 54.6%, 오프라인 추론이 21.6%, 학습이 19.5%, 개발이 3.4%입니다. 생성형 AI는 학습의 71%와 오프라인 추론의 98%를 차지하지만, 온라인 추론에서는 추천 모델이 여전히 63%입니다. 작업 실행시간 중앙값은 5시간입니다. 과거 Alibaba PAI 추적 기록의 23분, Microsoft Acme 추적 기록의 2분보다 깁니다. 잘못 놓은 배치가 오랫동안 남는 환경입니다.
우선순위는 장비군을 두 시장으로 나눕니다. 온라인 추론과 대부분의 학습은 우선순위가 높고, 오프라인 추론은 낮은 쪽을 채웁니다. 개발 작업도 엔지니어의 대기시간을 서비스 목표에 포함하므로 높은 우선순위를 받습니다. 스케줄링 지연시간 중앙값은 1초지만 높은 우선순위 작업의 90백분위는 101초입니다. 작업 실행시간의 90백분위는 약 24시간이므로 작은 파편화도 배치 주변에 누적됩니다.
하드웨어가 다양하다고 애플리케이션이 유연해지는 것은 아닙니다. 서로 다른 GPU 모델을 한 작업에서 함께 쓰는 경우는 1% 미만이고, 99% 이상이 한 모델을 정확히 지정합니다. fat-tree 네트워크는 모양 제약을 하나 더 만듭니다. access 스위치 하나가 GPU 8장짜리 노드 32~64개, 즉 GPU 256~512장을 연결합니다. 같은 스위치 아래에서 수행한 올리듀스는 스위치 경계를 넘을 때보다 최대 27% 빠릅니다. 따라서 GPU 256장 요청은 비어 있는 아무 장치 256개로 채울 수 없습니다. 같은 모델, 충분한 CPU 코어, 가능하면 하나의 네트워크 구역을 요구합니다.
서비스를 멈추지 않고 배치를 고치는 방식
Alibaba의 실행 중 압축(IPC)은 이미 실행 중인 할당 작업을 옮겨 파편화를 복구합니다. 전역 정수계획법은 더 나은 배열을 찾을 수 있지만 이 규모에서는 제때 답을 내지 못합니다. 정확한 최적해를 찾는 방식은 노드 25개에 5분, 100개에 이틀이 걸릴 수 있지만 실제 파티션은 500개 노드를 포함합니다. IPC는 클러스터를 나누고 깊이 3의 재귀식 연쇄 퇴거를 적용하며 최대 다섯 번 반복합니다.
연쇄 퇴거는 원하는 노드를 점유한 할당 작업을 옮기고, 그 이동 때문에 밀려난 할당 작업의 새 위치를 다시 찾습니다. 새 컨테이너를 먼저 실행한 뒤 기존 컨테이너를 해제하는 방식(make-before-break)이므로 높은 우선순위 서비스를 유지합니다. 결정은 2분 안에 끝나며 일부만 점유된 노드를 20.2% 줄입니다. 별도의 엔트로피 기반 배치 정책은 대규모 분산 작업을 더 적은 액세스 스위치 구역에 모아 다음 요청을 위한 연속 공간을 보존합니다.
이 복구 과정은 파편화의 원인이 바뀌었다는 점도 드러냅니다. 과거 GPU 클러스터는 분할 공유에 많은 관심을 썼지만 ASI 추적 기록에서는 영향이 미미합니다. 생성형 작업이 GPU 전체를 소비하면서, 주요 손실은 일부만 점유된 노드의 남은 GPU, 부족한 CPU 코어, 네트워크 위치에서 생깁니다. 스케줄링 정책도 과거의 병목이 아니라 현재 작업을 따라가야 합니다.
대기 자원을 두 우선순위가 공유하는 구조
높은 우선순위 수요에는 뚜렷한 일간 주기가 있으며 자정 무렵에는 대기 상태 GPU가 최대 1만 GPU 시간에 이릅니다. Alibaba는 두 메커니즘으로 이 시간을 회수합니다. 첫 번째는 온라인 추론 컨테이너를 따뜻한 상태로 유지하되 트래픽을 분리하고 대기 상태로 전환합니다. 수요가 돌아오면 퇴거에 평균 13초, 95백분위 48초가 걸리고 강제 종료가 필요한 비율은 5% 미만입니다. 낮은 우선순위 작업은 서비스를 처음부터 다시 띄우는 비용 없이 대기 GPU 시간의 90%를 사용합니다.
SpotGPU는 일반적인 선점 작업을 처리합니다. 가장 작거나 최근에 시작한 작업을 고르는 대신, GPU 수에 마지막 체크포인트 이후 시간을 곱해 잃을 계산량을 추정합니다. 재계산 비용이 가장 낮은 작업에서 자원을 회수합니다. 실제 운영 실험에서 높은 우선순위 성능은 유지하면서 낮은 우선순위 작업의 완료시간을 24% 줄였습니다. 두 우선순위 작업을 결합해 할당률이 68%에서 93%로 오른 배경입니다.
이식성은 더 어려운 여유분 회수 수단입니다. XPU-A로 표기한 대체 가속기는 특정 작업에서 H20보다 이론 성능이 높지만 초기 실제 성능은 H20의 80%에 불과했습니다. 커널과 프레임워크 최적화로 처리량을 최대 43% 높이고 프리필 커널을 1.58배 개선하자, 이 장치에 대한 높은 우선순위 수요가 2.5배 늘었습니다. 이종 장비군은 하드웨어 선택지마다 소프트웨어 예산이 필요합니다. 그렇지 않으면 스케줄러에는 용량이 보여도 애플리케이션은 그 장치를 요청하지 않습니다.
활용률은 하나의 숫자가 아닌 이유
남은 텔레메트리는 할당과 유효 연산을 같은 값으로 보면 안 된다고 경고합니다. 온라인 추론의 스트리밍 멀티프로세서 활용률 중앙값은 6%, 메모리 사용률은 30%입니다. 생성형 추론은 메모리 사용률이 94%지만 SM은 5%이고, 기존 DNN은 각각 약 20%와 6%입니다. 서로 보완적으로 보이는 작업을 함께 놓을 수 있지만 성능 격리와 메모리 압력 때문에 단순한 백분율 덧셈으로 끝나지 않습니다.
CPU 작업의 동시 배치는 더 잘 보이지 않는 간섭을 만듭니다. GPU 노드의 80%에서 CPU-only 작업이 CPU 사용량의 대부분을 차지합니다. 이때 학습 SM 활용률은 중앙값에서 10%, 90백분위에서 18% 낮아집니다. 스케줄러가 높은 GPU 할당률을 보고하는 동안 함께 놓은 CPU 작업이 완료한 학습 토큰을 줄일 수 있습니다.
논문은 전용 클러스터에서 수행하는 초대형 기반 모델 사전학습을 명시적으로 제외합니다. 따라서 모든 초대형 시스템에 결과를 그대로 적용해서는 안 됩니다. 대신 여러 세대의 가속기에서 추론, 개발, 학습이 경쟁하는 멀티테넌트 AI 클라우드의 넓은 중간 영역을 설명합니다. 이 환경에서는 물리적으로 비어 있는 GPU, 스케줄러가 배치할 수 있는 GPU, 실제 작업에 기여하는 GPU를 구분해야 합니다. 첫 번째 수치만으로 가용 용량을 설명하면 큐 지연과 배치 실패를 반영하지 못합니다.
이용률 보고에 필요한 세 분모
68%와 93%는 배정된 GPU의 비율이지 모델이 만든 유효 작업량이 아닙니다. 논문의 텔레메트리가 그 차이를 보여 줍니다. 추론 GPU는 메모리가 거의 찬 상태에서도 연산 장치를 조금만 사용할 수 있고, GPU가 계속 배정돼 있어도 같은 노드의 CPU 작업이 학습 SM 이용률을 낮출 수 있습니다. 따라서 전체 자원 보고는 물리 이용률, 스케줄링 가능 이용률, 생산 이용률을 나눠야 합니다. 첫째는 장비가 배정됐는지, 둘째는 남은 장비가 실제 요청 조건을 만족하는지, 셋째는 배정된 장비가 예상 속도로 승인 가능한 작업을 진행하는지 묻습니다.
분모마다 해결책이 다릅니다. 물리적으로 놀면 수요를 더 받아야 합니다. 요청 조건이 맞지 않아 배치할 수 없는 유휴 자원에는 자원 압축, 토폴로지 정리, CPU 균형, 소프트웨어 이식성이 필요합니다. 생산성이 낮으면 배치 묶음 구성, 동시 배치, 커널 개선, 다른 가속기를 검토해야 합니다. 이를 한 비율로 합치면 CPU 자원 파편화를 해결하려고 GPU를 더 사거나, 격리 여유가 없는 메모리 병목 서비스에 동시 배치를 강제하는 식의 잘못된 투자가 나옵니다.
네오클라우드가 고객에게 제시할 가용성도 전체 장비 수가 아니라 요청 조건을 기준으로 해야 합니다. GPU 종류와 수, CPU·메모리 비율, 네트워크 인접성, 시작 마감, 예상 실행 시간을 명시하고 이 조건의 작업이 제시간에 시작할 확률과 배치 뒤 유지하는 유효 처리량을 보고해야 합니다. Alibaba의 기록은 규모가 자원 파편화를 없애지 않음을 보여 줍니다. 맞춰야 할 자원 차원을 늘릴 뿐입니다. 명목 보유량을 예측 가능한 작업 시작으로 바꾸면서 그 비용을 낮은 실행 효율로 숨기지 않는 스케줄러가 실제 경쟁력을 만듭니다.
유휴 장치는 배치 가능성 검사를 통과해야 할 이유
이용률이 낮다고 바로 사용할 수 있는 GPU는 아닙니다. 끊어진 토폴로지의 일부이거나 지연 민감 서비스의 상태를 들고 있고, 대기 작업이 요구하는 메모리와 링크를 갖추지 못하거나 새 작업이 끝나기 전에 원래 고객이 돌아올 수 있습니다. 장치 종류, 메모리, 지역성, 건강 상태, 소프트웨어 이미지, 예상 빈 시간, 선점 비용, 최소 동시 장치 수를 모두 만족해야 실제 배치 가능한 용량입니다.
즉시 사용 가능, 회수 가능, 단편화로 쓸 수 없는 용량을 나눠 보고해야 합니다. 두 시간의 빈 구간은 평가 작업에는 충분해도 준비와 체크포인트가 긴 학습에는 부족할 수 있습니다. 수용 결정에는 빈 구간과 작업 시간의 예측 오차, 원래 서비스가 일찍 돌아올 때의 복구 경로가 필요합니다.
이동은 새 배치의 수명 안에 비용을 회수해야 할 이유
단편화된 배치를 정리해도 가중치와 상태 이동, 네트워크, 준비 시간이 듭니다. 이동 평가에는 바이트, 네트워크 계층별 트래픽, 중단 시간, 캐시 준비, 이동 뒤 성능, 주변 작업의 영향을 넣어야 합니다. 장치 수보다 새로 사용할 수 있게 된 연결된 그룹을 봐야 합니다. 떨어진 GPU 7개보다 같은 영역의 GPU 8개가 대기 작업에 더 가치 있을 수 있습니다.
목적지가 느리거나 건강 상태가 바뀔 때 돌아갈 수 있어야 하며, 최소 상주 시간과 이력 조건으로 반복 이동을 막아야 합니다. 이 기준이 있어야 배치 정리가 계속 흔드는 최적화가 아니라 회수 가능한 운영 조치가 됩니다.
여유 용량 공유에 필요한 우선순위 계약
원 소유자가 예측 가능하게 되찾을 수 있을 때만 낮은 우선순위 작업에 용량을 빌려줄 수 있습니다. 사전 통보, 체크포인트와 축출, 최대 중단, 잃은 작업의 보상을 정해야 합니다. GPU 메모리만 분리해도 CPU, 호스트 메모리, 스토리지, 패브릭의 간섭은 남을 수 있으므로 전체 경로를 시험해야 합니다.
설치, 건강·전원, 배치 가능, 사용 중인 GPU를 별도 분모로 표시하고, 최종 결과는 SLO 안에서 완료한 학습 단계나 추론 요청을 설치 가속기 시간과 비용으로 나눠야 합니다. 15만5천 장 운영 근거의 핵심은 바쁜 GPU 수가 아니라, 원래 서비스의 약속을 지키면서 단편과 불확실한 빈 시간을 실제 완료 작업으로 바꾼 양입니다.
출처와 저작권 안내
이 글은 Silicon & Systems가 작성한 편집 요약입니다. 아래 논문의 주장과 결과를 우리 표현으로 다시 썼습니다. 논문의 문장, 표, 도판은 옮기지 않았으며, 본문의 두 도판은 보고된 수치를 바탕으로 이 글을 위해 새로 만들었습니다. 원문은 OSDI 2026 회의록에서 공개돼 있습니다. 저작권 (c) 2026 원저자. 원문은 USENIX 논문 페이지에서 확인할 수 있습니다.